
文章目录
- 前言
- 零、论文基本信息
- 一、背景与问题:为什么“检索到相关片段”仍然不够
- 二、相关工作:SEEM 处于哪条演进线上
- 三、任务定义与方法总览
- 四、Episodic Event Frame:把一段对话变成一个事件
- 五、Associative Consolidation:把分散轮次融合成同一段经历
- 六、Graph Memory Layer:为事件检索提供事实入口
- 七、Hybrid Retrieval 与 Reverse Provenance Expansion
- 八、实验设置
- 九、主实验结果
- 十、消融、敏感性、增量构建与案例分析
- 十一、效率与工程代价
- 十二、与 Agent Memory 系列方法的横向比较
- 十三、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发
- 十四、局限性
- 十五、我的理解与启发
- 十六、总结
- 参考资料
前言
在前面的 Agent Memory 系列里,我们反复遇到一个矛盾:记忆系统既要把漫长交互压缩成可检索的结构,又不能在压缩时丢掉事件发展的来龙去脉。
纯向量检索把历史切成一个个 chunk。它很擅长找到“和问题长得像”的句子,却不保证这些句子能组成完整故事。知识图谱进一步保存了实体和关系,但一段经历并不只是若干静态事实。谁在什么时间、什么地点、为什么做了什么,以及前后两次对话是否属于同一事件,这些信息共同构成了可供推理的情境。
例如,用户先说“Caroline 推荐了一本关于跨性别女孩成长经历的书”,几轮之后才说“Melanie 读完了 Becoming Nicole”。查询“Melanie 读了 Caroline 推荐的哪本书”时,单个片段都不足以直接回答。系统必须先命中其中一个事实,再沿着事件关联把另一个片段带回来。
这正是 Structured Episodic Event Memory(SEEM) 试图解决的 scattered retrieval:检索结果各自相关,但彼此割裂,无法恢复完整叙事。
本文的唯一核心增量可以概括为:
SEEM 不再把“结构化记忆”停留在事实图谱,而是用带原文溯源指针的 Episodic Event Frame 把分散对话融合为事件;查询时再从命中的事实反向展开到完整事件及其原始证据,从而把碎片检索改造成叙事重建。
图记“事实之间有什么关系”,事件记忆则回答“事情如何发生”。SEEM 的价值不只是同时维护两种存储,而是用 provenance pointer 将二者和原文连成一条可回溯的证据链。
零、论文基本信息
- 论文名称: Structured Episodic Event Memory
- 发表平台: ACL 2026 Main Conference,Long Papers
- 代码仓库: 未公开(论文与 ACL Anthology 页面均未提供代码链接)
- 作者: Zhengxuan Lu、Dongfang Li、Yukun Shi、Beilun Wang、Longyue Wang、Baotian Hu
一、背景与问题:为什么“检索到相关片段”仍然不够
1. Flat RAG 的问题不是搜不到,而是搜回来的证据不成故事
传统 RAG 将交互历史表示为 passage 集合:
P = { p 1 , p 2 , … , p T } P=\{p_1,p_2,\ldots,p_T\} P={p1,p2,…,pT}
查询到来后,系统依据向量相似度取回若干 passage,再交给 LLM 生成回答。该范式隐含了一个假设:只要局部相关性足够高,若干局部片段就能拼成回答。
但长期对话经常违反这个假设。
- 同一事件可能横跨多个 session;
- 查询使用的表达与原文没有明显词面重叠;
- 时间、动机、动作和结果散落在不同轮次;
- 一个片段只描述结果,另一个片段才给出原因;
- 检索到的片段分别正确,组合后却缺少叙事连续性。
论文把这一现象称为 scattered retrieval。它不是典型的召回失败,而是一种“召回后的结构失败”。
2. Graph Memory 解决关系,却不天然等于 Episodic Memory
GraphRAG、HippoRAG 2 一类方法把实体和关系组织成图,能够从一个实体沿边传播到相关事实。相比 flat RAG,它们更适合多跳检索。
然而,知识图谱常把记忆压成 ( s u b j e c t , r e l a t i o n , o b j e c t ) (subject, relation, object) (subject,relation,object):
( Melanie , read , Becoming Nicole ) (\text{Melanie},\ \text{read},\ \text{Becoming Nicole}) (Melanie, read, Becoming Nicole)
这条事实是正确的,却没有保存“因为 Caroline 的推荐”“推荐发生在另一轮交互”“阅读是后续结果”等事件结构。静态关系图擅长回答“是什么”,不一定保存“如何发生”。
3. 摘要式记忆也可能把关键细节压没
Mem0 等系统会从对话中提取显著事实,A-MEM 则把记忆组织成可演化、可关联的 notes。这些方法改善了存储粒度,但如果摘要只留下“用户喜欢某本书”,原始时间、参与者、原因和动作仍可能被压缩掉。
因此 SEEM 提出两个要求:
- 结构化抽象: 记忆必须显式保留事件角色;
- 可逆压缩: 抽象记忆必须能回到原始 passage,而不是让摘要成为唯一真相。
二、相关工作:SEEM 处于哪条演进线上
1. Vector-based RAG:局部相关性优先
Dense Retrieval 以向量相似度作为主要信号,优势是简单、快速、扩展性好。问题是向量空间本身不表达事件结构,复杂多跳问题依赖“恰好把所有片段都召回”。
2. Structured Semantic Memory:把文本组织成图或层次摘要
GraphRAG 用实体—关系结构连接文本,RAPTOR 用递归摘要构建层次树,HippoRAG 2 结合知识图谱和 Personalized PageRank 做联想式检索。这条路线增强了全局传播能力,但高层主题、细粒度事实和事件进程可能混在同一结构中。
3. Episodic Memory:记住一次经历的情境
认知科学区分 semantic memory 与 episodic memory:前者保存一般事实,后者保存发生在特定时空中的经历。对 Agent 来说,“用户养了一只狗”是语义事实;“用户在 2022 年搬家后收养了狗,因为需要陪伴”则是一段情节。
SEEM 将二者拆成两层:Graph Memory Layer 保存稳定关系,Episodic Memory Layer 保存动态叙事。这种结构上的分工,是理解全文的关键。
三、任务定义与方法总览
给定历史交互 P P P 和当前问题 q q q,目标是生成与历史事实一致且与问题相关的回答 a a a。论文将它写成:
a = arg max a ′ P ( a ′ ∣ q , M s u b ; θ ) a=\arg\max_{a'}P(a'\mid q,M_{sub};\theta) a=arga′maxP(a′∣q,Msub;θ)
其中:
- M = Φ ( P ) M=\Phi(P) M=Φ(P) 是由原始历史构建的中间记忆;
- M s u b ⊆ M M_{sub}\subseteq M Msub⊆M 是与查询相关的记忆子集;
- θ \theta θ 是生成模型参数。
真正困难的不是最后一行生成公式,而是如何设计 M M M:既压缩长历史,又保留事实依赖、事件顺序和原文依据。
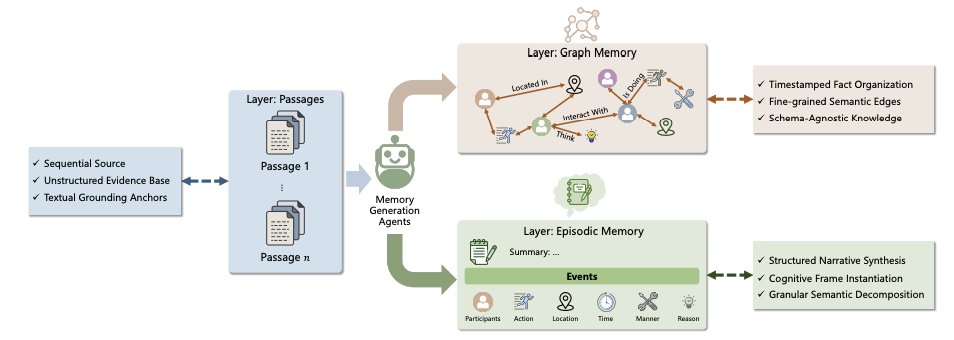
Figure 1:SEEM 分层记忆架构。 原始 passages 同时进入 Graph Memory Layer 与 Episodic Memory Layer,分别保存关系事实和事件叙事。
SEEM 的工作流可以分成写入与读取两部分。
写入阶段
- 将每个 passage 抽取为包含六类语义槽位的 Episodic Event Frame;
- 判断新 frame 与历史 frame 是否描述同一事件;
- 若属于同一事件,则融合属性与摘要,同时合并原文 provenance;
- 并行抽取带时间属性的关系四元组,构建 Graph Memory Layer。
读取阶段
- 从问题中抽取关系四元组,在图中找到 seed facts;
- 通过图传播找到初始 passages;
- 根据 passages 定位相关 EEF;
- 沿 EEF 的 provenance 反向展开,把同一事件的其他原文补回来;
- 将原文、事件 frame 和关系事实共同交给 LLM。
用一条链表示就是:
q → K t o p → P r e t → E r e t → P f i n a l → C → a q\rightarrow K_{top}\rightarrow P_{ret}\rightarrow E_{ret} \rightarrow P_{final}\rightarrow C\rightarrow a q→Ktop→Pret→Eret→Pfinal→C→a
四、Episodic Event Frame:把一段对话变成一个事件
1. 动机:chunk 是文本单位,EEF 是认知单位
按固定 token 长度切分得到的 chunk 只回答“这段文本在哪里断开”,并不回答“这里发生了几件事”。SEEM 因此以 frame semantics 和 Case Grammar 为依据,将每个 passage 转成事件中心表示。
2. EEF 的形式化表示
抽取 Agent F e x t F_{ext} Fext 将 passage p t p_t pt 转为:
e t = F e x t ( p t ; θ ) = ⟨ ρ t e m l , v s u m , { v p a r , v a c t , v t m p , v s p a , v c a u , v m a n } k = 1 N t ⟩ e_t=F_{ext}(p_t;\theta) =\left\langle \rho_t^{eml},v^{sum}, \left\{v^{par},v^{act},v^{tmp},v^{spa},v^{cau},v^{man}\right\}_{k=1}^{N_t} \right\rangle et=Fext(pt;θ)=⟨ρteml,vsum,{vpar,vact,vtmp,vspa,vcau,vman}k=1Nt⟩
其中:
- ρ t e m l \rho_t^{eml} ρteml:指向原始 passage 的 provenance pointer;
- v s u m v^{sum} vsum:事件摘要;
- v p a r v^{par} vpar:Participants,参与者;
- v a c t v^{act} vact:Action,动作;
- v t m p v^{tmp} vtmp:Time,时间;
- v s p a v^{spa} vspa:Location,地点;
- v c a u v^{cau} vcau:Causality,原因或目的;
- v m a n v^{man} vman:Manner,方式;
- N t N_t Nt:一个 passage 中抽出的事件数量。
这六个槽位不是越多越好。作者有意选择较小的通用 schema,希望在表达能力和抽取噪声之间平衡。
3. 一个直观例子
假设原文是:
2022 年 1 月 23 日,Joanna 问 Nate 已经拥有“它们”多久。Nate 回答说已经三年,而且它们给自己带来很多快乐。
EEF 不只生成一句摘要,还会拆出两个事件:
- Joanna 发起询问:参与者是 Joanna,动作是询问持有时长,时间是 2022-01-23,方式是口头询问;
- Nate 回答:参与者是 Nate,动作是说明已拥有三年,实际时间范围约为 2019-01 至 2022-01,原因是回应 Joanna。
这个表示比一条“owned for three years”事实更适合做时间推理,也比保存整个 chunk 更容易精准检索。
4. Provenance pointer 为什么是必要的
LLM 抽取并不可靠。若系统只保存 EEF,抽错的参与者或时间会成为永久记忆。 ρ t e m l \rho_t^{eml} ρteml 让结构化 frame 保持为“索引与解释层”,原文仍是最高可信证据。
这使 SEEM 的压缩是部分可逆的:摘要负责导航,原文负责裁决。
五、Associative Consolidation:把分散轮次融合成同一段经历
1. 动机:事件边界通常跨越对话轮次
用户的问题和回答、计划和执行、推荐和后续反馈,常分布在不同轮次。若每轮生成一个独立 frame,事件记忆仍会碎片化。
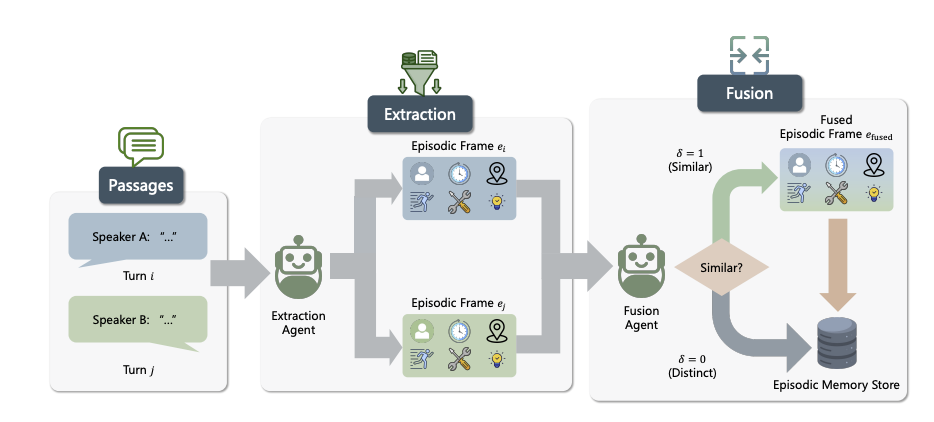
Figure 2:EEF 的联想式整合与融合。 新 frame 与最相关历史 frame 比较;属于同一事件时融合,否则作为独立事件写入。
2. 相似事件判定
新 frame e t e_t et 生成后,系统先检索最相关的历史 frame e p r e v e_{prev} eprev,再由判断 Agent 决定两者是否描述同一事件:
δ t = F j u d g e ( e t , e p r e v ) \delta_t=F_{judge}(e_t,e_{prev}) δt=Fjudge(et,eprev)
- δ t = 1 \delta_t=1 δt=1:两者属于同一 occurrence,进入融合;
- δ t = 0 \delta_t=0 δt=0:两者是不同事件,分别保存。
这里的“相似”并不等于主题相似。论文附录中的 prompt 特别要求保守合并:计划与执行即使相关,也属于顺序事件,不能当成同一次发生。
3. Fusion 的输出
若 δ t = 1 \delta_t=1 δt=1, F f u s e F_{fuse} Ffuse 会:
- 对齐参与者和指代;
- 合并互补属性;
- 依据原始 passages 处理冲突;
- 重写一个体现进展或因果关系的摘要;
- 将 provenance 更新为两侧来源的并集。
因此融合后的 frame 不是“两个摘要拼接”,而是一个能够入口多个原始轮次的事件节点:
ρ e m l ( e f u s e d ) = h o e m l ( e t ) ∪ ρ e m l ( e p r e v ) \rho^{eml}(e_{fused})= ho^{eml}(e_t)\cup\rho^{eml}(e_{prev}) ρeml(efused)=hoeml(et)∪ρeml(eprev)
4. 这一步的风险
融合同时带来收益与风险。漏合并会保留碎片;错合并则会把不同事件永久绑定,形成比检索遗漏更难发现的结构污染。论文的保守 prompt 和原文优先策略能够降低风险,但没有从机制上消除它。
六、Graph Memory Layer:为事件检索提供事实入口
1. 关系四元组
对每个 passage p t p_t pt,SEEM 抽取:
K t = { ( s , r , o , τ ) ∣ s , o ∈ V , r ∈ R , τ ∈ T } K_t=\{(s,r,o,\tau)\mid s,o\in V,r\in R,\tau\in\mathcal{T}\} Kt={(s,r,o,τ)∣s,o∈V,r∈R,τ∈T}
其中 s s s、 o o o 为主体和客体, r r r 为关系, τ \tau τ 为事实的时间有效性。相比普通三元组,多出的时间维度使图能够表达“关系何时成立”。
每个图节点同样保留 ρ t g m l \rho_t^{gml} ρtgml,指回来源 passage。向量相似度超过阈值的节点会合并,以处理别名与词形变化。
2. 图层与事件层不是重复存一遍
论文在 LoCoMo 的 1,282 个有效检索对上比较 GML 四元组与 EML frame 的向量相似度,平均只有 0.46。这说明两层虽然来自同一段对话,却捕获了不同语义:
- GML 偏实体、关系和静态约束;
- EML 偏动作、时间、原因和叙事进程。
这项分析支持“双层互补”,但并不能证明 0.46 就是最优重叠程度;它只是一个描述性证据。
七、Hybrid Retrieval 与 Reverse Provenance Expansion
1. 从查询进入图谱
SEEM 先从问题 q q q 抽取查询四元组,用共享编码器计算其与 GML facts 的余弦相似度,得到初始事实集合 K t o p K_{top} Ktop。
随后以 K t o p K_{top} Ktop 为 seed 执行图传播,论文引用的是 Personalized PageRank 思路。传播后的高相关节点通过 provenance 找到初始 passages:
K t o p → graph propagation P r e t K_{top}\xrightarrow{\text{graph propagation}}P_{ret} Ktopgraph propagationPret
这一步负责“发现线索”。它利用关系图跨越词面差异,找到非连续历史中的入口。
2. Reverse Provenance Expansion:从碎片回到完整事件
只取 P r e t P_{ret} Pret 仍然会缺上下文。SEEM 先找出这些 passage 对应的事件 frame:
E r e t = { Ψ ( p ) ∣ p ∈ P r e t } E_{ret}=\{\Psi(p)\mid p\in P_{ret}\} Eret={Ψ(p)∣p∈Pret}
Ψ : P → E \Psi:P\rightarrow E Ψ:P→E 表示 passage 到 EEF 的映射。
接着沿每个 frame 聚合的 provenance 反向展开:
P f i n a l = P r e t ∪ ⋃ e ∈ E r e t ρ e m l ( e ) P_{final}=P_{ret}\cup\bigcup_{e\in E_{ret}}\rho^{eml}(e) Pfinal=Pret∪e∈Eret⋃ρeml(e)
这就是全文最关键的一步。若某个命中的 passage 属于一个融合事件,那么同一事件的其他原文即使与查询不相似,也会被一起带回。
它与邻近窗口扩展不同。邻近窗口依赖物理位置,而 RPE 依赖事件归属;相关内容可以跨 session、跨数十轮对话。
3. Context Synthesis
最终上下文由三部分组成:
C = Serialize ( P f i n a l , E r e t , K t o p ) C=\operatorname{Serialize}(P_{final},E_{ret},K_{top}) C=Serialize(Pfinal,Eret,Ktop)
- P f i n a l P_{final} Pfinal:最高可信的原始证据;
- E r e t E_{ret} Eret:事件级摘要和六类属性;
- K t o p K_{top} Ktop:紧凑的事实约束。
生成模型执行:
a = arg max a ′ ∏ i = 1 ∣ a ′ ∣ P ( y i ∣ y < i , q , C ; θ ) a=\arg\max_{a'}\prod_{i=1}^{|a'|}P(y_i\mid y_{<i},q,C;\theta) a=arga′maxi=1∏∣a′∣P(yi∣y<i,q,C;θ)
论文的推理 prompt 明确规定证据优先级:原始 passage 最高;EEF 与 facts 作为高信号提示;若结构化记忆与原文冲突,应信任原文。这一设计将 provenance 从“可解释性装饰”变成了推理协议的一部分。
八、实验设置
1. 数据集
LoCoMo
LoCoMo 是超长开放域对话记忆基准,单段对话最多包含 32 个 session,平均约 16K tokens。论文使用 1,986 个问答样本,覆盖 multi-hop、temporal、open-domain、single-hop 和 adversarial 五类问题。
LongMemEval
LongMemEval 包含 500 个人工整理问题,考察单 session 用户信息、助手信息、偏好、多 session 推理、时间推理和知识更新。
2. Baselines
- Dense Retrieval:KaLM-Embedding-V2.5、NV-Embed-v2;
- Memory Framework:Mem0、A-MEM、HippoRAG 2。
3. 模型与检索预算
主实验统一使用 Qwen3-Next-80B-A3B-Instruct 完成抽取和回答;附加实验使用 Pangu-Embedded-7B 与 GPT-OSS-120B。
- Dense RAG:top-5 原始消息;
- Mem0、A-MEM:top-10 memory chunks;
- HippoRAG 2:top-5 session chunks;
- SEEM:top-5 passages 及相关 EEF,并限制 ∣ P f i n a l ∣ |P_{final}| ∣Pfinal∣ 不超过初始预算的两倍。
这使 SEEM 的上下文可能比 top-5 baseline 更长,但作者通过两倍上限控制无边界扩张。它仍不是严格等 token 的成本对比,这是解读结果时需要保留的边界。
4. 指标
LoCoMo 使用 BLEU-1、token-level F1 与 LLM-as-a-Judge(DeepSeek-V3.2);LongMemEval 按官方协议报告答案准确率。
九、主实验结果
1. SEEM 在两个基准上均取得最佳总成绩
Method LoCoMo BLEU-1 LoCoMo F1 LoCoMo J LongMemEval Acc. KaLM-Embedding-V2.5 44.4 47.9 64.6 55.6 NV-Embed-v2 53.0 57.9 74.7 58.4 Mem0 34.2 43.3 54.1 56.7 A-MEM 45.7 44.6 61.9 55.2 HippoRAG 2 53.8 58.3 76.2 60.6 SEEM 56.1 61.1 78.0 65.0 \begin{array}{l|ccc|c} \hline \text{Method} & \text{LoCoMo BLEU-1} & \text{LoCoMo F1} & \text{LoCoMo J} & \text{LongMemEval Acc.}\\ \hline \text{KaLM-Embedding-V2.5} & 44.4 & 47.9 & 64.6 & 55.6\\ \text{NV-Embed-v2} & 53.0 & 57.9 & 74.7 & 58.4\\ \text{Mem0} & 34.2 & 43.3 & 54.1 & 56.7\\ \text{A-MEM} & 45.7 & 44.6 & 61.9 & 55.2\\ \text{HippoRAG 2} & 53.8 & 58.3 & 76.2 & 60.6\\ \mathbf{\text{SEEM}} & \mathbf{56.1} & \mathbf{61.1} & \mathbf{78.0} & \mathbf{65.0}\\ \hline \end{array} MethodKaLM-Embedding-V2.5NV-Embed-v2Mem0A-MEMHippoRAG 2SEEMLoCoMo BLEU-144.453.034.245.753.856.1LoCoMo F147.957.943.344.658.361.1LoCoMo J64.674.754.161.976.278.0LongMemEval Acc.55.658.456.755.260.665.0
Table 1:LoCoMo 与 LongMemEval 主实验。 SEEM 在四项指标上均优于所有对比方法。
与最强 dense retriever NV-Embed-v2 相比,SEEM 的 LoCoMo F1 提高 3.2 分,Judge 提高 3.3 分。与最接近的结构化 baseline HippoRAG 2 相比,F1 提高 2.8 分,Judge 提高 1.8 分,LongMemEval 准确率提高 4.4 个百分点。
这里最重要的不是 BLEU 的领先,而是 Judge 与 LongMemEval 准确率的提升更稳定。这与论文的主张一致:SEEM 的优势主要来自重建语义和叙事逻辑,而非仅提高词面重合。
2. 分类结果揭示了真正的优势和反例
Method Multi-hop Temporal Open-domain Single-hop Adversarial A-MEM 29.4 39.7 15.0 37.6 78.3 HippoRAG 2 31.9 53.4 34.7 54.2 94.2 SEEM 32.3 54.6 26.6 58.2 96.9 \begin{array}{l|ccccc} \hline \text{Method} & \text{Multi-hop} & \text{Temporal} & \text{Open-domain} & \text{Single-hop} & \text{Adversarial}\\ \hline \text{A-MEM} & 29.4 & 39.7 & 15.0 & 37.6 & 78.3\\ \text{HippoRAG 2} & 31.9 & 53.4 & \mathbf{34.7} & 54.2 & 94.2\\ \mathbf{\text{SEEM}} & \mathbf{32.3} & \mathbf{54.6} & 26.6 & \mathbf{58.2} & \mathbf{96.9}\\ \hline \end{array} MethodA-MEMHippoRAG 2SEEMMulti-hop29.431.932.3Temporal39.753.454.6Open-domain15.034.726.6Single-hop37.654.258.2Adversarial78.394.296.9
Table 2:LoCoMo 各问题类型的 F1。 SEEM 在五类问题中的四类领先,但在 open-domain 上落后 HippoRAG 2。
时间问题从 HippoRAG 2 的 53.4 提升到 54.6,说明显式时间槽位有帮助;adversarial 达到 96.9,说明回到原文能够抵抗部分干扰信息。
但 open-domain 从 HippoRAG 2 的 34.7 降到 26.6,差距达到 8.1 分。这是论文最重要的负面结果。对于缺少明确叙事锚点、更多依赖外部常识或静态实体关系的问题,事件展开不仅未必有益,还可能引入额外上下文。SEEM 不是普遍替代图检索的方案,它更适合具有事件链的长期交互。
3. 小模型实验:结构可以部分补偿参数规模
在 Pangu-Embedded-7B backbone 下,SEEM 在 LoCoMo 的 F1 为 48.60、EM 为 30.80、Judge 为 56.11;LongMemEval F1 为 45.50、EM 为 29.60、Accuracy 为 60.80,均高于同设置下的 baselines。
不过这不能推出“7B 模型等价于大模型”。它只能说明 SEEM 的相对收益没有完全依赖 80B 主干,结构化上下文对受限模型仍然有效。
4. 跨模型结果
GPT-OSS-120B Backbone BLEU-1 F1 J KaLM-Embedding-V2.5 38.7 42.8 63.2 NV-Embed-v2 44.1 49.2 75.5 A-MEM 42.4 47.3 63.0 HippoRAG 2 44.6 50.2 73.6 SEEM 50.7 55.7 77.1 \begin{array}{l|ccc} \hline \text{GPT-OSS-120B Backbone} & \text{BLEU-1} & \text{F1} & \text{J}\\ \hline \text{KaLM-Embedding-V2.5} & 38.7 & 42.8 & 63.2\\ \text{NV-Embed-v2} & 44.1 & 49.2 & 75.5\\ \text{A-MEM} & 42.4 & 47.3 & 63.0\\ \text{HippoRAG 2} & 44.6 & 50.2 & 73.6\\ \mathbf{\text{SEEM}} & \mathbf{50.7} & \mathbf{55.7} & \mathbf{77.1}\\ \hline \end{array} GPT-OSS-120B BackboneKaLM-Embedding-V2.5NV-Embed-v2A-MEMHippoRAG 2SEEMBLEU-138.744.142.444.650.7F142.849.247.350.255.7J63.275.563.073.677.1
Table 6:GPT-OSS-120B 上的跨模型验证。 更换 backbone 后,SEEM 仍保持领先。
这组结果支持“收益来自记忆架构而非单一模型搭配”。但实验只覆盖三个 backbone,仍不足以证明对所有模型族和部署规模都 model-agnostic。
十、消融、敏感性、增量构建与案例分析
1. 消融:EEF 是影响最大的单项组件
Configuration BLEU-1 F1 J SEEM Full 56.1 61.1 78.0 w/o Fact Provisioning K t o p 55.2 60.4 77.7 w/o Relational Propagation 54.5 59.6 76.3 w/o RPE 55.1 60.2 77.1 w/o EEF E r e t 53.5 58.5 75.0 \begin{array}{l|ccc} \hline \text{Configuration} & \text{BLEU-1} & \text{F1} & \text{J}\\ \hline \text{SEEM Full} & 56.1 & 61.1 & 78.0\\ \text{w/o Fact Provisioning }K_{top} & 55.2 & 60.4 & 77.7\\ \text{w/o Relational Propagation} & 54.5 & 59.6 & 76.3\\ \text{w/o RPE} & 55.1 & 60.2 & 77.1\\ \text{w/o EEF }E_{ret} & 53.5 & 58.5 & 75.0\\ \hline \end{array} ConfigurationSEEM Fullw/o Fact Provisioning Ktopw/o Relational Propagationw/o RPEw/o EEF EretBLEU-156.155.254.555.153.5F161.160.459.660.258.5J78.077.776.377.175.0
Table 4:SEEM 关键模块消融。 删除 EEF 带来的下降最大,关系传播与 RPE 也分别贡献全局定位和上下文补全能力。
去掉 EEF 后,F1 下降 2.6 分,Judge 下降 3.0 分,是最大跌幅。这表明性能并非只来自“图检索后多放几段原文”,事件结构本身提供了高密度推理提示。
去掉 RPE 后 F1 降至 60.2、Judge 降至 77.1,证明反向展开确实缓解碎片证据。下降幅度没有 EEF 大,也说明 EEF 既承担扩展索引,又直接参与上下文推理。
去掉 Fact Provisioning 的影响最小:Judge 只下降 0.3。图中 facts 更像显式约束和入口,而不是最终收益的唯一来源。
2. 初始检索量敏感性
当 ∣ P r e t ∣ |P_{ret}| ∣Pret∣ 从 3 增至 10 时,F1 大致从 0.57 上升到 0.61,Judge 从 0.73 上升到 0.81。作者报告 F1 相对提升 5.9%。
传统 RAG 常因加入噪声而在较大 k k k 下退化,SEEM 在这一范围内没有出现相同趋势。可能原因是 EEF 和关系 facts 帮助模型重新组织了扩大的证据集。
但该实验只扫到 10,不能据此推断上下文继续增长仍会单调变好,也没有报告 token 开销随 k k k 的变化。
3. 增量构建:更接近真实 Agent 的写入方式
Mode BLEU-1 F1 J Batch 56.1 61.1 78.0 Incremental 55.6 60.6 77.6 \begin{array}{l|ccc} \hline \text{Mode} & \text{BLEU-1} & \text{F1} & \text{J}\\ \hline \text{Batch} & 56.1 & 61.1 & 78.0\\ \text{Incremental} & 55.6 & 60.6 & 77.6\\ \hline \end{array} ModeBatchIncrementalBLEU-156.155.6F161.160.6J78.077.6
Table 9:批量与增量记忆构建。 将交互按时间拆成四段顺序写入后,三项指标仅小幅下降。
增量模式更符合持续运行的 Agent。F1 仅下降 0.5,说明 associative fusion 在分批输入下仍能维持较稳定的结构。不过实验只模拟四段写入,没有测试数月级漂移、反复改写或大规模删除。
4. 融合带来的压缩
论文选取一个包含 629 个 passages 的 LoCoMo narrative partition,最终形成 478 个 episodic frames,整合比为 1.32:1。其中 371 个 frame 只对应一个 passage,107 个 frame 合并了两个及以上 passages。
这说明融合确实减少了记忆单元,但压缩率并不激进。SEEM 的目标不是最大限度压缩,而是在保留 provenance 的前提下消除部分叙事冗余。
5. 定性案例:SEEM 修复了三类错误
论文 Table 5 给出三个案例:
- Multi-hop: HippoRAG 2 回答“书名未说明”,SEEM 正确找回 Becoming Nicole;
- Single-hop: HippoRAG 2 只说“对孩子产生影响”,SEEM 找回更具体的 “awestruck and humbled”;
- Temporal: HippoRAG 2 回答 2024-01-07,SEEM 正确回答 2024-01-05。
这些例子分别对应跨片段关联、细粒度属性保留和时间解析,和 EEF 的设计目标一致。但它们是作者挑选的成功案例,不代表所有错误类型。论文没有系统展示错误融合、错误抽取或 RPE 引入干扰的反例。
十一、效率与工程代价
1. 论文没有给出端到端效率对比
论文没有报告 memory construction latency、query latency、token cost、存储开销或吞吐量。因此不能仅凭 1.32:1 的 frame 压缩率宣称 SEEM 更高效。
相反,作者在 Limitations 中明确承认:
- EEF extraction 需要 LLM;
- 相似事件判断需要 LLM;
- frame fusion 需要 LLM;
- 推理时还要序列化原文、EEF 和 facts。
与一次向量编码加 top-k 检索相比,写入成本明显更高。
2. 成本发生了迁移,而不是消失
SEEM 把一部分查询时的“临场理解”前移到了记忆写入阶段。若历史会被大量重复查询,预先抽取 EEF 可能摊薄成本;若大部分记忆只写入一次、很少读取,这种预处理可能得不偿失。
因此更合理的部署方式可能是:高价值或高复用事件进入 EEF/GML,普通日志保留轻量索引,而不是对所有交互一视同仁地调用融合 Agent。
十二、与 Agent Memory 系列方法的横向比较
| 方法 | 主要记忆单位 | 主要解决的问题 | 与 SEEM 的关键差异 |
|---|---|---|---|
| Mem0 | 抽取后的显著 facts | 从对话中提炼并维护用户记忆 | 更偏事实维护;SEEM 显式保存事件角色、事件融合和原文反向展开 |
| A-MEM | 可链接、可演化的 memory notes | 让记忆自主建立语义关联 | A-MEM 强调 note 网络的演化;SEEM 强调双层分工与事件 provenance |
| MAGMA | 多图/多视角组织的记忆结构 | 从不同关系视角组织记忆 | MAGMA 更重多维关系组织;SEEM 把事件 frame 作为叙事重建核心 |
| CoM | 面向上下文组织或压缩的记忆机制 | 让长历史形成可用上下文 | SEEM 的突出点是从检索命中反向恢复同一事件原文,而不只生成更好的摘要 |
| ReMemR1 | 可回访历史记忆的学习式机制 | 缓解 memorize-while-reading 的不可逆损失 | ReMemR1 强调记忆更新阶段主动回看;SEEM 强调结构化写入后在检索阶段反向溯源 |
| Mem²Evolve | 随经验演进的记忆系统 | 让记忆内容或策略持续更新 | Mem²Evolve 更关注演化;SEEM 主要关注一次事件如何被表示、融合和重建 |
| SEEM | EEF + temporal relational graph + raw passages | 修复 scattered retrieval,恢复完整叙事 | 核心是“事实入口—事件桥梁—原文证据”的可逆链路 |
这几类方法不是简单的替代关系。A-MEM、Mem²Evolve 更关注记忆如何生长;ReMemR1 关注写入时能否回看;SEEM 关注检索之后如何把碎片恢复为完整事件。一个更完整的 Agent Memory 系统完全可能把这些机制组合起来。
十三、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发
以下内容是基于论文机制的工程推演,不是论文已经验证的实验结论。
1. Coding Agent:把一次调试过程存成事件,而不是若干日志
Coding Agent 的长期记忆常被切成 commit、终端输出、报错和聊天消息。它们可以映射为 EEF:
- Participants:用户、Agent、测试进程;
- Action:修改函数、运行测试、回滚配置;
- Time:执行顺序和 commit 时间;
- Location:仓库、文件、函数;
- Causality:为什么修改;
- Manner:采用了哪种补丁或命令。
当新问题再次出现时,先由代码实体图命中某个文件或异常,再通过 RPE 找回整次调试链,比只召回一行报错更有价值。
2. Tool Agent:让工具调用和结果共享 provenance
工具调用可以被视为事件:输入参数、工具名称、执行结果、失败原因和补救动作共同构成 frame。若 Agent 只记住“调用成功”,后续无法解释结果从何而来;若保存 provenance,则能从高层结论回到原始 API 响应或文件。
3. Multi-Agent:把协作任务组织成共享事件
多个 Agent 可能分别产生计划、检索证据和验证结论。使用 participant 槽位记录责任主体、用 provenance 指向各自输出,可以把分散贡献融合为任务事件。
但共享融合尤其需要权限边界。某个 Agent 不应因为能看到融合摘要,就自动获得所有来源 passage 的读取权。RPE 必须继承原始证据的访问控制。
十四、局限性
1. LLM 抽取错误会沿结构传播
参与者消歧、相对时间解析和事件边界判断都由 LLM 完成。一次错误抽取可能进入 GML 与 EML,并在后续融合时被放大。原文 provenance 提供了纠错依据,但系统并没有自动保证每次都重新核验。
2. 固定六槽位可能约束表达能力
Participants、Action、Time、Location、Causality、Manner 对现实事件很通用,却不一定适合抽象偏好、情绪变化、假设、承诺强度和不确定信息。作者也承认,无法自然落入预定义 frame 的抽象信息可能丢失。
3. 缺少系统效率实验
论文证明了准确率,却没有回答构建 10 万轮记忆需要多少时间和费用,也没有比较查询延迟。对于生产 Agent,这不是次要问题,而是能否部署的决定因素。
4. Open-domain 是明确弱项
在 LoCoMo open-domain 类别中,SEEM 明显落后 HippoRAG 2。事件记忆适合恢复叙事,却可能不适合缺少事件锚点的常识检索。理想系统应先判断 query type,再决定是否触发 RPE。
5. 隐私与删除语义更复杂
一个 passage 可能同时被 GML facts 和多个融合 EEF 引用。用户要求删除原始信息时,系统需要同步清理图节点、frame 属性、摘要和聚合 provenance,否则会留下“结构化残影”。论文提出用户应有修改和删除权,但没有给出一致性删除算法。
6. 基准仍以 QA 为主
LoCoMo 与 LongMemEval 主要评估问答正确性,尚未验证长期 Agent 在规划、工具使用、行为适应和持续数月写入下的稳定性。
十五、我的理解与启发
1. SEEM 真正提出的是“可逆的记忆抽象”
很多记忆系统把摘要当成压缩后的最终内容。一旦细节被摘要丢掉,后续再聪明的 retriever 也无法恢复。SEEM 更像建立了一层可逆索引:EEF 负责告诉系统“这是哪件事”,provenance 负责让系统回到“当时到底说了什么”。
这比单纯讨论向量库还是图数据库更重要。长期记忆的核心不只是存储结构,而是抽象与证据之间能否往返。
2. 双层记忆的价值来自职责分离
GML 负责低熵、可传播的关系;EML 负责高上下文、带情境的经历。若把所有内容都塞进同一种节点,系统会在精确检索和叙事完整之间反复妥协。
论文给出的 0.46 平均相似度,从侧面说明两层不是形式上的重复。更值得继续研究的问题是:什么查询只需要 GML,什么查询必须进入 EML?如果加入 query router,或许能改善 open-domain 退化并降低成本。
3. RPE 是一种 event-aware retrieval expansion
传统 query expansion 扩展的是查询词,邻域检索扩展的是图节点,滑动窗口扩展的是文本位置。RPE 扩展的是“同一事件的来源集合”。它把检索单位从相似文本提升到事件成员,这个思路很适合迁移到代码调试链、工具执行轨迹和多人协作记录。
4. 下一步应当是可校正、可遗忘的 EEF
SEEM 当前的 frame 在融合后主要继续累积。真正长期运行时,还需要:
- 事件置信度与冲突版本;
- 新证据到来后的可逆拆分;
- 过期事实的时间闭区间;
- 删除一个 provenance 后重新计算摘要;
- 针对敏感内容的访问控制与审计。
换句话说,SEEM 已经较好回答了“如何形成事件”,但“事件如何被纠正、遗忘和授权访问”仍然开放。
十六、总结
SEEM 通过 Graph Memory Layer、Episodic Event Frame、Associative Fusion 与 Reverse Provenance Expansion 建立了一条从事实入口到事件语义、再回到原始证据的完整链路。
它在 LoCoMo 上取得 61.1 F1 和 78.0 Judge,在 LongMemEval 上达到 65.0% Accuracy,相比 HippoRAG 2 提升 4.4 个百分点;消融结果进一步表明 EEF、关系传播和 RPE 都有独立贡献。
与此同时,论文没有报告端到端成本与延迟,open-domain 问题明显退化,LLM 抽取和错误融合也可能污染长期记忆。因此,SEEM 最适合被理解为一种面向事件链问题的结构化记忆架构,而不是对所有检索任务都占优的通用替代品。
一句话总结:
SEEM 的关键不是多建了一层记忆,而是让 Agent 能从一个被命中的事实,沿事件结构反向找回整段经历及其原始证据。
参考资料
- Zhengxuan Lu et al. Structured Episodic Event Memory. ACL 2026. https://aclanthology.org/2026.acl-long.277/
- Adyasha Maharana et al. Evaluating Very Long-Term Conversational Memory of LLM Agents. ACL 2024. https://aclanthology.org/2024.acl-long.747/
- Di Wu et al. LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory. ICLR 2025. https://arxiv.org/abs/2410.10813
- Wujiang Xu et al. A-MEM: Agentic Memory for LLM Agents. https://arxiv.org/abs/2502.12110
- Prateek Chhikara et al. Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory. https://arxiv.org/abs/2504.19413
- Bernal Jiménez Gutiérrez et al. From RAG to Memory: Non-Parametric Continual Learning for Large Language Models. https://arxiv.org/abs/2502.14802
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/weixin_45642847/article/details/166141702