
一、一个人人都「知道」的常识
OLTP 用行存,OLAP 用列存。这几乎是数据库领域的标准答案。列式存储把同一列的数据连续存放,分析查询只读需要的列,压缩率高,扫描快,所以列存适合分析,成了一句不假思索就能说出口的常识。
金仓(KingbaseES)内置了 cstore_fdw 列存扩展。我本来想写一篇列存让分析查询快 N 倍的常规评测,老老实实造了 200 万行数据,行存列存各来一份,跑一轮 OLAP 查询。
结果直接把我的预期掀翻了。列存不但没快,反而全面更慢。
这篇文章就是这个反直觉结果的完整实录,以及它背后那个比列存快更值得记住的道理。
二、公平的擂台
为了对比公平,我造了一张典型的销售事实表,9 列的宽表,日期、区域、品类、金额、数量、成本、折扣这些,灌入 200 万行数据,然后用完全相同的数据建两种存储。
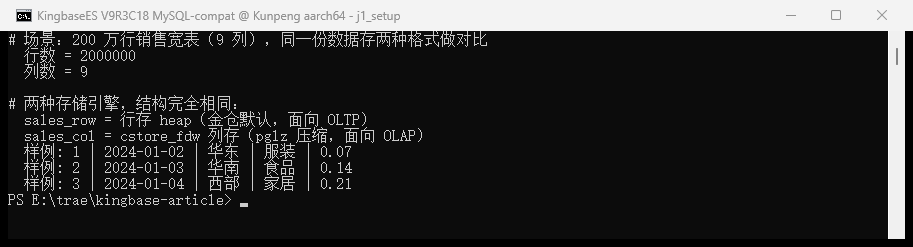
sales_row 是行存,heap,金仓默认的存储方式。sales_col 是 cstore_fdw 列存,带 pglz 压缩。
同样的 200 万行,同样的 9 列,同样的机器。擂台搭好,开打。
三、第一回合存储,列存赢得毫无悬念
先看存储体积,这是列存理论上的强项。
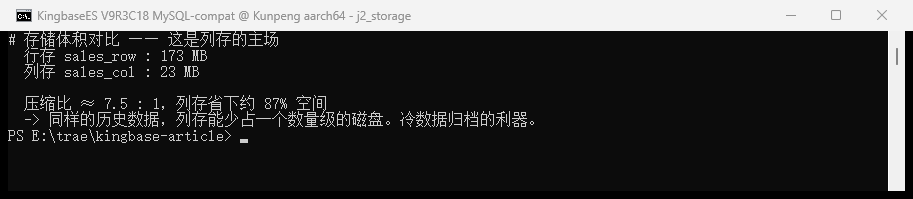
行存 sales_row 占 173MB,列存 sales_col 只占 23MB。压缩比约 7.5 比 1,列存省下了 87% 的空间。
这个结果完全符合预期。列式存储把同类型数据连续排列,pglz 能吃到极高的压缩率。同样一批历史数据,列存能少占一个数量级的磁盘。第一回合,列存干净利落地赢下。
四、第二回合查询,剧本反转了
带着存储都省这么多、查询肯定也快的预期,我跑了三类典型的分析查询。
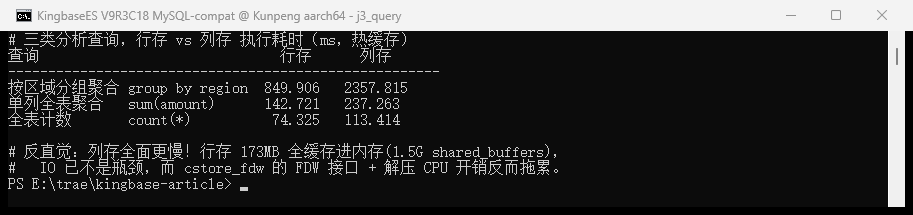
| 查询类型 | 行存 | 列存 | 结果 |
|---|---|---|---|
| 按区域分组聚合 GROUP BY region | 849 ms | 2364 ms | 行存快 2.8 倍 |
| 单列全表聚合 SUM(amount) | 142 ms | 237 ms | 行存快 1.7 倍 |
| 全表计数 COUNT(*) | 74 ms | 113 ms | 行存快 1.5 倍 |
列存全线溃败。
最典型的 OLAP 场景,分组聚合,行存比列存快了近 3 倍。连列存理论上最该赢的单列聚合,只读一列数据,列存也慢了 1.7 倍。这和列存适合分析的常识完全相反。
我不死心,又补测了一个对列存最有利的极端场景,只扫描一个窄列算 AVG(discount)。行存 156ms,列存 244ms,还是慢。列存在这台机器上,就是快不起来。
五、为什么,把常识拆开看
列存应该快,是因为它在磁盘 IO 成为瓶颈的时候能少读数据,只读需要的列,加上高压缩。这个前提,在我的实验里根本不成立。
行存的 173MB,整个装进了 1.5GB 的 shared_buffers。行存查询是纯内存扫描,磁盘 IO 早就不是瓶颈了。列存少读数据的看家本领,在数据已经全缓存的情况下,完全没有用武之地。
反过来,列存要付的代价却一分不少。cstore_fdw 是通过外部数据包装器实现的,每次查询都要穿过 FDW 这层翻译,没法像原生行存那样走最优路径,比如并行扫描。列存省空间靠压缩,查询时每一块数据都要先解压,这是纯 CPU 开销。聚合的时候,还要把列式数据重新组装成行来计算,又是一笔。
IO 不是瓶颈的时候,省 IO 的收益是零,解压、FDW、重组的成本却实实在在压上来。此消彼长,列存自然更慢。
六、冷缓存也救不了
写到这你可能想反驳,那是因为数据全缓存了,如果冷启动、真的要读磁盘呢?那不正是列存少读数据的主场?
我把这个反驳也测了。重启实例清空 shared_buffers,模拟冷启动首次查询。
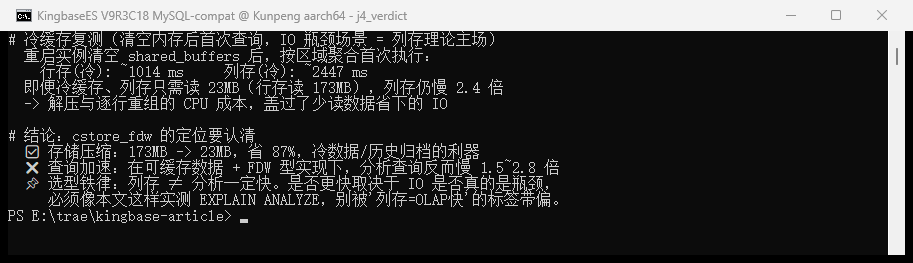
行存冷查询约 1014 ms,列存约 2447 ms。
即便是冷缓存,列存只需要从磁盘读 23MB,行存要读 173MB,列存依然慢 2.4 倍。少读了 150MB 的 IO,还是更慢,因为解压和逐行重组的 CPU 成本,盖过了少读数据省下的那点 IO 时间。在 4 核这种 CPU 不算宽裕的机器上,这个天平尤其向 CPU 开销一侧倾斜。
七、那么 cstore_fdw 到底该怎么用
测到这里,结论已经很清楚了。但它不是列存没用,而是列存的价值被贴错了标签。
**cstore_fdw 的真正强项是存储压缩,不是查询加速。**173MB 压到 23MB,实打实的省空间利器。这个能力最适合的场景是冷数据、历史数据的归档,那些必须留存但极少查询的老数据,比如三年前的流水,用列存归档能省下大量磁盘成本。另一类是超大规模、慢磁盘加列裁剪的组合,数据量远超内存、磁盘 IO 真的成了瓶颈、查询又只涉及宽表的少数列,这时候列存少读数据的优势才可能压过它的 CPU 开销,扳回一城。
而它不适合的场景,恰恰是很多人以为它擅长的,热点数据的交互式分析。数据能缓存进内存的时候,行存的纯内存扫描又快又直接,列存的 FDW 加解压开销纯属拖累。
八、别让常识替你做选型
我本来要写一篇列存加速分析的评测,最后写成了一篇列存反而更慢的实录。
200 万行数据给出的真实答案是,cstore_fdw 把存储压缩了 7.5 倍,173MB 到 23MB,却让分析查询慢了 1.5 到 2.8 倍。它是出色的存储压缩器,不是查询加速器。
更值得带走的是它背后的方法论。列存适合 OLAP 这句话需要加前提,前提是 IO 真的是瓶颈。数据能装进内存、CPU 成为瓶颈的时候,这句常识会带你走进反方向。技术选型上,任何「X 一定比 Y 快」的标签都值得警惕。唯一可靠的办法,是用你自己的数据、你自己的机器,亲手跑一遍 EXPLAIN ANALYZE。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/weixin_66401877/article/details/163053751