
1数据库原理
文章目录
1.1数据的分类
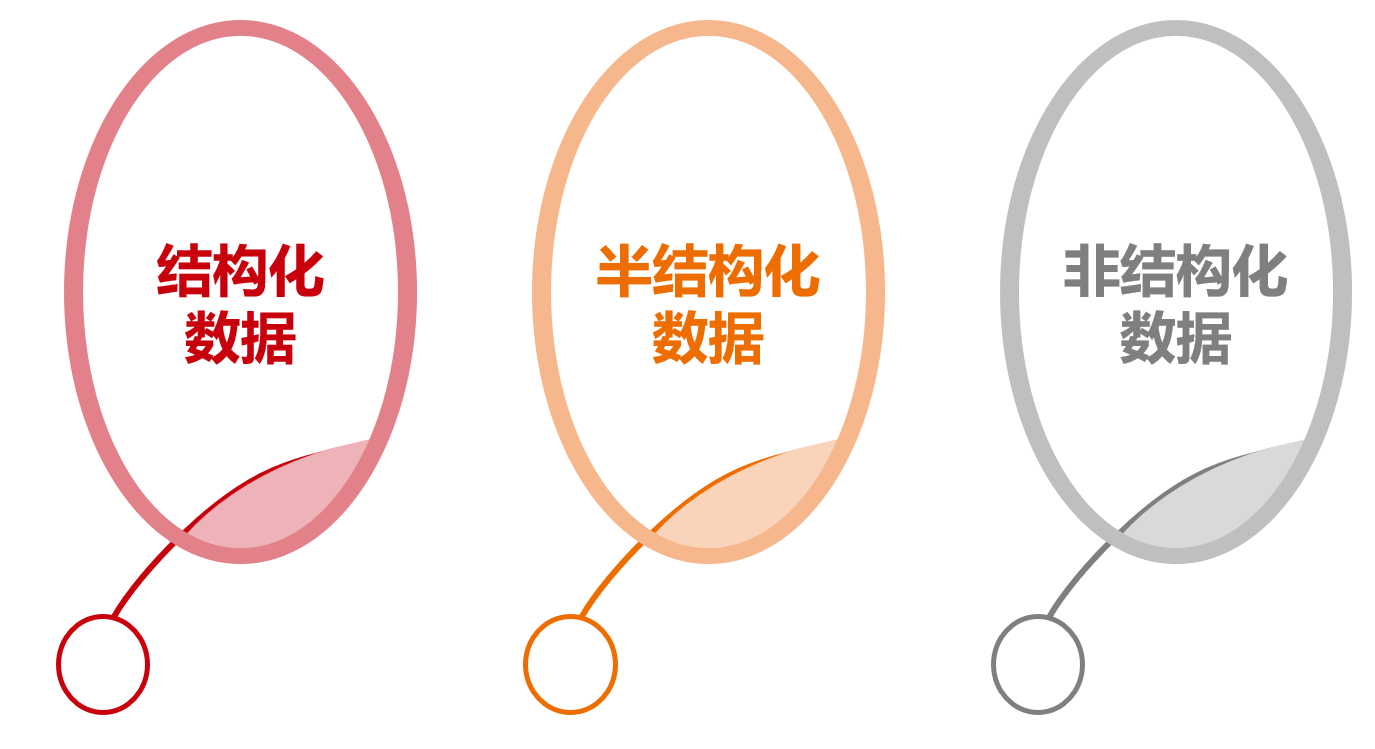
在数据的获取和使用的过程中,我们可以根据数据的结构类型,将数据分成三类,分别是:结构化数据,半结构化数据,非结构化数据。
结构化数据
结构化数据一般是指可以用二维表来逻辑表达实现的数据。是有固定的格式和有限长度的数据,可以用关系型数据库表示和存储。
其特点是:数据以行为单位,一行数据表示一个实体信息,每一行数据的属性是相同的,存储在数据库中;能够用统一的数据类型和结构加以表示;也能够用二维表结构来逻辑表达实现,包含属性和元组。
对于结构化数据来讲通常是先有结构再有数据。
范例:二维表
| no | name | age |
|---|---|---|
| 1 | 唐三 | 123 |
| 2 | 叶凡 | 456 |
半结构化数据
半结构化数据就是介于完全结构化数据和完全无结构的数据之间的数据。
半结构化数据是结构化数据的一种形式,它并不符合关系型数据库或其它数据表的形式关联起来的数据模型结构,但包含相关的标记,用来分隔语义元素及对记录和字段进行分层,数据的结构和内容混在一起,没有明显的区分,因此,这种数据也被称为自描述结构的数据。
例如:HTML文档,JSON,XML和一些NoSQL数据库等就属于半结构化数据。
对于半结构化数据来说则是先有数据再有结构。
范例:json
[
    {
        "id":1,
        "name": "唐三",
        "age":123
    },
    {
        "id":2,
        "name": "叶凡",
        "age":456
    }
]
非结构化数据
顾名思义,就是没有固定结构的数据,这种数据没有固定格式和有限长度,无法用数据库二维逻辑表来表现其结构,对于这类数据,我们一般进行整体存储。
典型的非结构化数据包括:二进制文件,音视频文件,位置信息等
1.2数据管理发展历史
如何有效管理大量数据,方法和手段都在随着计算机技术的发展而进步。
数据管理的发展经历了人工管理、文件系统和数据库系统三个发展阶段。
1.2.1数据管理的三个阶段
人工管理阶段
时间:20世纪50年代中期以前
特点:当时的计算机主要用于科学计算。外部存储设备只有磁带,打孔纸带等,也没有专业的数据管理软件,所以在当时数据管理主要由人工完成。数据处理方式上基本是批处理。
文件系统管理阶段
时间:20世纪50年代后期至60年代中期
特点:随着时间的发展,计算机不仅用于科学计算,还用于信息管理,需要处理的数据量大增,数据存储,检索和维护等问题迫切需要解决,同一时期,在硬件方面,出现了磁盘,磁鼓等可以直接连机存取的设备,在此基础上,出现了基于文件系统的数据管理软件。使用磁盘文件的形式来管理数据,数据可以在系统中长期保存,文件也有了各种各样的格式。在数据处理方式上可以批处理,也可以联机实时处理。
数据库系统阶段
时间:20世纪60年代后期至今
特点:此时己经出现大容量的磁盘,且硬件价格开始下降。数据管理技术进入数据库系统阶段。数据库系统克服了文件系统的缺陷,提供了对数据更高级、更有效的管理。这个阶段的程序和数据的联系是通过数据库管理系统来实现的。数据库系统采用了复杂的结构化的数据模型,数据拥有高独立性,低冗余度。
1.2.2文件管理系统的特点
优点
文件形式和格式多样化,数据可以长期保存,且数据具有一定的独立性,由文件系统进行管理。
缺点
应用程序对接不方便,没有统一接口,也不支持对文件的并发访问,无安全控制功能,难以按用户视图表示数据,数据间联系弱,数据冗余不可避免。
1.3数据库管理系统
1.3.1相关概念
数据库:Database
数据库是按照一定的数据结构来组织,存储和管理数据的仓库。
是一个长期存储在计算机内的、有组织的、可共享的、统一管理的大量数据的集合。
数据库管理系统:Database Management System(DBMS)
数据库管理系统是一种操纵和管理数据库的大型软件,用于建立,使用和维护数据库,简称DBMS。
它对数据库进行统一的管理和控制,以保证数据库的安全性和完整性。
数据库管理员:Database Administrator(DBA)
DBA是从事管理和维护数据库管理系统(DBMS)的相关工作人员的统称,属于运维工程师的一个分支,主要负责业务数据库从设计、测试到部署交付的全生命周期管理。
DBA的核心目标是保证数据库管理系统的稳定性、安全性、完整性和高可用性能。
应用程序:Application
一个应用程序通常是指能够执行某种功能的软件程序。
1.3.2数据库管理系统特点
- 数据库管理系统中采用了复杂的数据模型表示数据结构,数据冗余小,易扩充,实现了数据共享。
- 具有较高的数据和程序独立性。数据库的独立性表现在物理独立性和逻辑独立性两个方面。
- 数据库管理系统为用户和应用程序提供了方便和统一的查询接口。
- 数据库管理系统的存在,使得数据可以和应用程序解耦。
- 数据库管理系统还具有并发控制,数据备份和恢复,完整性和安全性保障等功能。
1.3.3数据库管理系统基本功能
- 数据的定义:DBMS提供了数据定义语言DDL(DataDefinition Language),供用户定义数据库的三级模式结构,两级映像以及完整性约束和保密限制等约束。DDL主要用于建立、修改数据库的库结构。DDL所描述的库结构仅仅给出了数据库的框架,数据库的框架信息被存放在数据字典中。
- 数据操作:DBMS提供数据操作语言DML(DataManipulation Language),供用户实现对数据的追加、删除、更新、查询等操作。
- 数据组织、存储与管理:DBMS要分类组织、存储和管理各种数据,包括数据字典、用户数据、存取路径等,需确定以何种文件结构和存取方式在存储级上组织这些数据,如何实现数据之间的联系。数据组织和存储的基本目标是提高存储空间利用率,选择合适的存取方法提高存取效率。
- 数据库的运行管理:数据库的运行管理功能是DBMS的运行控制、管理功能,包括多用户环境下的并发控制、安全性检查和存取限制控制、完整性检查和执行、运行日志的组织管理、事务的管理和自动恢复,即保证事务的原子性。这些功能保证了数据库系统的正常运行。
- 数据库的维护:这一部分包括数据库的数据载入、转换、转储、数据库的重组和重构以及性能监控等功能,这些功能分别由各个使用程序来完成。
- 数据库的保护:数据库中的数据是信息社会的战略资源,所以数据的保护至关重要。DBMS对数据库的保护通过4个方面来实现:数据库的恢复、数据库的并发控制、数据库的完整性控制、数据库安全性控制。DBMS的其他保护功能还有系统缓冲区的管理以及数据存储的某些自适应调节机制等。
- 通信:DBMS具有与操作系统的联机处理、分时系统及远程作业输入的相关接口,负责处理数据的传送。对网络环境下的数据库系统,还应该包括DBMS与网络中其他软件系统的通信功能以及数据库之间的互操作功能。
1.3.4数据库管理系统的发展历史
自20世纪60年代中后期开始,使用电脑进行数据处理的规模越来越大,同时也出现了大容量的磁盘存储设备,操作系统也日渐成熟,为了解决数据的独立性问题,实现数据的统一管理,达到数据共享的目的,出现了数据库技术。
数据库技术从出现至今,经历了多次的迭代行进,在这个过程中,按时间和特性,可以将数据库管理系统分为三类。
层次数据库
层次模型数据库系统是最早研制成功的数据库系统,这种数据库中的数据被组织成一个树状模型,这种结构简单,但缺乏灵活性,各数据之间仅限于一对多的关系。
这种数据库最成功的典型代表是IBM的IMS(信息管理系统)。
网状数据库
网状数据库是采用网状原理和方法,以网状数据模型为基础建立的数据库。
网状数据模型是以记录类型为结点的网络结构,即一个结点可以有一个或多个下级结点,也可以有一个或多个上级结点,两个结点之间甚至可以有多种联系,两个记录类型之间的值可以是多对多的联系。
关系型数据库管理系统
关系数据库管理系统:Relational DatabaseManagement System(RDBMS)
是指包括相互联系的逻辑组织和存取这些数据的一套程序(数据库管理系统软件)。关系数据库管理系统就是管理关系数据库,并将数据逻辑组织的系统。
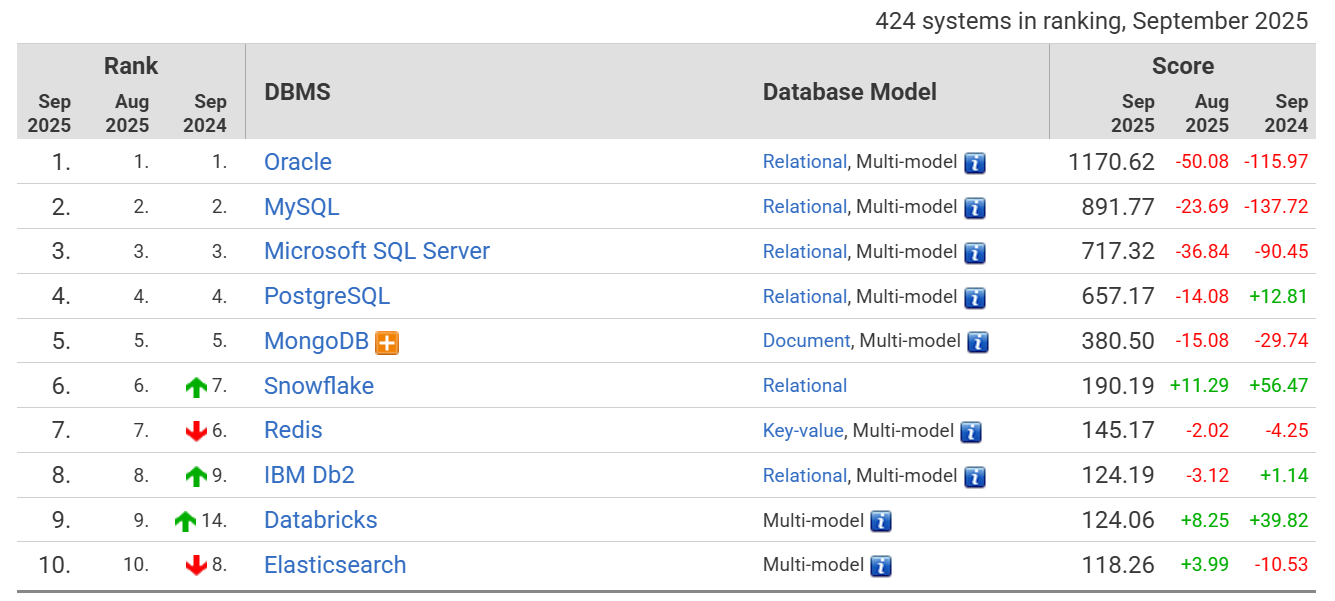
常见的关系型数据库管理系统有Oracle,MySQL,DB2,SQLServer等。
关系型数据库,是指采用了关系模型来组织数据的数据库,其以行和列的形式存储数据,以便于用户理解,关系型数据库这一系列的行和列被称为表,一组表组成了数据库。用户通过查询来检索数据库中的数据,而查询是一个用于限定数据库中某些区域的执行代码。关系模型可以简单理解为二维表格模型,而一个关系型数据库就是由二维表及其之间的关系组成的一个数据组织。
关系型数据库中的相关概念
在我们开始学习MySQL 数据库前,让我们先了解下RDBMS的一些术语:
- 数据库: 数据库是一些关联表的集合。
- 数据表: 表是数据的矩阵。在一个数据库中的表看起来像一个简单的电子表格。
- 列(column): 一列(数据元素) 包含了相同类型的数据, 例如邮政编码的数据。
- **行(Row):**一行(元组,或记录)是一组相关的数据,例如一条用户订阅的数据。
- 冗余:存储两倍数据,冗余降低了性能,但提高了数据的安全性。
- 主键(Primary key):主键是唯一的。一个数据表中只能包含一个主键。你可以使用主键来查询数据。
- **外键:**外键用于关联两个表。
- 复合键:复合键(组合键)将多个列作为一个索引键,一般用于复合索引。
- **索引:**使用索引可快速访问数据库表中的特定信息。索引是对数据库表中一列或多列的值进行排序的一种结构。类似于书籍的目录。
- 参照完整性: 参照的完整性要求关系中不允许引用不存在的实体。与实体完整性是关系模型必须满足的完整性约束条件,目的是保证数据的一致性。
MySQL 为关系型数据库(Relational Database Management System), 这种所谓的"关系型"可以理解为"表格"的概念, 一个关系型数据库由一个或数个表格组成, 如图所示的一个表格:
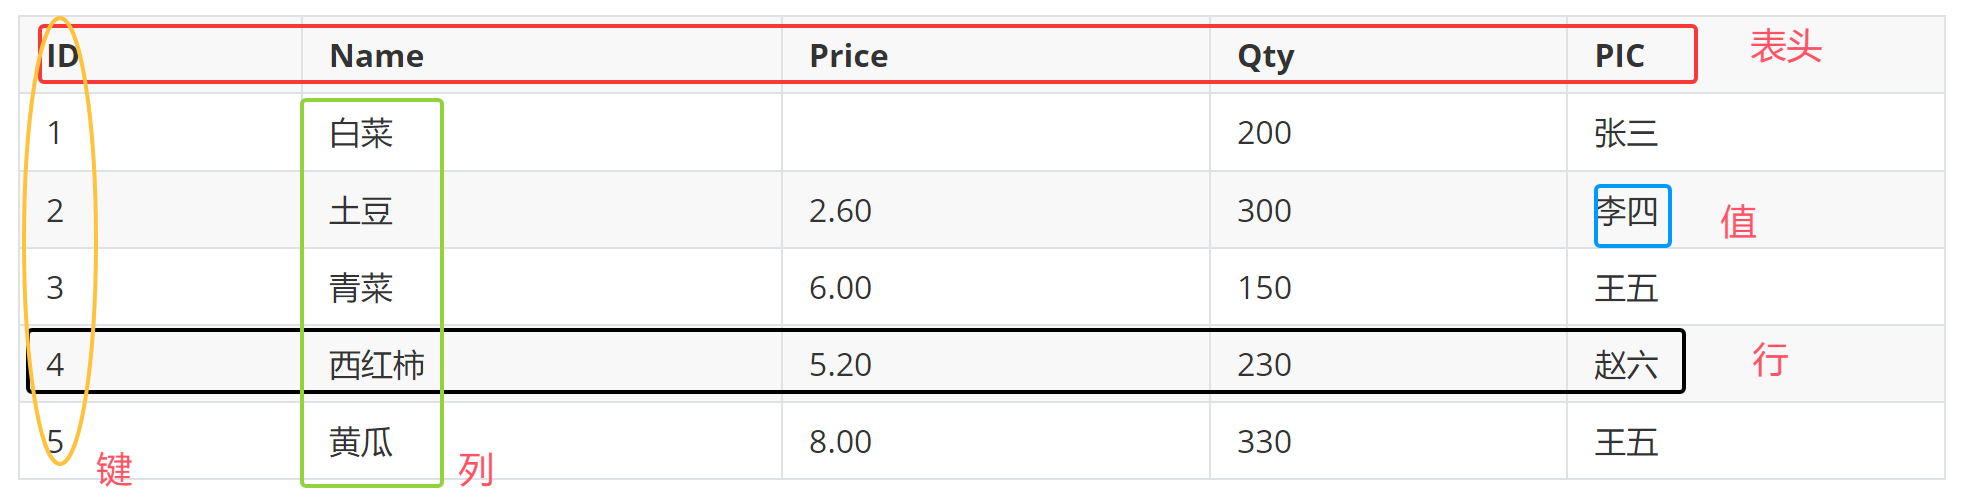
- 表头(header): 每一列的名称;
- 列(col): 具有相同数据类型的数据的集合;
- 行(row): 每一行用来描述某条记录的具体信息;
- 值(value): 行的具体信息, 每个值必须与该列的数据类型相同;
- 键(key): 键的值在当前列中具有唯一性。
常见的关系型数据库系统
MySQL:MySQL,MariaDB,Percona Server
PostgreSQL:PgSQL,EnterpriseDB
Oracle:Oracle
SQLServer:MS SQLServer
DB2
1.3.5数据库软件排名
https://db-engines.com/en/ranking
1.4关系型数据库理论
1.4.1 E-R模型
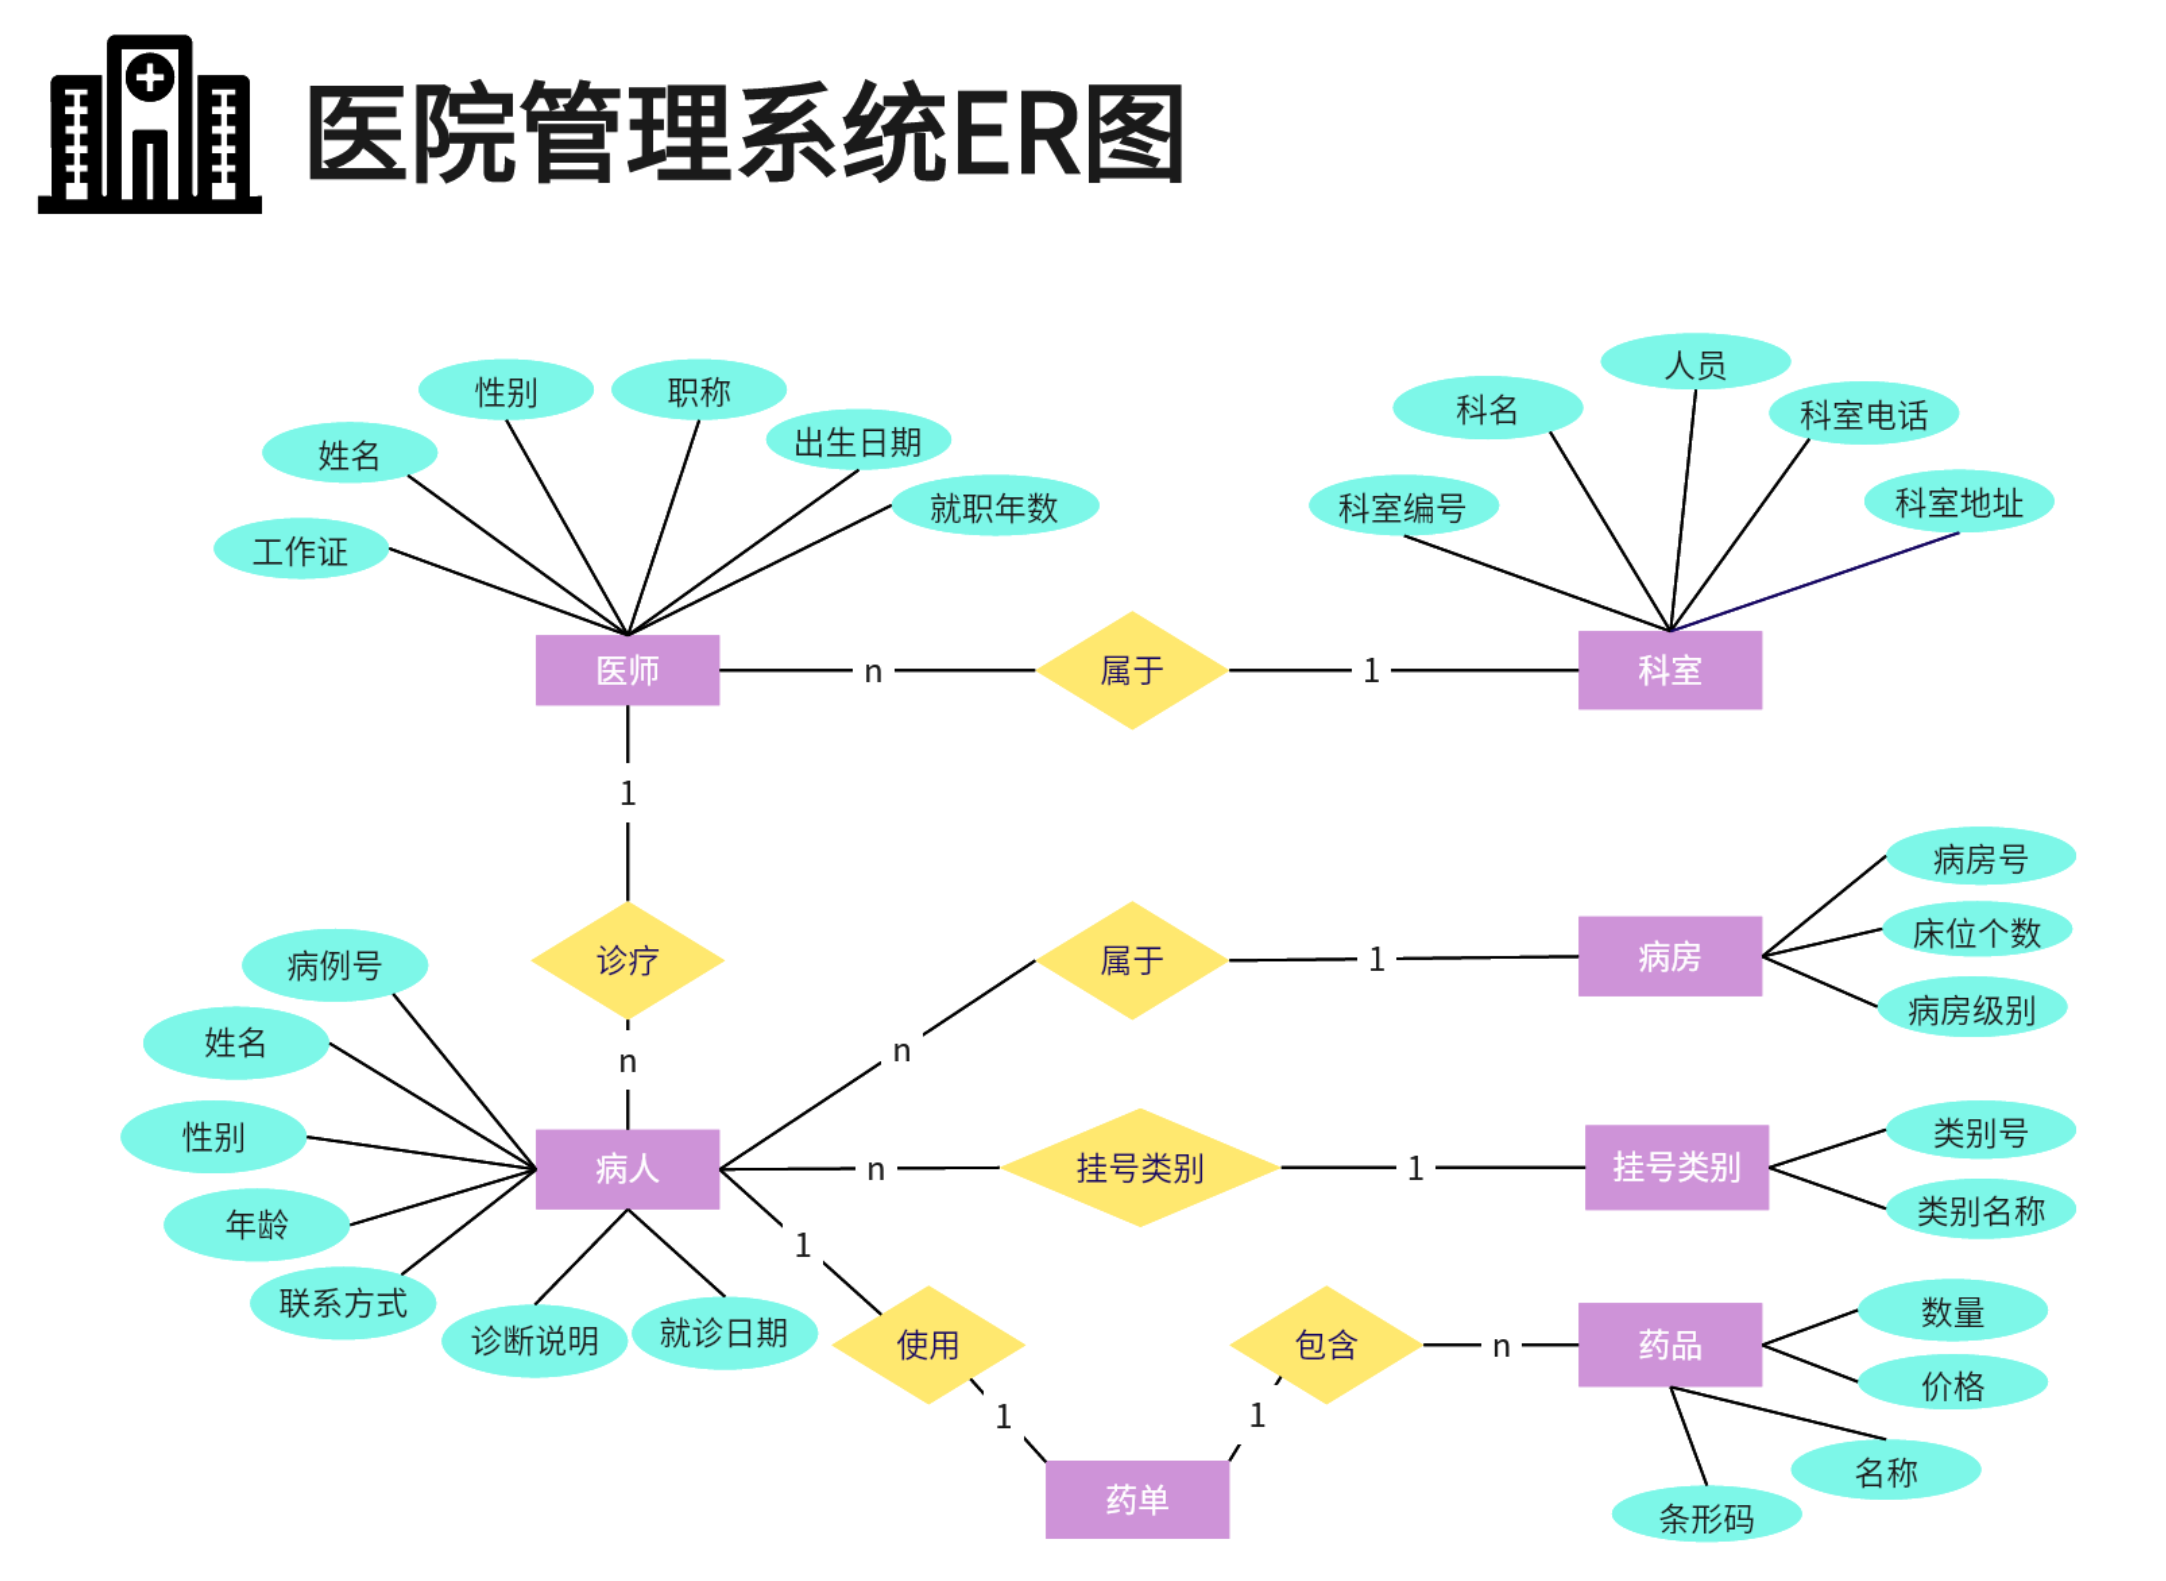
ER模型,全称为实体联系模型、实体关系模型或实体联系模式图(ERD:Entity-relationship model),它提供不受任何DBMS约束的面向用户的表达方法,在数据库设计中被广泛用作数据建模的工具。
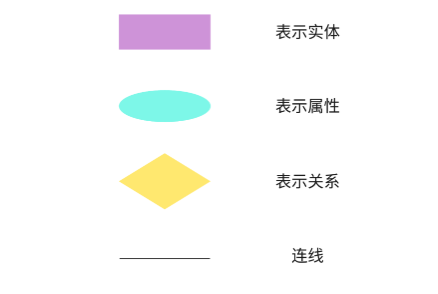
E-R图模型的组成是由实体,属性和联系三部份组成。
实体:(Entity)实体是数据的使用者,代表软件系统中客观存在的生活中的实物,同一类实体构成实体集。在ER图中,实体用矩形表示。
属性:(Attribute)实体中的所有特性称为属性,每个属性描述的是实体的单个特性。在ER图中,属性用椭圆形表示。
联系:(Relationship)描述了实体的属性之间的关联规则。在ER图中,联系用菱形表示。ER模型范例:
1.4.2 联系类型
实体间的联系有三种类型:
一对一联系(1:1):一个 A 对应一个B,一个 B 对应一个A
例:
- 人 ↔ 身份证
- 丈夫 ↔ 妻子
一对多联系(1:n):一个 A 对应多个B,一个 B 只对应一个A
例:
- 一个班级 → 多个学生
- 一个老师 → 多个学生
- 一个部门 → 多个员工
多对多联系(m:n):一个 A 对应多个 B,一个 B 对应多个 A
例:
- 学生 ↔ 课程(一个学生选多门课,一门课多个学生)
- 商品 ↔ 订单
学生表一对—
| stu_id | name |
|---|---|
| 1 | 唐三 |
| 2 | 叶凡 |
老师表一对—
| teacher_id | name |
|---|---|
| 1 | gao |
| 2 | ma |
老师与课程一对多
| class_id | name | teacher_id |
|---|---|---|
| 1 | linux | 1 |
| 2 | golang | 1 |
| 3 | python | 2 |
| 4 | java | 2 |
学生与课程多对多
| class_id | stu_id |
|---|---|
| 1 | 1 |
| 1 | 2 |
| 2 | 1 |
| 2 | 2 |
| 3 | 1 |
| 3 | 2 |
1.4.3数据的操作
数据库中对数据的操作主要包括增删改查
| 操作描述 | 作用 | SQL关键字 |
|---|---|---|
| Create | 增加数据 | Insert |
| Read | 读取数据 | Select |
| Update | 更新数据 | Update |
| Delete | 删除数据 | Delete |
1.4.4数据库的正规化分析(理论)
数据库规范化,又称数据库或资料库的正规化、标准化,是数据库设计中的一系列原理和技术,以减少数据库中数据冗余,增进数据的一致性。设计关系数据库时,遵从不同的规范要求,设计出合理的关系型数据库,不同的规范要求被称为不同范式,各种范式呈递次规范,越高的范式数据库冗余越小。
目前关系数据库有六种范式:第一范式(1NF)、第二范式(2NF)、第三范式(3NF)、巴德斯科范式(BCNF)、第四范式(4NF)和第五范式(5NF,又称完美范式)。满足最低要求的范式是第一范式(1NF)。在第一范式的基础上进一步满足更多规范要求的称为第二范式(2NF),其余范式以次类推。一般数据库只需满足第三范式(3NF)即可。
第一范式1NF(确保每列保持原子性)
第一范式是最基本的范式。如果数据库表中的所有字段值都是不可分解的原子值,就说明该数据库表满足了第一范式。
第一范式需要根据系统的实际需求来定。其核心是要保证数据表中的列里面没有重复值,即实体中的某个属性不能有多个值或者不能有重复的属性,确保每一列的原子性。
列重复
| id | teacher_name | class_1 | class_2 | class_3 |
|---|---|---|---|---|
| 1 | ma | golang | linux | python |
| 2 | gao | golang | linu | |
| 3 | ma | golang |
列不重复
| id | teacher_name | class |
|---|---|---|
| 1 | ma | golang |
| 2 | ma | linux |
| 3 | ma | python |
| 4 | gao | golang |
| 5 | gao | linux |
| 6 | ma | golang |
第一范式(1NF)——原子性
核心要求:表中的每个字段都必须是不可再分的原子值。
反例:
学生ID | 联系方式
001    | 13800138000, [email protected]
→ “联系方式”包含多个值,违反 1NF。
正例:
学生ID | 手机号         | 邮箱
001    | 13800138000   | [email protected]
💡 简单说:每一列只能存一个值,不能是列表、集合或复合结构。
第二范式2NF(确保表中的每列都和主键相关)
第二范式在第一范式的基础之上更进一层。第二范式需要确保数据库表中的每一列都和主键相关,而不能只与主键的某一部分相关(主要针对联合主键而言)。也就是说在一个数据库表中,一个表中只能保存一种数据,不可以把多种数据保存在同一张数据库表中。
teacher_name 和city组成联合主键,city_code与city——对应,city_code依赖了部份主键,违反了第二范式
| teacher_name | city | age | city_code |
|---|---|---|---|
| gao | bj | 22 | 010 |
| ma | bj | 33 | 010 |
| gao | sh | 44 | 021 |
teacher_name与ctiy_id组成联合主键,再用city_id关联city_name和city_code,这样符合第二范式
| teacher_name | city_id | age |
|---|---|---|
| gao | 1 | 22 |
| ma | 1 | 33 |
| gao | 2 | 44 |
| city_id | city_name | city_code |
|---|---|---|
| 1 | bj | 010 |
| 2 | sh | 021 |
第二范式(2NF)——消除部分依赖
前提:已满足 1NF
核心要求:所有非主键字段必须完全依赖于整个主键(不能只依赖主键的一部分)。
适用于复合主键场景。
部分依赖:非主属性只依赖于主键中的某一部分。
反例(订单明细表):
订单ID | 商品ID | 商品名称 | 数量
1001   | P001   | 苹果     | 5
主键 = (订单ID, 商品ID)
但“商品名称”只依赖于“商品ID”,不依赖“订单ID” → 违反 2NF。解决方法:拆表
- 商品表(商品ID, 商品名称)
- 订单明细表(订单ID, 商品ID, 数量)
💡 简单说:非主键字段不能“只认主键的一部分”。
第三范式3NF(确保每列都和主键列直接相关,而不是间接相关)
第三范式需要确保数据表中的每一列数据都和主键直接相关,而不能间接相关。
必须先满足第一范式才能满足第二范式,必须同时满足第一第二范式才能满足第三范式。
teacher 表一对一
| teacher_id | teacher_name |
|---|---|
| 1 | ma |
| 2 | gao |
| 3 | ma |
class表一对一
| class_id | class_name |
|---|---|
| 1 | golang |
| 2 | linux |
| 3 | python |
teacher与class多对多
| teacher_id | class_id |
|---|---|
| 1 | 1 |
| 1 | 2 |
| 1 | 3 |
| 2 | 1 |
| 2 | 2 |
| 3 | 1 |
第三范式(3NF)——消除传递依赖
前提:已满足 2NF
核心要求:非主键字段之间不能有依赖关系(即不能存在“传递依赖”)。
传递依赖:A → B → C,则 C 传递依赖于 A。
所有非主属性必须直接依赖于主键,不能通过其他非主属性间接依赖。
反例:
学生ID | 学院ID   | 学院地址
2001    | CS01   | 北京中关村
主键 = 学生ID
依赖关系:学生ID → 学院ID → 学院地址
→ “学院地址”传递依赖于“学生ID”,违反 3NF。解决方法:拆表
- 学生表(学生ID, 学院ID)
- 学院表(学院ID, 学院地址)
💡 简单说:非主键字段之间不能“互相推导”。
总结:
总结对比
范式 核心目标 关键规则 1NF 原子性 字段不可再分 2NF 消除部分依赖 非主属性必须完全依赖整个主键 3NF 消除传递依赖 非主属性之间不能相互依赖 越高范式,冗余越少,表越多。
实际开发:一般满足 3NF 即可。
1.4.5 SQL结构化查询语言
SQL:(StructureQueryLanguage),结构化查询语言。是一种数据库查询和程序设计语言,用于存取数据以及查询、更新和管理关系数据库系统,SQL语句就是用SQL语言写的用于操作数据库的语句。
关系型数据库一般工作于C/S模式下,使用专有协议进行通信,服务端程序监听特有端口,客户端程序发送查询语句到服务端,服务端将查询结果返回给客户端。
MySQL自带CLI接口,GUI接口可以使用第三方工具实现,在应用程序或后端开发语言中,使用相应的编程语言下的数据库驱动来进行与数据库服务端的通信。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/weixin_63581562/article/details/166995222