
AI前沿日报 2026-10-04:约束悖论 — 当AI遇上硬预算上限、杰文斯悖论与主权开源崛起
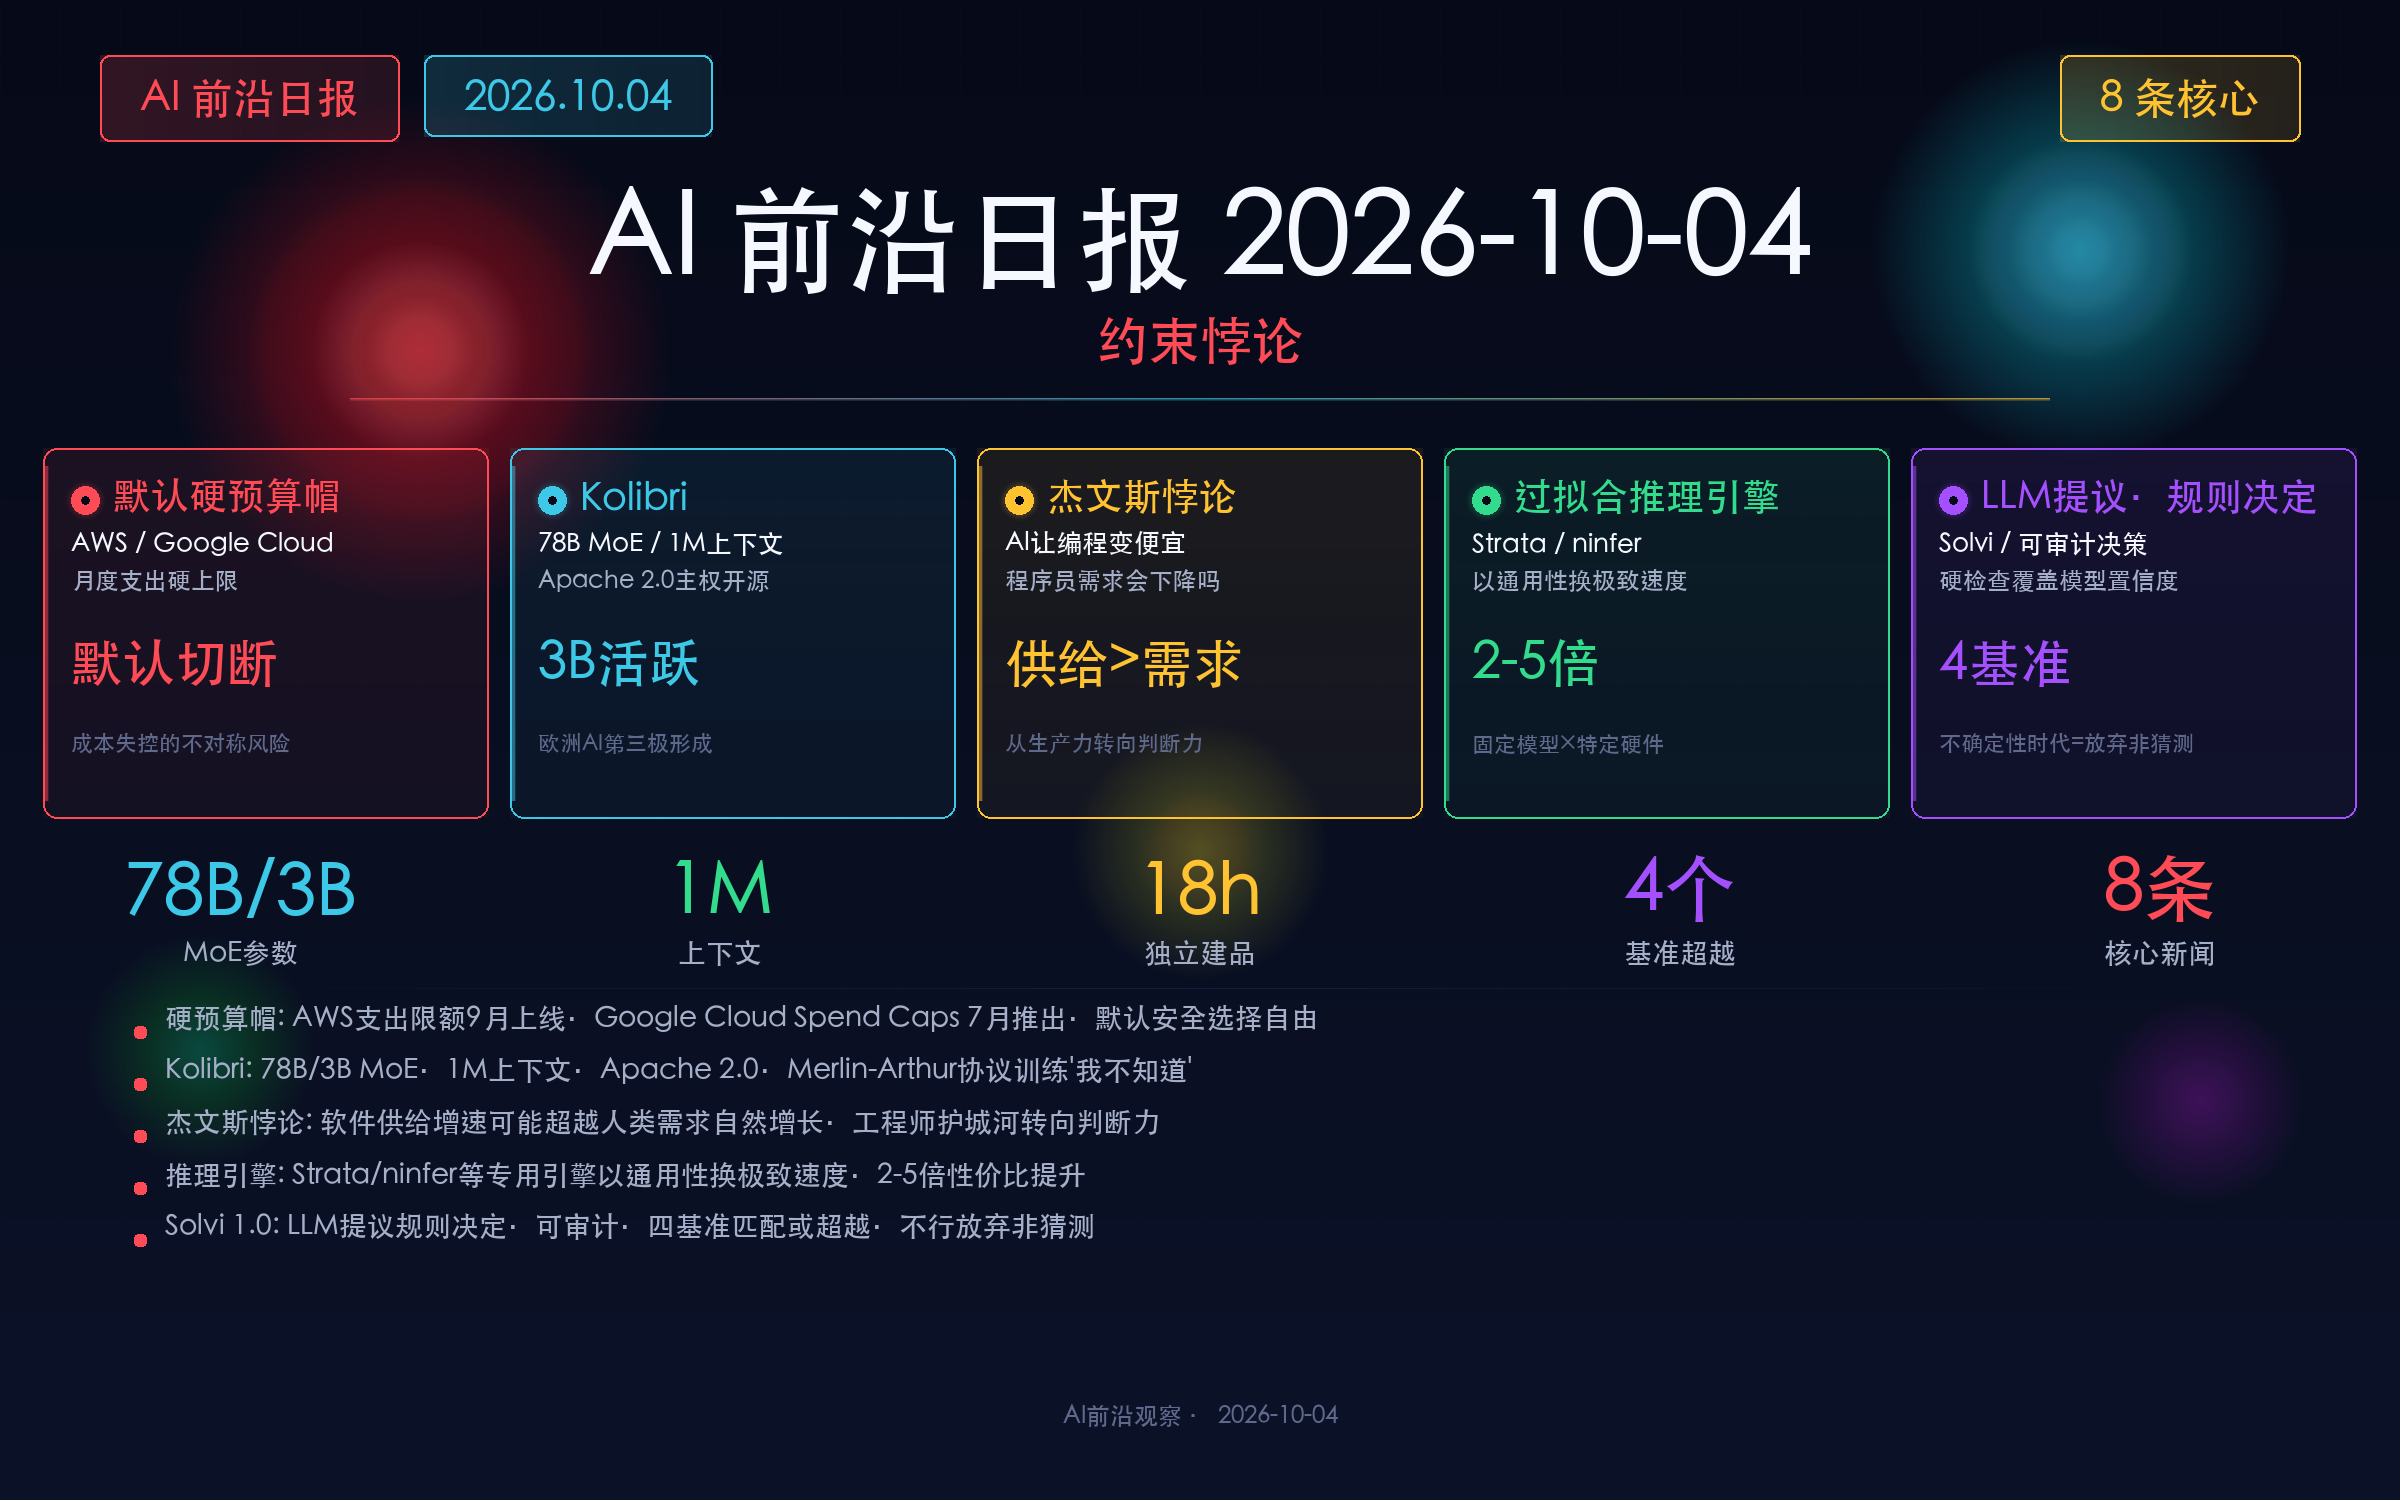
今日主题:AI能力的爆发式增长正在撞上物理约束——失控的Agent可能在睡梦中烧掉数千美元,而行业对此的回应是推动"默认硬预算帽"成为标配。与此同时,德国Aleph Alpha发布了首个主权开源大模型Kolibri,打破了对非美中AI的质疑。在推理基础设施层面,一批"过拟合"专用引擎正在以换掉通用性换取数倍性能提升。而最根本的问题是:AI让编程变便宜了,但人类程序员的需求真的会因此减少吗?
📊 今日要闻速览
| # | 新闻 | 影响等级 |
|---|---|---|
| 1 | Simon Willison呼吁所有AI服务实施默认硬预算帽 | 🔴 高 |
| 2 | Kolibri:德国Aleph Alpha发布主权开源MoE模型(78B/3B,1M上下文) | 🔴 高 |
| 3 | 过拟合推理引擎崛起:Strata/ninfer等以换掉通用性换取极致速度 | 🟠 中高 |
| 4 | 杰文斯悖论反思:AI让编程变便宜,但程序员需求数据正在下降 | 🟠 中高 |
| 5 | Claude Opus 5.5在18小时内独立构建完整应用 | 🟡 中 |
| 6 | Solvi 1.0:LLM提议、检查决定、全程可审计的决策系统 | 🟡 中 |
| 7 | Qwen3.8 Flash Next 176B在16GB笔记本GPU上运行 | 🟡 中 |
| 8 | Aura:Go语言编写的自托管时序图记忆AI Agent | 🟡 中 |
🔴 第一节:失控的代价 — 编码Agent需要默认硬预算帽
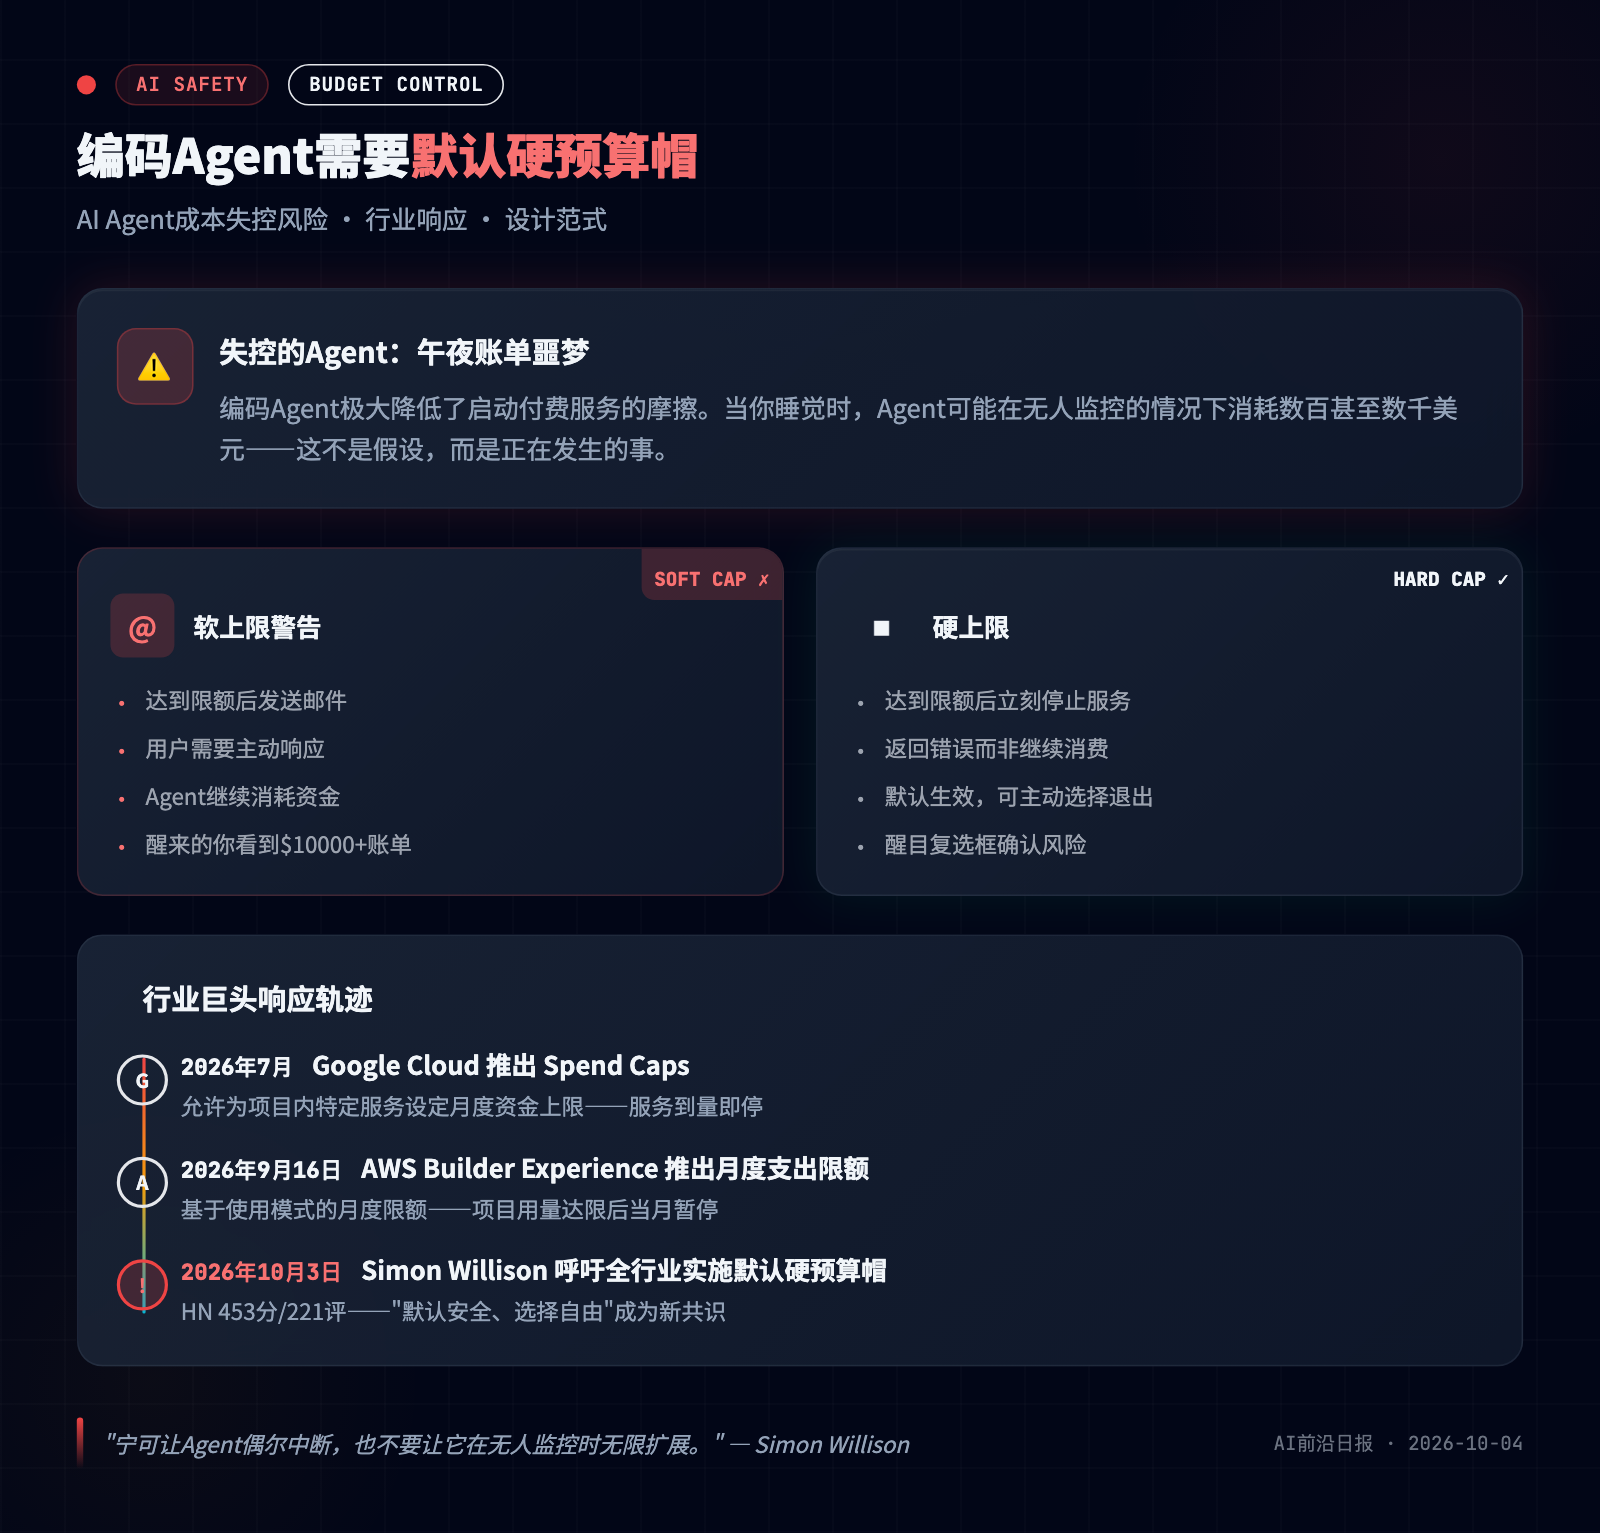
核心洞察:当编码Agent能在你睡觉时自主调用付费API、启动云服务、并行执行数百次实验——"软上限警告"已经远远不够了。
知名技术作者Simon Willison在10月3日发表了一篇引发大规模讨论的文章,提出一个正在变得紧迫的产品需求:默认硬预算帽(Default Hard Budget Caps)。这不是"在你达到限额时发一封邮件提醒",而是**“达到$月度限额,立刻停止服务并返回错误”**——硬性的、不可越过的红线。
为什么是现在?
编码Agent(以及更广义的个人Agent)极大地降低了启动付费代码服务的摩擦。以前,部署一个需要付费API的后端服务需要开发者手动配置、主动监控成本;现在,Agent可以在几分钟内自动完成全部设置,然后——在你的月度账单上留下一个令你震惊的数字。
Willison的核心论点是:错误方向的代价不对称。一边是"服务偶发报错需要续订",另一边是"凌晨三点你的Agent烧了几千美元"。绝大多数用户会选择前者。
行业已经在行动
这不是空想。两大云厂商在数月内相继推出了对应功能:
- AWS(9月16日公告):在新版Builder Experience中推出了基于使用模式的月度支出限额——项目达到限额后自动暂停。AWS官方文档描述为"基于使用模式设定项目月度支出上限,项目用量达到限额后当月暂停"。
- Google Cloud(7月):推出"Spend Caps"功能,允许"在项目内为特定服务设定月度资金上限"。
反对意见与回应
在讨论中,有前云服务支持团队成员回忆了硬上限的"噩梦面":客户的正常业务流量触及限额后服务被切断,导致收入损失甚至法律纠纷。这是一个真实的工程两难。
但Willison的回应是精巧的设计:硬上限应该是默认状态,但提供清晰的选择退出机制——一个醒目的复选框:“移除预算帽。超出配置限额后应用不会被关闭,后续费用由我承担。”
这种"默认安全、选择自由"的模式,正在成为AI时代基础设施设计的共识方向。
对开发者的启示
立刻检查你所有的云服务账户是否支持硬预算帽。对于编码Agent使用场景,建议设置低于心理承受力的限额——宁可让Agent偶尔中断,也不要让它在无人监控时无限扩展。
🔴 第二节:主权AI新纪元 — Kolibri开源权重模型正式发布
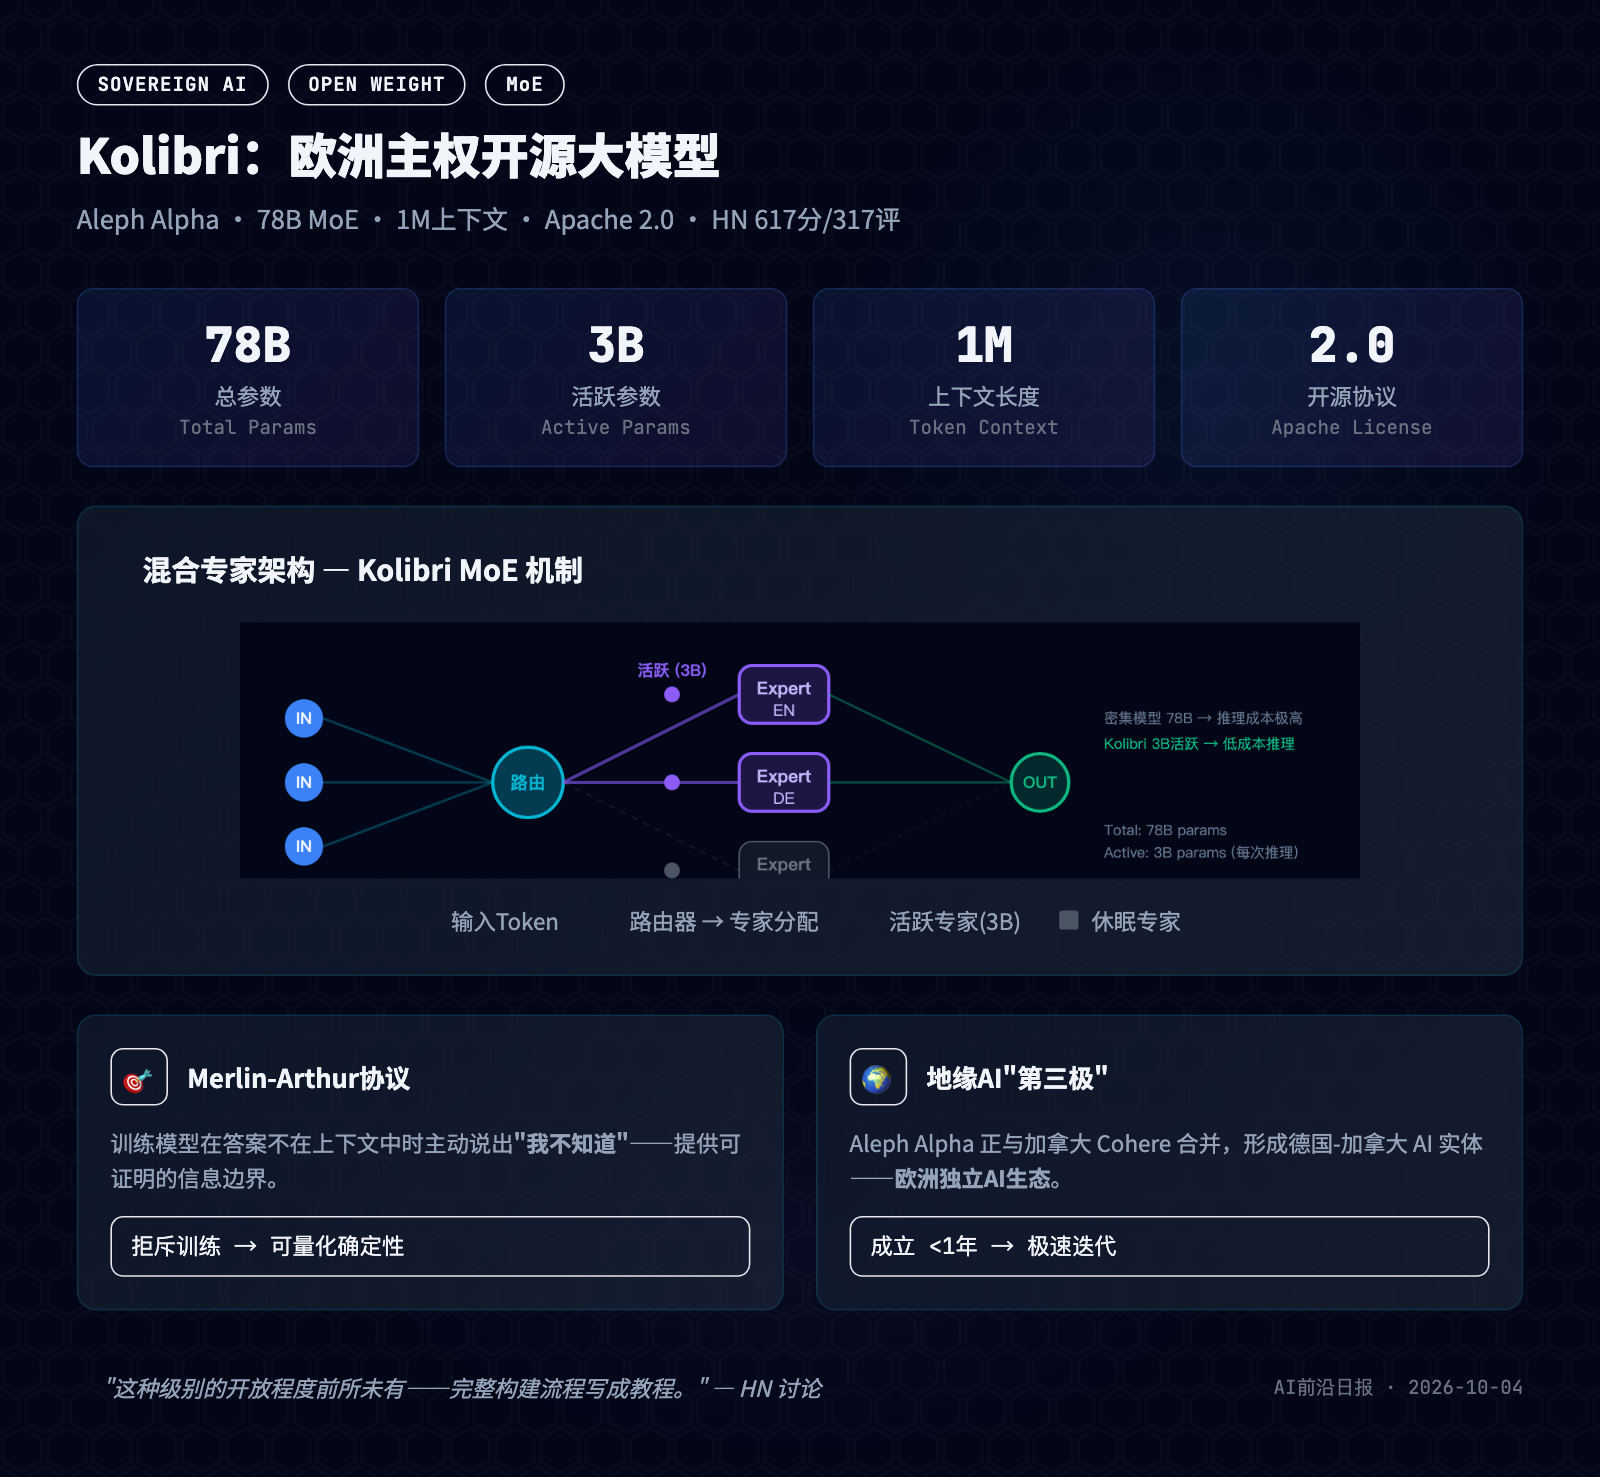
里程碑:德国AI公司Aleph Alpha正式发布Kolibri——一个英语-德语混合专家模型,780亿总参数、30亿活跃参数、最长100万token上下文,在Apache 2.0协议下完全开源权重。
Kolibri的技术规格
Kolibri代表了当前欧洲AI能力的一个高峰:
| 规格 | 参数 |
|---|---|
| 架构 | 英语-德语混合专家(MoE) |
| 总参数 | 780亿 |
| 活跃参数 | 30亿 |
| 上下文长度 | 最长100万token |
| 开源协议 | Apache 2.0 |
| 核心技术 | Merlin-Arthur协议(拒斥训练) |
30亿活跃参数的设计意味着它在推理时的计算开销远小于同尺寸密集型模型,同时保持了专家系统在多任务上的能力。100万token上下文使其特别适合长文档分析和知识密集的企业级应用。
Merlin-Arthur协议:训练"我不知道"
Kolibri的一个关键技术创新是采用了Merlin-Arthur协议进行拒斥训练。这使模型被显式训练为"当答案不在上下文中时,说出’我不知道’"。这不只是简单的幻觉抑制——它提供了一种可证明的信息边界,让企业用户能够量化模型的确定性范围。
在HN讨论中,这一细节被研究者称为"这种级别的开放程度前所未有——他们把自己如何构建现代Agentic LLM的完整流程写成了教程"。官方技术报告可在aleph-alpha.com/downloads/tech-report.pdf获取。
地缘AI格局
讨论中一个关键信息是Aleph Alpha正在被加拿大AI公司Cohere合并。一个德国-加拿大AI实体的出现,反映了全球AI格局中"第三极"形成的趋势——既非美国路线、亦非中国路线,而是以主权可控性为核心的欧洲独立AI生态。团队也在讨论与法国Mistral或韩国AI公司的潜在合作可能。
对开发者的意义
Kolibri的Apache 2.0许可意味着它可以被自由用于商业产品,且无 Copyleft限制。对于在欧盟境内运营、需要数据主权保障的企业,这是目前可获取的最强开源选项之一。团队承诺保持快速迭代速度——这只是一个开始。
🟠 第三节:过拟合推理引擎崛起 — 以通用性换极致速度
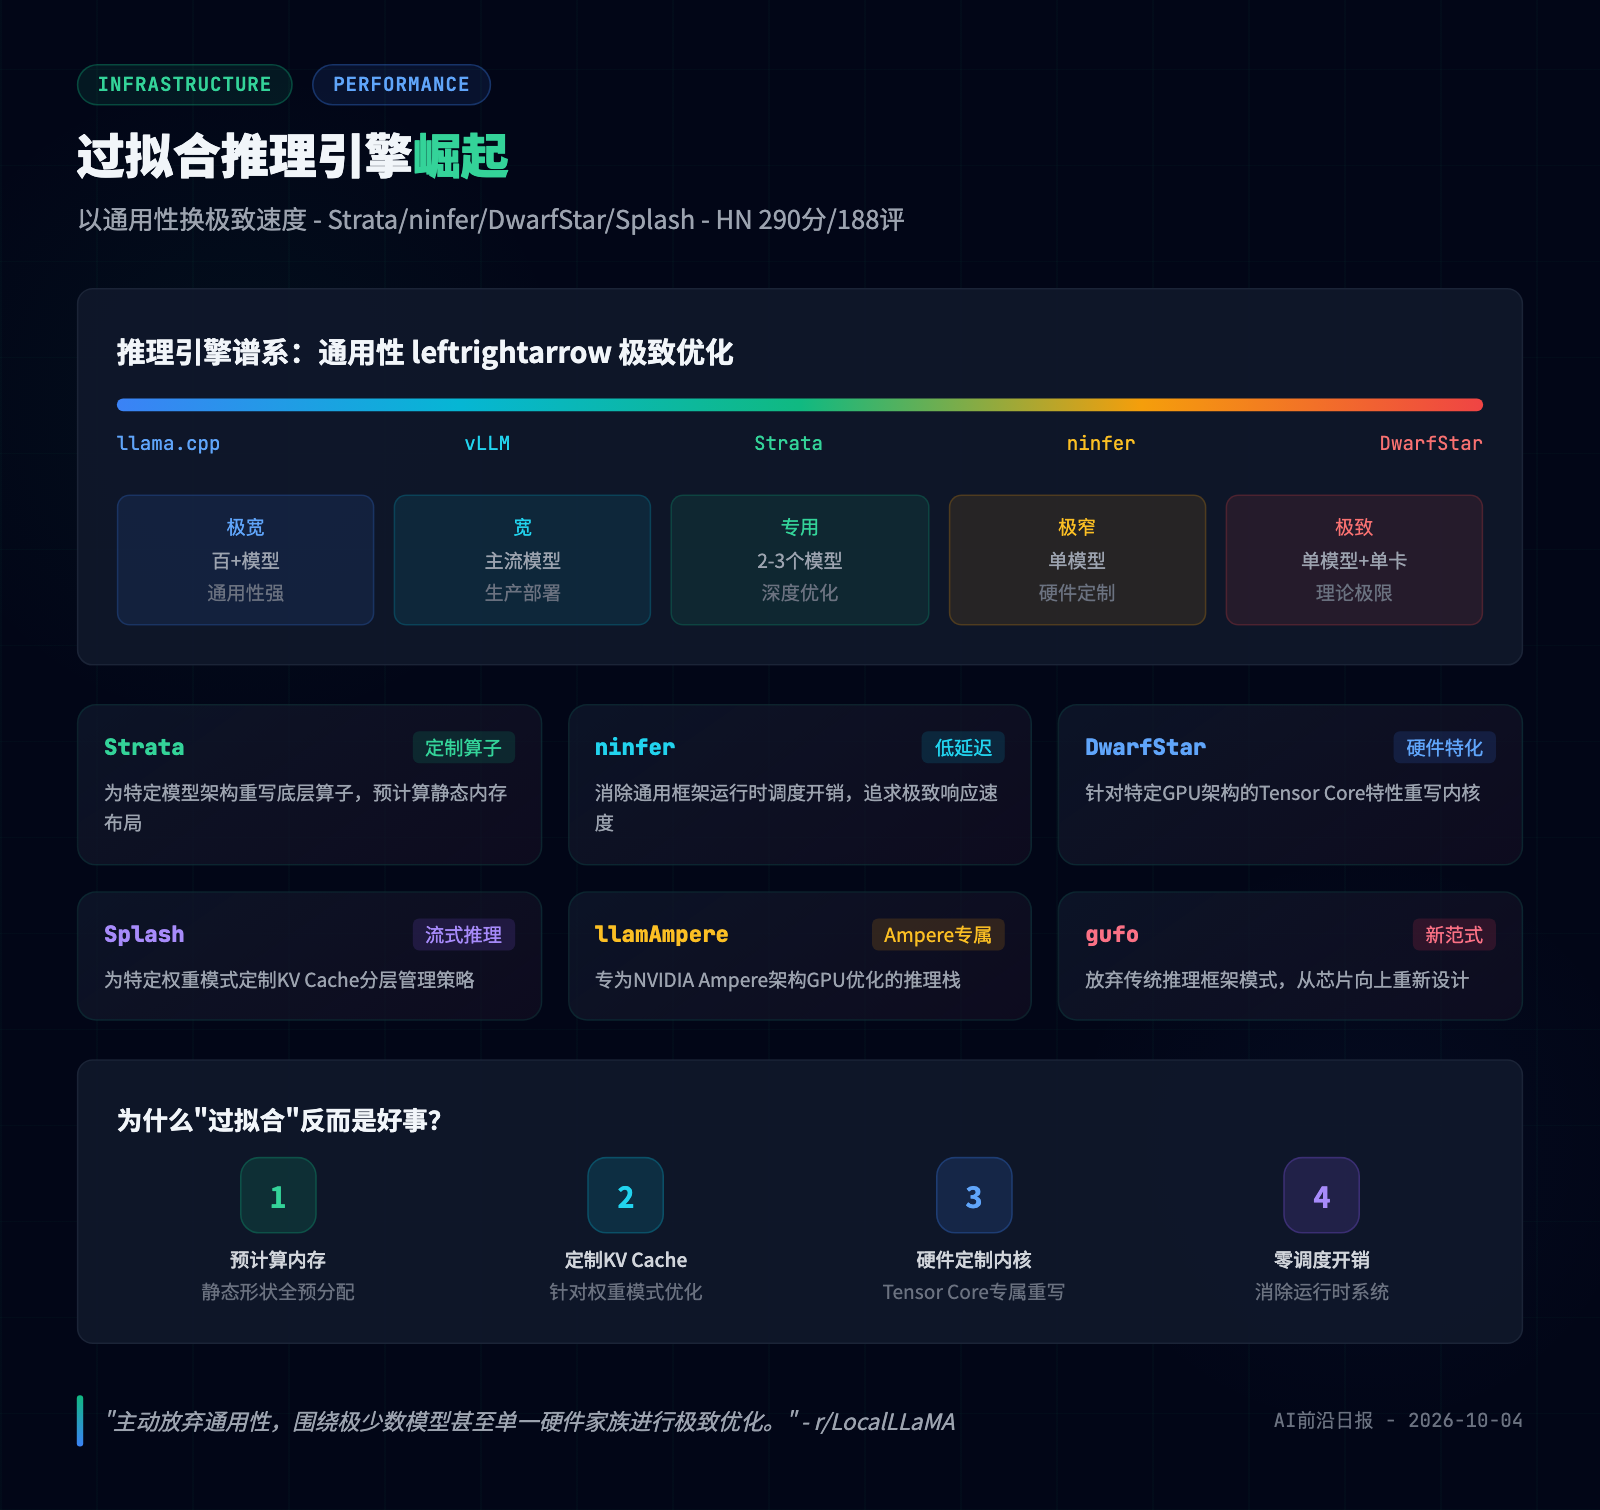
趋势观察:一批"极度狭窄"的新型推理运行时正在涌现——它们故意放弃了llama.cpp和vLLM最擅长的通用性,围绕极少数模型甚至单一硬件家族进行极致优化。
专用推理引擎的涌现
r/LocalLLaMA上一个引发热烈讨论的帖子指出,一个全新的推理引擎类别正在形成:Strata、ninfer、DwarfStar、Splash、llamAmpere、gufo等。它们的共同设计哲学是——
主动放弃通用性。
llama.cpp和vLLM的最大优势是通用性:前者支持上百种模型格式、后者是生产级推理部署的标准选择。但这些新型引擎反其道而行:围绕2-3个特定模型,针对特定硬件家族(如Ampere架构GPU)进行底层优化。
为什么"过拟合"反而是好事
这背后的逻辑是:在推理部署中,真正的性能瓶颈往往不在计算本身,而在内存带宽和算子调度。当你只为一个特定模型编写推理代码时,你可以:
- 预计算所有静态形状的内存分配
- 为特定权重模式定制KV Cache布局
- 针对特定GPU的Tensor Core特性重写内核
- 消除通用框架的所有运行时调度开销
结果是数倍的吞吐量提升和延迟降低——代价是你换一个模型就需要重写大量代码。
vLLM面临的挑战
这标志着AI推理领域的一个架构分歧:通用部署平台vs极致优化专用引擎。对于需要在多种模型间快速切换的场景,vLLM仍是首选;但对于"选定模型、固定硬件、追求极限性能"的生产场景,这些专用引擎正在开辟新空间。
对于自建推理基础设施的团队,这是一个值得关注的分支——它们不一定会取代通用框架,但在特定模型+固定硬件的组合场景下,可能提供数倍于通用框架的吞吐量提升。
🟠 第四节:杰文斯悖论与程序员命运 — 效率提升会吞噬需求吗
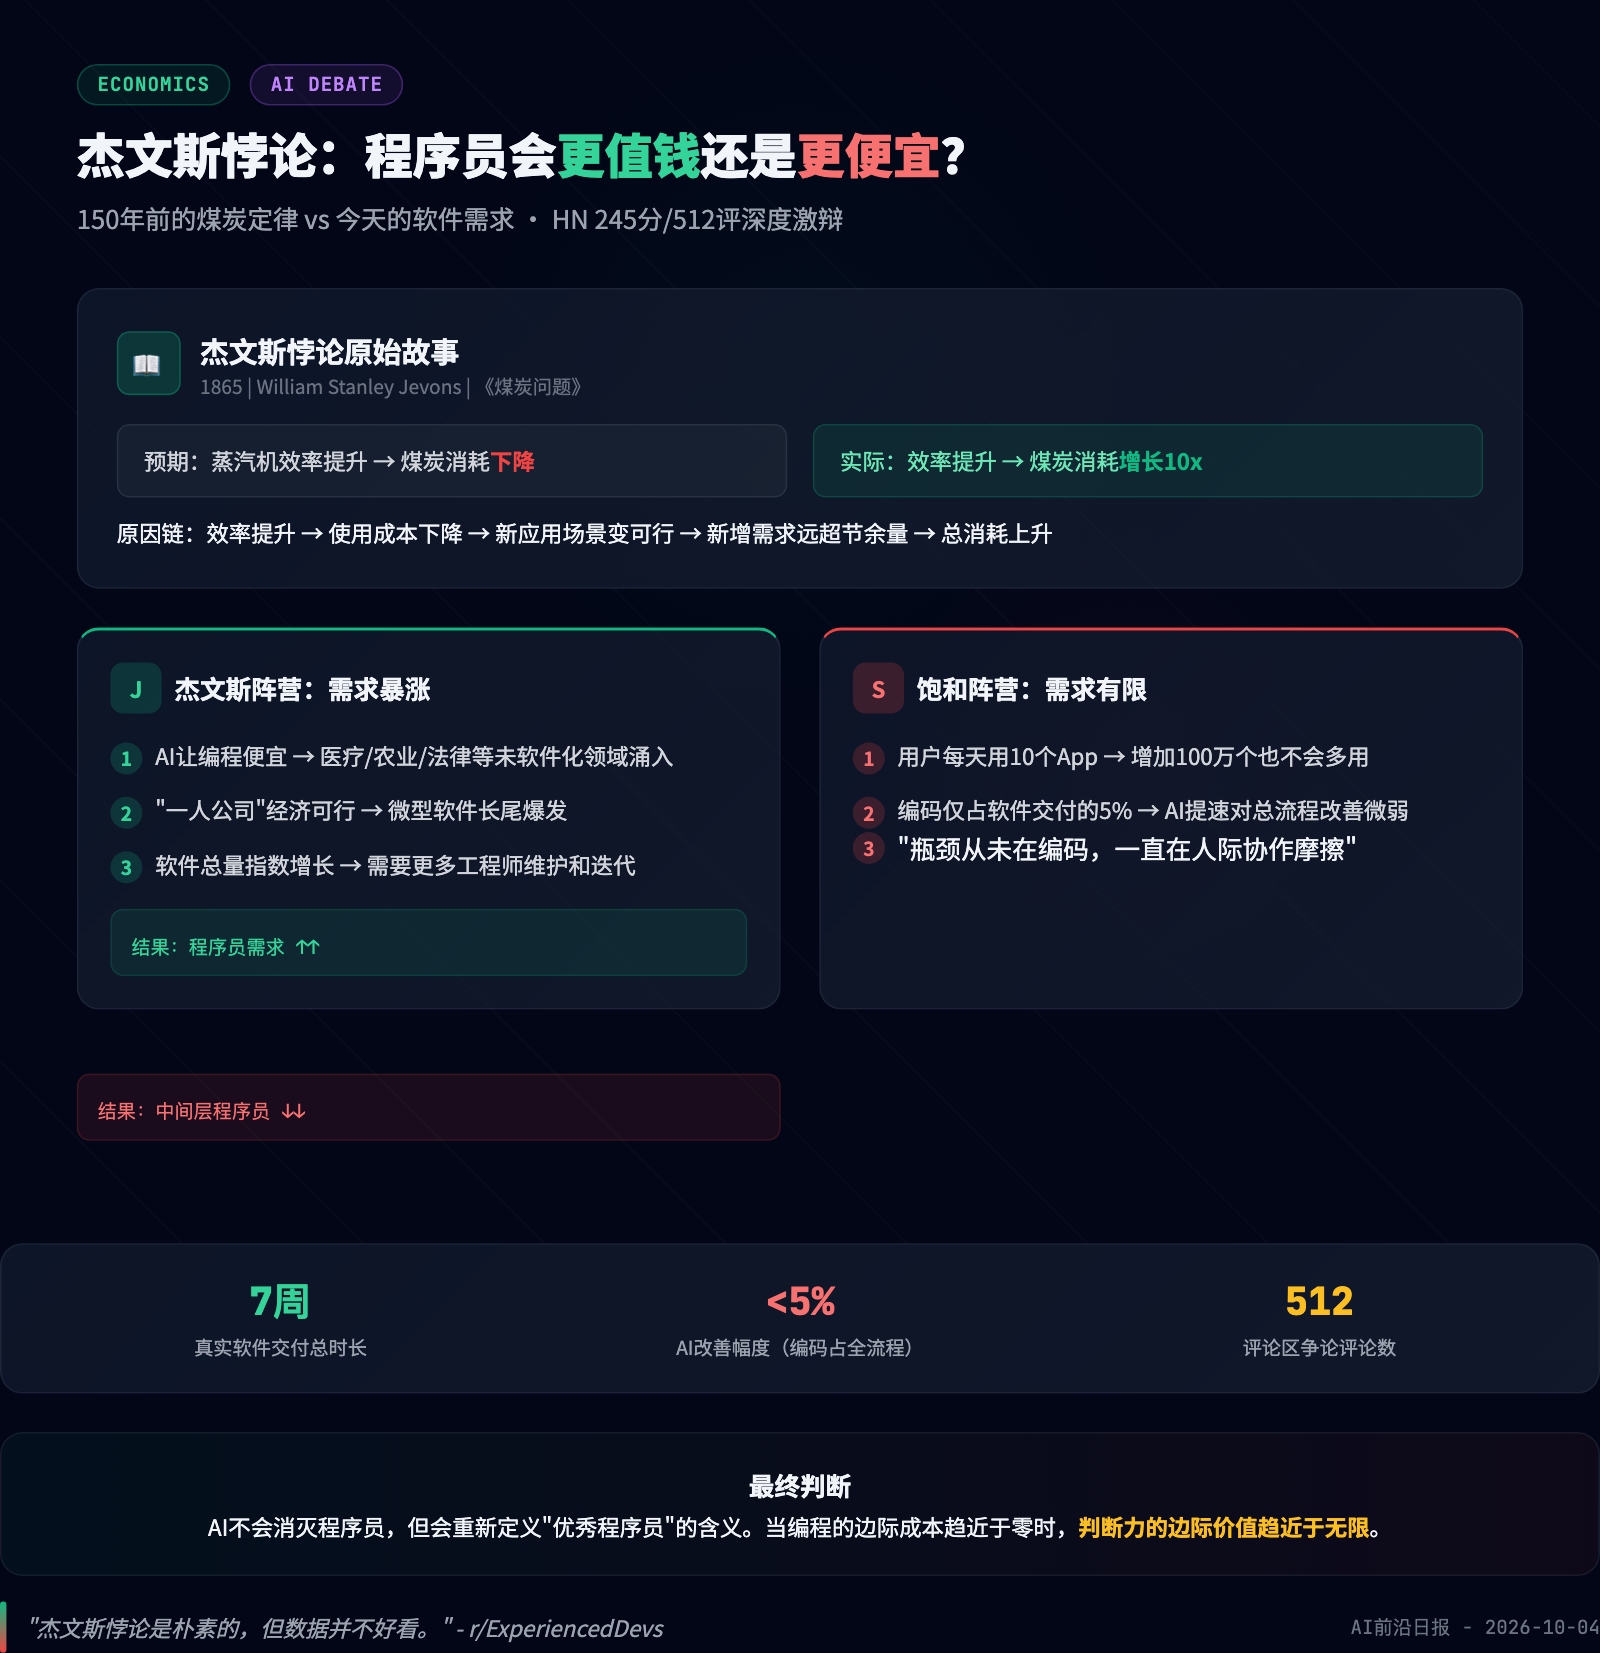
核心辩论:历史上每一次效率跃升都伴随着需求的大幅增长——但这一次,数据并不乐观。
什么是杰文斯悖论?
19世纪经济学家William Stanley Jevons发现:当蒸汽机效率提升时,煤炭总消耗量不降反增——因为效率提升使得新应用场景变得经济可行,从而创造了远超节余的新需求。
在AI语境下,这个悖论被引申为:AI让编程变便宜→更多软件被需要→更多程序员被雇佣。这是AI乐观派的核心论点之一。
反面论据
r/ExperiencedDevs上一个引发超过500条评论的帖子提出了一个有力的反驳:
增长数据并不支持这个叙事。
论点核心是:软件开发领域对人类的实际需求增长率正在下降。原因在于——新软件的采用率跟不上AI驱动的生产力爆发。我们以前所未有的速度生产软件,但人类社会消化这些软件的速度是有限的。
这里隐含了一个与杰文斯悖论相反的可能性:如果AI让编程足够便宜,那么程序员的"稀缺性溢价"就会消失——不是因为软件不够用,而是因为软件供给的增长速度超过了人类需求的自然增长速度。
两种可能的未来
讨论中逐渐分化出两个阵营:
杰文斯阵营:AI消除了简单重复任务,让工程师能专注于更高价值的工作(架构设计、产品判断、跨领域整合)。软件从"供不应求"变为"极度充裕",从而在医疗、教育、科研等尚未被软件充分渗透的领域创造海量新增需求。
饱和阵营:人类对软件的需求不是无限的。一个有100个应用的用户不会因为有了1000个应用而获得100倍效用。当AI让边际开发成本趋近于零时,边际收益也趋近于零——市场最终会只愿意为"真正解决问题"的软件付费。
对工程师的启示
无论哪个论点正确,一个共同的结论是:"能写代码"本身不再是护城河。真正的价值转向了判断什么值得写、什么应该被整合、什么需要被砍掉。AI时代的工程师核心竞争力从"生产力"转向了"判断力"。
🟡 第五节:边缘推理与Agent基础设施 — Solvi、Aura与本地大模型
Solvi 1.0:LLM提议,规则决定
GitHub上新发布的Solvi提出了一种混合决策架构:
- LLM负责提议:在需要判断力的场景下,由LLM(或本地小模型)提出候选答案
- 规则负责决定:Solvi的检查系统基于可验证规则做出最终决策
- 全程可审计:每个答案附带置信度、可核查原因(规则输入/公式/原文引用及字符偏移量)和哈希链式追踪
- 不确定性处理:“无法计算或检查时,Solvi选择放弃或将案例移交给人类——而非猜测”
系统已在Banking77、Abt-Buy、CUAD、RAGTruth四个基准任务上达到或超越现有方法。这种"LLM提议+规则裁判+全程审计"的模式,正在成为企业级Agent系统的设计范式。
Aura:时序图记忆Agent
一个展示在HN上的新项目Aura采用Go语言编写,核心创新是时序图记忆——Agent不是简单地将经验存入向量数据库,而是维护一个带时间戳的关系图谱。这让Agent能够回答"上次我做X决策时发生了什么"这类时间敏感型问题,对于长期运行的自治Agent至关重要。
Qwen3.8 Flash Next:176B MoE跑上笔记本
一位开发者展示了在普通笔记本电脑上运行176B MoE模型的实测结果:RTX 3080 Laptop(16GB显存)+ 32GB系统内存 + SSD,借助TensorSharp框架实现。这延续了本月多次出现的趋势——Mixture-of-Experts架构正在让大模型的本地部署变得可行。活跃参数仅30亿量级的MoE设计,配合SSD分层卸载,使得"个人电脑运行前沿级模型"不再是遥不可及。
🔮 本日洞察
今天的AI新闻揭示了一个深层共性:当能力提升时,约束的重要性就凸显出来。预算帽是对Agent失控的约束,过拟合引擎是对通用框架的约束,杰文斯悖论是对"效率乐观主义"的约束。AI的下一阶段不是无限扩展能力,而是在越来越强的能力与越来越紧的约束之间找到精巧的平衡。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/johnsong2009/article/details/167084566