
Hill Climbing Loop
1、引言
小屌丝:鱼哥,我那 Agent 上线仨月了。刚上线的时候爽得不行,写东西又快又准。结果最近我越用越不对劲——同样是写周报,上周它开始把"同比"写成"环比",昨天连"DAU"是啥都不知道了。
小鱼:(喝了口茶)你换模型了?
小屌丝:没换啊,还是那 gpt-5。我还专门把系统提示词原样复制回来对了一遍,一个字没动。
小鱼:兄弟,这不是模型变蠢了,是你的世界变了。用户输入分布在变、数据在变、工具返回格式在变,你那套三个月前调优的 Prompt 当然就慢慢退化了。这就是为什么光有前三个 Loop 不够——你得有一个 Loop,专门盯着 Agent 自己,把它越用越聪明。
小屌丝:你的意思是……让 Agent 自己改自己?
小鱼:对,Hill Climbing Loop。名字来自爬山算法:每次看一眼当前在哪,往高的方向迈一步,重复。对应到 Agent 上就是——跑一批任务,把每一步的 Trace 记下来,分析哪里出错了,针对性地改 Prompt、改工具、改记忆、改流程,然后再跑一批看是不是真的变好了。
小屌丝:听着就费钱。我总不能天天人工看 Trace 吧?
小鱼:2026 年不用你看。Trace 系统自动拉、失败自动聚类、优化器自动搜更好的 Prompt,你只需要在它上线前点个"批准"。今天这是本系列收官,我给你把这套"AI 优化 AI"的闭环讲清楚。
2、Hill Climbing Loop 到底在爬什么山?
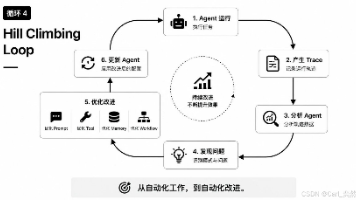
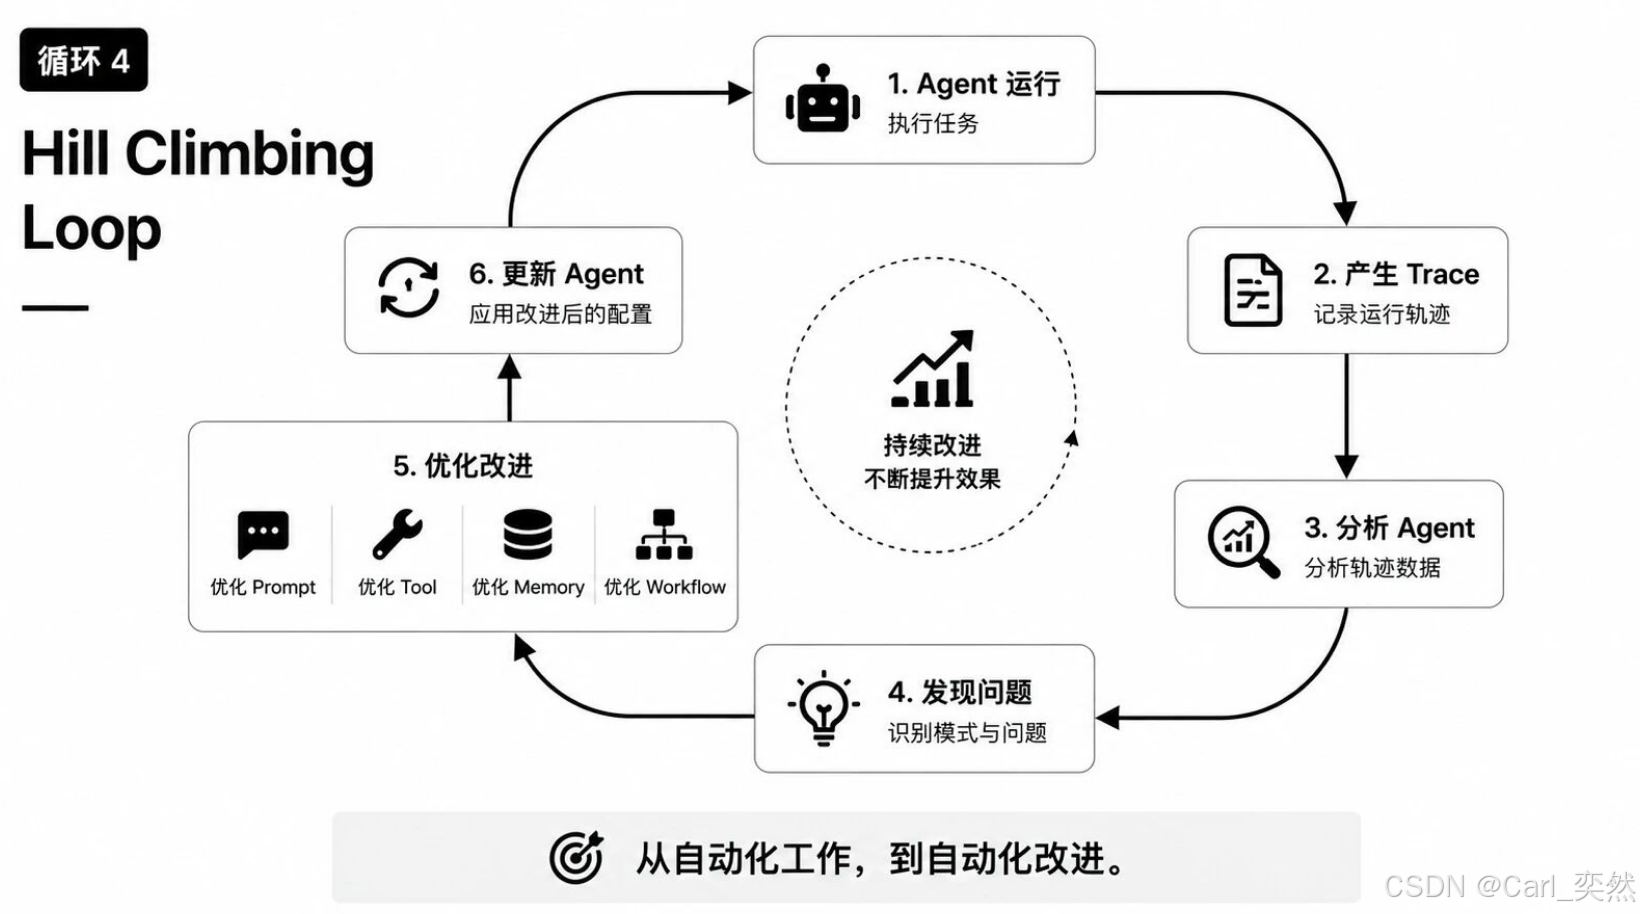
对应素材里的"循环 4",六个步骤转成一个环:
        ┌──────────────────────────────────────────┐
        ↓                                          │
   1. Agent 运行(执行任务)                        │
        ↓                                          │
   2. 产生 Trace(每一步都记录)                    │
        ↓                                          │
   3. 分析 Trace(统计指标、失败率)                 │
        ↓                                          │
   4. 发现问题(聚类、定位根因)                    │
        ↓                                          │
   5. 优化改进 ──┬─ 优化 Prompt                     │
                ├─ 优化 Tool                       │
                ├─ 优化 Memory                     │
                └─ 优化 Workflow                   │
        ↓                                          │
   6. 更新 Agent(应用新配置) ────────────────────┘
它跟前三个 Loop 的分工:
| Loop | 关心的问题 | 时间尺度 |
|---|---|---|
| Agent Loop | 这一次任务怎么干完 | 秒~分钟 |
| Verification Loop | 这一次产出能不能用 | 秒~分钟 |
| Event-Driven Loop | 谁来触发、怎么写回外部世界 | 分钟~小时 |
| Hill Climbing Loop | 这个 Agent 整体怎么越变越好 | 天~周 |
前三个 Loop 让系统"跑起来",Hill Climbing Loop 让系统"跑上去"。这就是素材里那句 slogan 的分量:
下一代软件的核心竞争力,不是模型,而是循环。 而 Hill Climbing Loop,是那个让循环本身不断变强的元循环。
一句话总结:Hill Climbing Loop = Trace 数据 → 失败诊断 → 四维优化(Prompt/Tool/Memory/Workflow)→ 灰度上线 → 再 Trace,让 Agent 从"自动化工作"进化到"自动化改进"。
3、Hill Climbing Loop 核心原理
3.1 六步闭环:Trace → 分析 → 诊断 → 优化 → 上线 → 再 Trace
这六步里,前三步是"看清楚病",后三步是"开药方"。
1)Agent 运行:就是第 1 篇那个 Agent Loop,只不过每一步都被完整记录。
2)产生 Trace:每一次工具调用、每一段 Thought、每一个 Observation、每次 retry、每次 grader 打分,全部结构化落库。2026 年这一层基本被 LangSmith / Langfuse / OpenTelemetry GenAI Semantic Conventions 标准化了,你只要在代码里加几行 decorator,不用自己写存储。
3)分析 Trace:看几个核心指标——任务成功率、平均步数、平均 token 成本、各工具调用失败率、grader 通过率、人工接管率。哪个指标掉了,问题就出在哪。
4)发现问题:把失败的 case 拉出来,不是一个一个看,而是聚类——“哦,最近 30 个失败里有 22 个都是工具 search 返回了空结果,然后 Agent 硬编了一个答案”。根因一聚类,优化方向就出来了。
5)优化改进:四个抓手,下面单独讲。
6)更新 Agent:改完不能直接全量上线,要先在 golden dataset 上回归,再灰度 10% 流量,观察一天指标,没问题再全量。
3.2 优化的四个抓手:Prompt / Tool / Memory / Workflow
| 抓手 | 什么时候动它 | 典型动作 |
|---|---|---|
| Prompt | 模型理解错了任务、格式漂移、语气不对 | 加 few-shot 例子、改系统提示、拆指令 |
| Tool | 工具调用参数错、选错工具、工具返回没用 | 改工具描述、加参数校验、拆/合并工具 |
| Memory | 长任务里忘事、跨会话记不住用户偏好 | 改记忆摘要策略、改检索 top-k、改过期策略 |
| Workflow | 单 Loop 兜不住、步骤顺序错了 | 加 Plan-and-Execute 子图、加 HITL 节点、加并行分支 |
一个经验法则:先动 Prompt(最便宜),再动 Tool(次便宜),再动 Memory(要数据),最后才动 Workflow(最贵)。 一上来就重构图,往往是没看清病就开刀。
4、生产级实现(Trace 分析 + DSPy 自动优化)
下面这套骨架展示"自动优化 Prompt"这一段——其他三个抓手思路类似,只是改的对象不同。
# hill_climbing_loop.py
"""
Hill Climbing Loop 骨架:
1. 从 Trace 系统拉一批失败 case
2. 聚类,挑出最高频的失败模式
3. 用 DSPy 优化器在 golden dataset 上自动搜更好的 Prompt
4. 跑回归,过了才把新 Prompt 推到 Prompt Hub
"""
from datetime import datetime, timedelta
from collections import Counter

# ---------- 1. 拉最近 7 天失败的 Trace ----------
def pull_failed_traces(days: int = 7):
    # 真实项目里替换成 langsmith.list_runs / langfuse.client
    since = datetime.utcnow() - timedelta(days=days)
    runs = trace_client.list_runs(
        filter={"status": "error", "started_at": {"gte": since}},
        limit=500,
    )
    return runs

# ---------- 2. 失败聚类:按"最后一次工具调用 + 报错信息"分桶 ----------
def cluster_failures(runs: list[dict]) -> Counter:
    buckets = Counter()
    for r in runs:
        last_tool = r.get("last_tool_call", "unknown")
        err_type = classify_error(r.get("error", ""))   # 用小模型分个类
        buckets[(last_tool, err_type)] += 1
    return buckets
    # 典型输出:
    # {("search", "empty_result_then_hallucinate"): 22,
    #  ("db.query", "wrong_parameter_type"): 8, ...}

# ---------- 3. 拿最高频的那一类,构造优化集 ----------
def build_golden_set(top_cluster, runs):
    # 把这类失败 case 变成 (输入, 期望输出) 的评测集
    return [
        dspy.Example(input=r["input"], expected=r["golden_output"])
        for r in runs if belongs_to(r, top_cluster)
    ].with_inputs("input")

# ---------- 4. 用 DSPy 优化器自动搜 Prompt(MIPRO / GEPA 思路) ----------
def optimize_prompt(golden_set, student_module):
    import dspy
    # 优化器不是让你写 Prompt,而是给它几个候选指令种子,
    # 它自动组合 few-shot 例子 + 指令,在 golden_set 上挑最优。
    optimizer = dspy.MIPROv2(metric=rubric_metric, auto="light")
    optimized = optimizer.compile(
        student_module,
        trainset=golden_set,
        valset=golden_set[:30],
    )
    return optimized

# ---------- 5. 回归:新 Prompt 不能把别的 case 改崩 ----------
def regression_test(new_program, full_eval_set):
    score_new = evaluate(new_program, full_eval_set)
    score_old = evaluate(prod_program, full_eval_set)
    # 硬规则:新方案在目标聚类上必须提升,且在全集上不能倒退超过 1%
    if score_new.target_cluster >= score_old.target_cluster + 0.05 \
       and score_new.overall >= score_old.overall - 0.01:
        return True
    return False

# ---------- 6. 推上线(灰度) ----------
def rollout(new_program):
    prompt_hub.publish(
        name="issue_triage_agent_prompt",
        body=new_program.dump_jinja2(),
        tags=["candidate"],
    )
    # 接 10% 灰度流量,观察 24h 指标,人工批准后全量

if __name__ == "__main__":
    runs = pull_failed_traces(7)
    clusters = cluster_failures(runs)
    top = clusters.most_common(1)[0][0]
    gold = build_golden_set(top, runs)
    new_prog = optimize_prompt(gold, student_module=...)
    if regression_test(new_prog, full_eval_set):
        rollout(new_prog)
这套东西在 2026 年已经是很多 AI 团队的"周会仪式":每周一自动跑一遍,本周哪个失败模式最高、优化器找到什么新 Prompt、回归过没过,全部自动出报告。人只做最后一步批准。
5、2026 年的关键改进点
5.1 从"人肉改 Prompt"到"优化器搜 Prompt"
2024 年调 Agent 就是个玄学:产品经理说"再加一句’要严谨’“,工程师说"加个 few-shot 吧”,上线一看,哎好像好点了。
2026 年的做法是把 Prompt 当超参数来搜:
- DSPy:把 Prompt 写成 Python 模块,优化器(MIPROv2 / GEPA)自动搜指令和 few-shot;
- PromptHub 版本管理:每个 Prompt 像 Git commit 一样有版本、有 diff、有对应的 eval 分数;
- 自动 few-shot 选择:来了一个新 case,从历史成功案例里自动挑最像的 2–3 个塞进上下文,比手写固定 few-shot 泛化好得多。
人从"写 Prompt 的人"变成"设计 metric 和 dataset 的人"。
5.2 失败聚类:别在一个 case 上改一百遍
新人最容易犯的错:看到一个 case 翻车,就围着这一个 case 改 Prompt,改到它过了,结果另外十个本来能过的 case 被改崩了。
2026 年的标准动作是:
- 拉最近 N 天所有失败 trace;
- 用一个小模型把每个失败归到一个类别(“工具空返回后幻觉”、“参数类型错”、“上下文截断”……);
- 按类别计数,只动最高频的那一两类;
- 改完在全量 golden set 上回归,不允许按下葫芦浮起瓢。
这本质上是把"炼丹"变成"数据驱动"——你优化的不是一个 case,是一个失败分布。
5.3 Golden Dataset 回归:别改好一个 case,改崩十个
没有 golden dataset 的 Prompt 优化就是耍流氓。2026 年的标配:
- Golden Dataset 怎么来:每一次 Verification Loop 里被人工标过的 case、每一次 HITL 里人批准/拒绝的 case、每一次线上被用户差评的 case,全部自动进 golden set;
- 每次改 Prompt / Tool / Memory / Workflow,都必须在 golden set 上跑一遍,整体分数不许掉;
- 灰度上线:新配置先接 5%–10% 流量,盯 24 小时关键指标,没掉再放量;
- 一键回滚:Prompt 是版本化的,出问题秒切回上一个版本。
这一层做扎实了,你才敢让 Hill Climbing Loop 自己跑——因为它就算改错了,也改不出大事。
6、适用场景与性能基准
| 场景 | 推荐度 | 说明 |
|---|---|---|
| 长期运行的生产 Agent | ⭐⭐⭐⭐⭐ | 不上 Hill Climbing,三个月后必然退化 |
| 高频、高价值任务(客服、编码、销售) | ⭐⭐⭐⭐⭐ | 一点点成功率提升都值大钱 |
| 一次性脚本 / PoC | ⭐ | 花在 trace 和 eval 上的成本不划算 |
| 强合规、强审计场景 | ⭐⭐⭐⭐ | 自动优化前必须人审,不能黑盒上线 |
| 模型每周都在换的团队 | ⭐⭐⭐⭐⭐ | 模型一变 Prompt 就得跟着重搜,优化器自动化救命 |
一组 2026 年参考数字:
- Trace 存储成本:约 LLM 调用成本的 5%–15%(结构化后远小于原始日志);
- 每周自动优化一轮,典型成功率提升:3–8 个百分点(基线 ~70% 时);
- DSPy 类优化器一次 compile:跑几百个 eval,成本 $10–$50;
- 回归测试集规模:成熟项目一般 几百到几千条 golden case;
- 从失败聚类到新 Prompt 上线:1–3 天(含灰度观察)。
7、总结(Loop Stack 全景回顾)
四篇写完,把整张图收一下。2026 年的 Agent 系统,底下是四层互相咬合的循环:
        ┌─────────────────────────────┐
  第4层  │  Hill Climbing Loop         │  持续改进:分析 Trace,优化 Prompt/Tool/Memory/Workflow
        │  (AI 优化 AI)              │
        └────────────┬────────────────┘
                     ↑
        ┌────────────┴────────────────┐
  第3层  │  Event-Driven Loop          │  事件驱动:Webhook/Cron/Slack/GitHub 触发,写回真实世界
        │  (AI 融入世界)              │
        └────────────┬────────────────┘
                     ↑
        ┌────────────┴────────────────┐
  第2层  │  Verification Loop         │  验证反馈:LLM as Judge + Rubric + Feedback + Retry
        │  (AI 检查 AI)              │
        └────────────┬────────────────┘
                     ↑
        ┌────────────┴────────────────┐
  第1层  │  Agent Loop                 │  执行任务:观察 → 决策 → 调工具 → 回灌 → 自判完成
        │  (AI 完成任务)             │
        └─────────────────────────────┘
再往上,就是素材里那条演进线:
Prompt → Skill → Workflow → Agent → Loop → Self-Evolving System
模型本身会一年比一年强,但真正拉开差距的,是你在模型外面包了几层循环、这些循环转得有多稳。这就是为什么 2026 年大家开始说:下一代软件的核心竞争力,不是模型,而是循环。
核心记忆点:
- Hill Climbing Loop 是元循环——它不直接干活,它让其他三个 Loop 越变越好;
- 没有 Trace 就没有优化,前三层一定要把每一步结构化记下来;
- 优化顺序:Prompt → Tool → Memory → Workflow,从便宜到贵;
- 失败要聚类着改,别盯着单个 case 调参;
- Golden Dataset + 灰度 + 一键回滚,是敢让 Loop 自动优化的前提;
- 四层 Loop 全转起来,你的系统就从"一个会聊天的模型"长成了"一个会自己进化的软件"。
—— 全系列完 ——
我是小鱼:
- CSDN 博客专家;
- AIGC 技术MVP专家;
- 阿里云 专家博主;
- 51CTO博客专家;
- 企业认证金牌面试官;
- 多个名企认证&特邀讲师等;
- 名企签约职场面试培训、职场规划师;
- 多个国内主流技术社区的认证专家博主;
- 多款主流产品(阿里云等)评测一等奖获得者;
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/wuyoudeyuer/article/details/166735634