
✨作者主页:IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
精彩专栏推荐⬇⬇⬇
Java项目
Python项目
安卓项目
微信小程序项目
一、前言
系统介绍
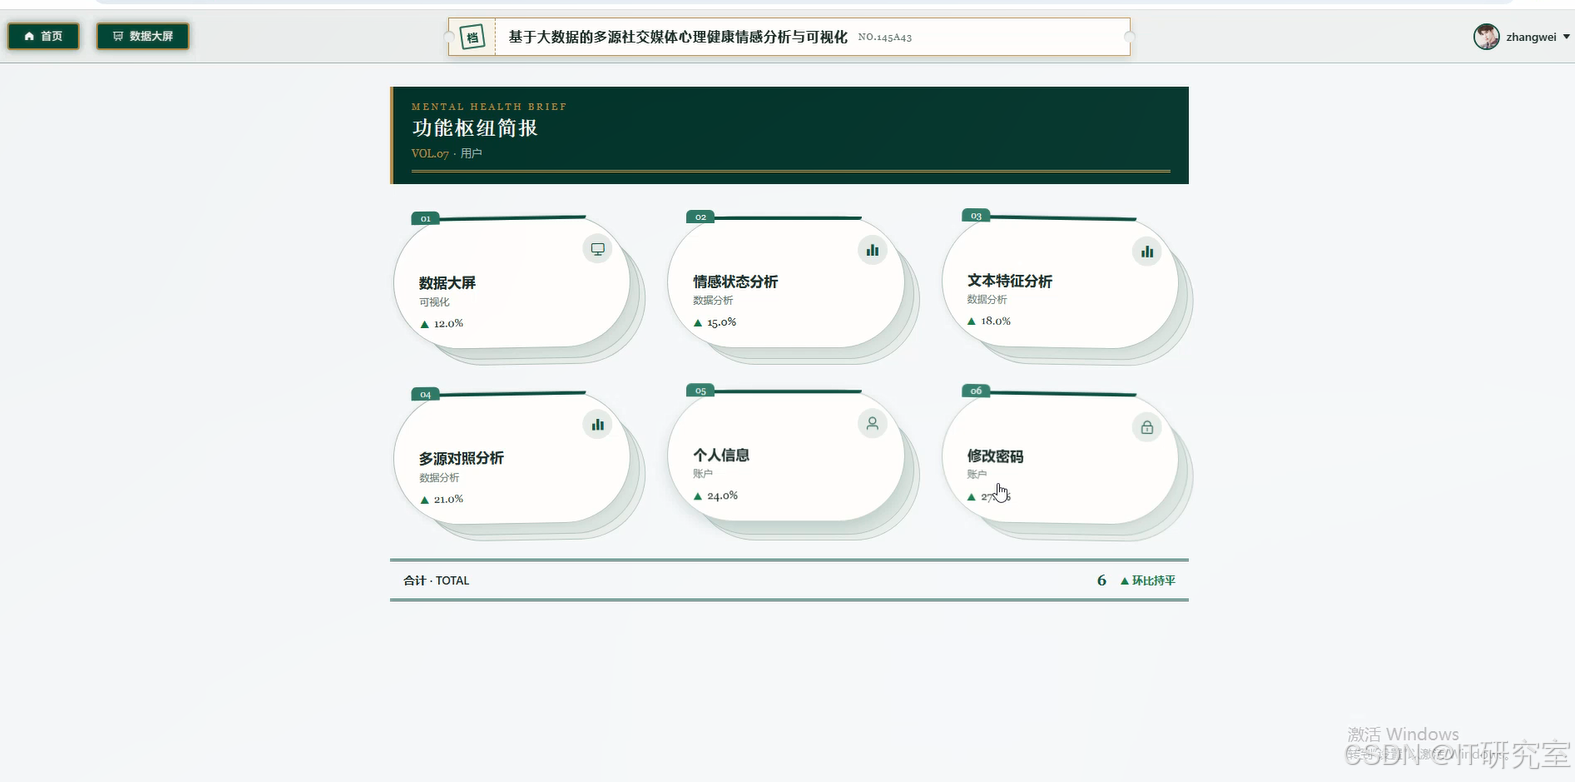
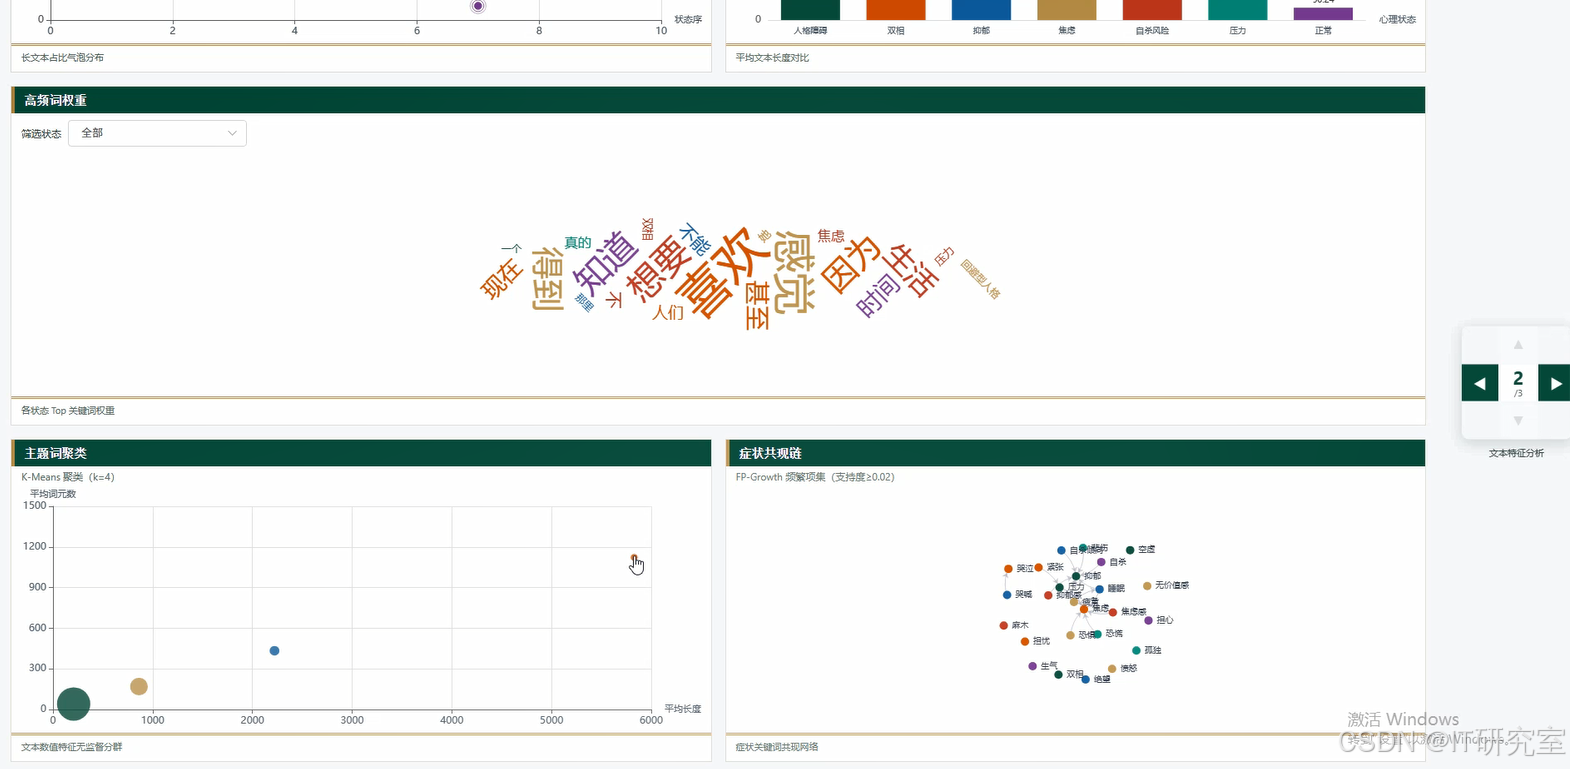
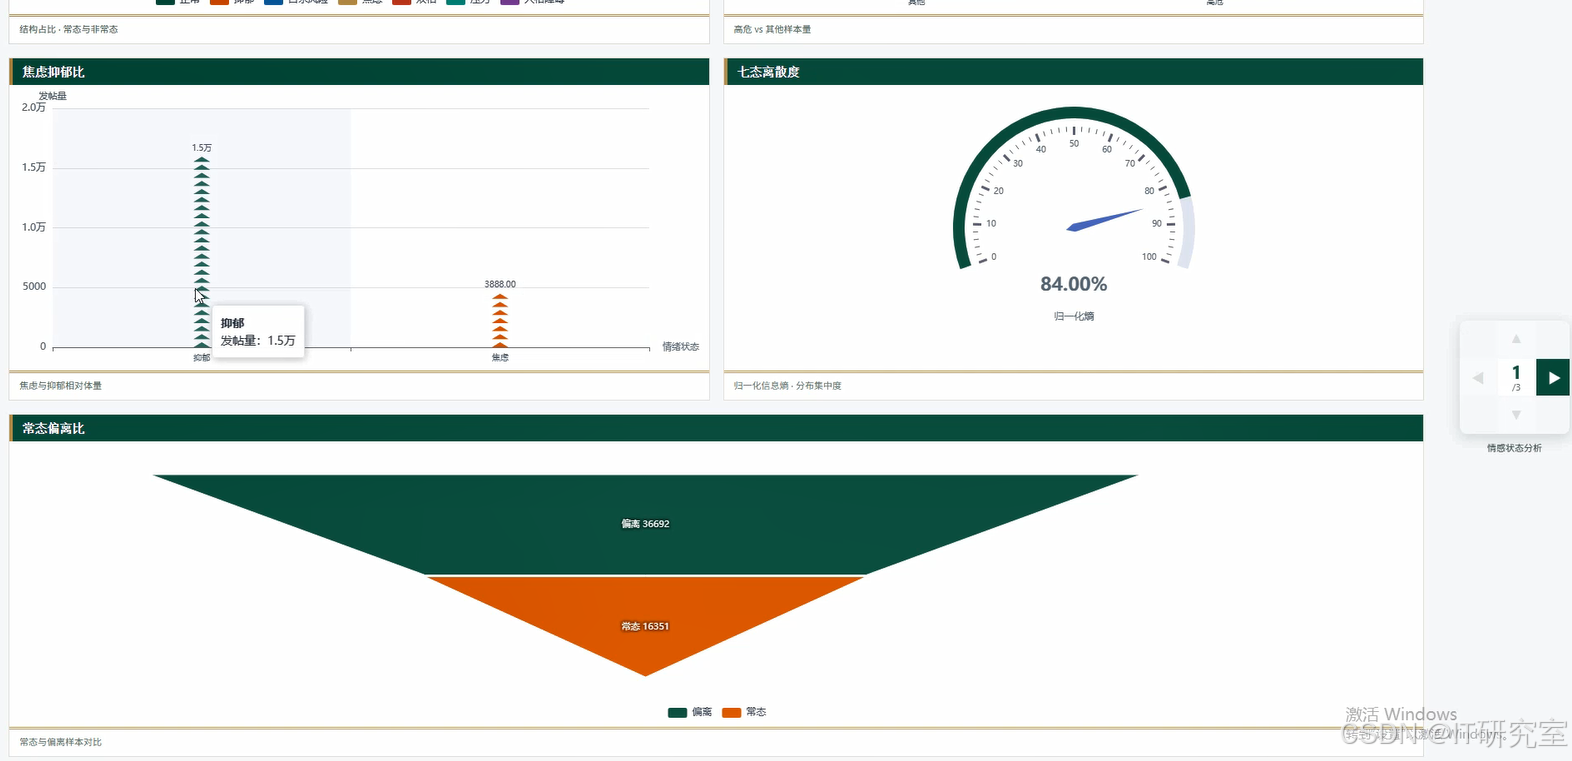
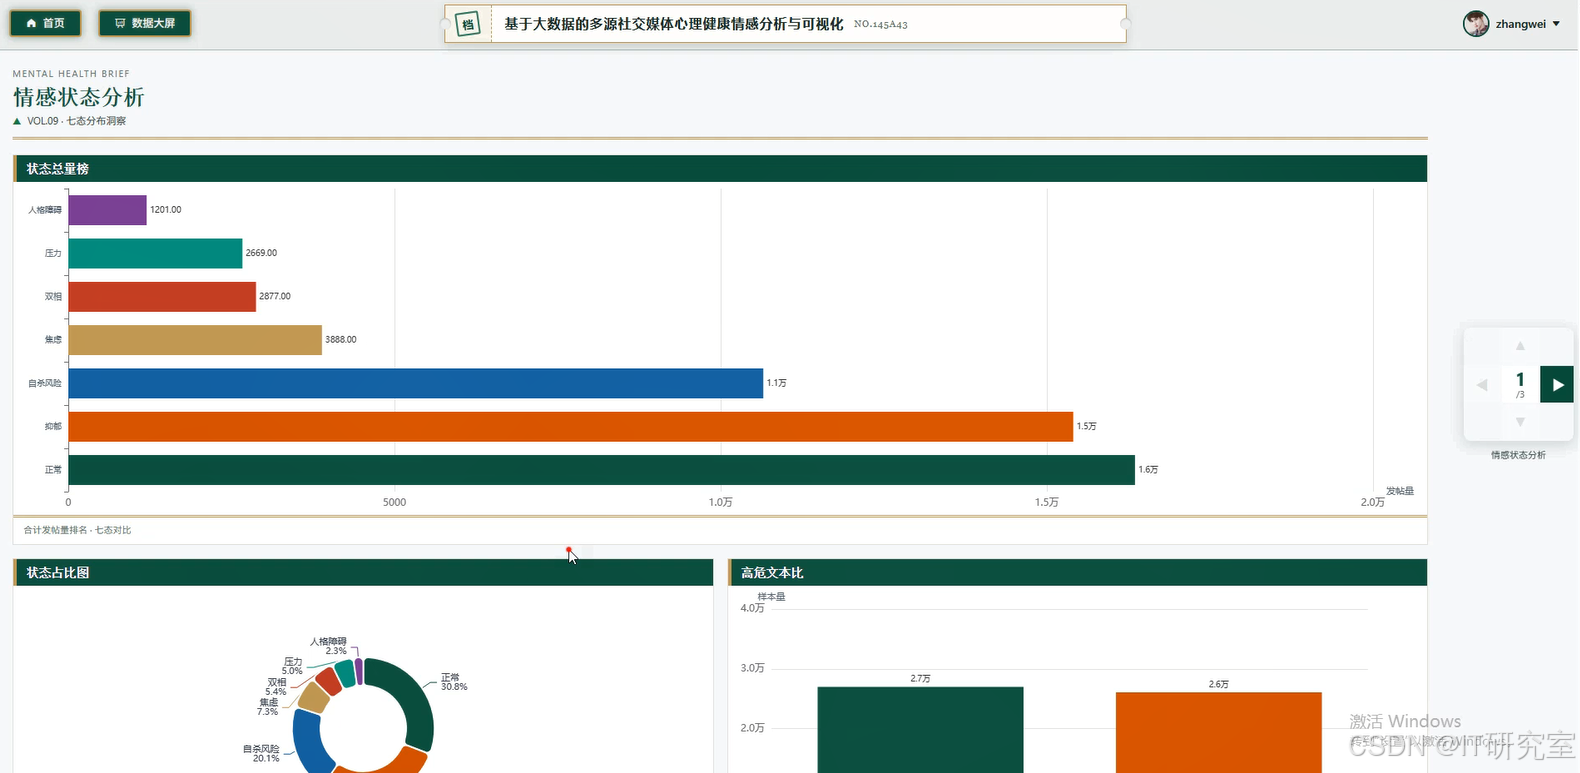
本系统是一个面向心理健康领域的大数据分析平台,核心任务是利用分布式计算技术,对来自微博、知乎、Twitter等多源社交媒体的文本数据进行统一采集、清洗与深度情感分析。系统底层采用Hadoop HDFS实现原始数据的高效分布式存储,借助Spark SQL和Spark Core内置的丰富算子(如filter、map、reduceByKey、join等)完成多源数据关联、文本特征提取与情感极性计算。后端选用Spring Boot框架提供稳定的RESTful API服务,前端基于Vue.js与ECharts构建数据大屏,实现情感状态趋势、文本特征分布、多源对照分析等可视化模块。个人账户与密码管理功能保障用户数据安全。整个系统以“多源对照”为设计亮点,能够对比不同社交媒体平台上同一话题下的情感差异,为心理健康研究者提供数据支撑与决策参考。
选题背景
随着社交媒体深度融入日常生活,人们越来越习惯在微博、知乎、Twitter等平台上表达情绪、分享压力,这些公开文本中蕴含着大量与心理健康状态相关的潜在信息。然而,单平台数据存在样本偏差,传统单机分析工具在处理百万级文本时效率低下,难以满足多源异构数据的整合需求。大数据技术为海量社交媒体情感分析提供了可行路径,借助Hadoop的分布式存储和Spark的内存计算能力,能够高效完成多源数据的采集、清洗、关联与情感计算。当前,面向心理健康领域的多源社交媒体情感分析平台尚不多见,多数研究集中于单一平台或传统机器学习方法,缺乏系统化的工程实现。本课题正是在这一背景下提出,旨在构建一个可落地的多源数据情感分析原型系统,探索大数据技术在心理健康信息挖掘中的应用价值。
选题意义
从实际应用角度看,本系统能够帮助心理健康研究者或社会舆情分析人员快速获取多平台情感数据,减少手动采集与整理的工作量,提高分析效率。通过多源对照分析,可以更客观地观察同一事件或话题在不同社交媒体上的情感差异,避免单平台结论的片面性。从技术训练角度看,本课题覆盖了大数据工程的全流程,包括数据接入、分布式存储、Spark计算、接口开发与可视化呈现,对于理解Hadoop和Spark在实际项目中的协作方式具有明确的实践意义。作为本科毕业设计,本系统不求规模上的宏大,而是力求在大数据技术栈的完整应用和多源数据整合方面做到扎实可用,为后续更深入的研究提供一个清晰、可扩展的基础框架。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
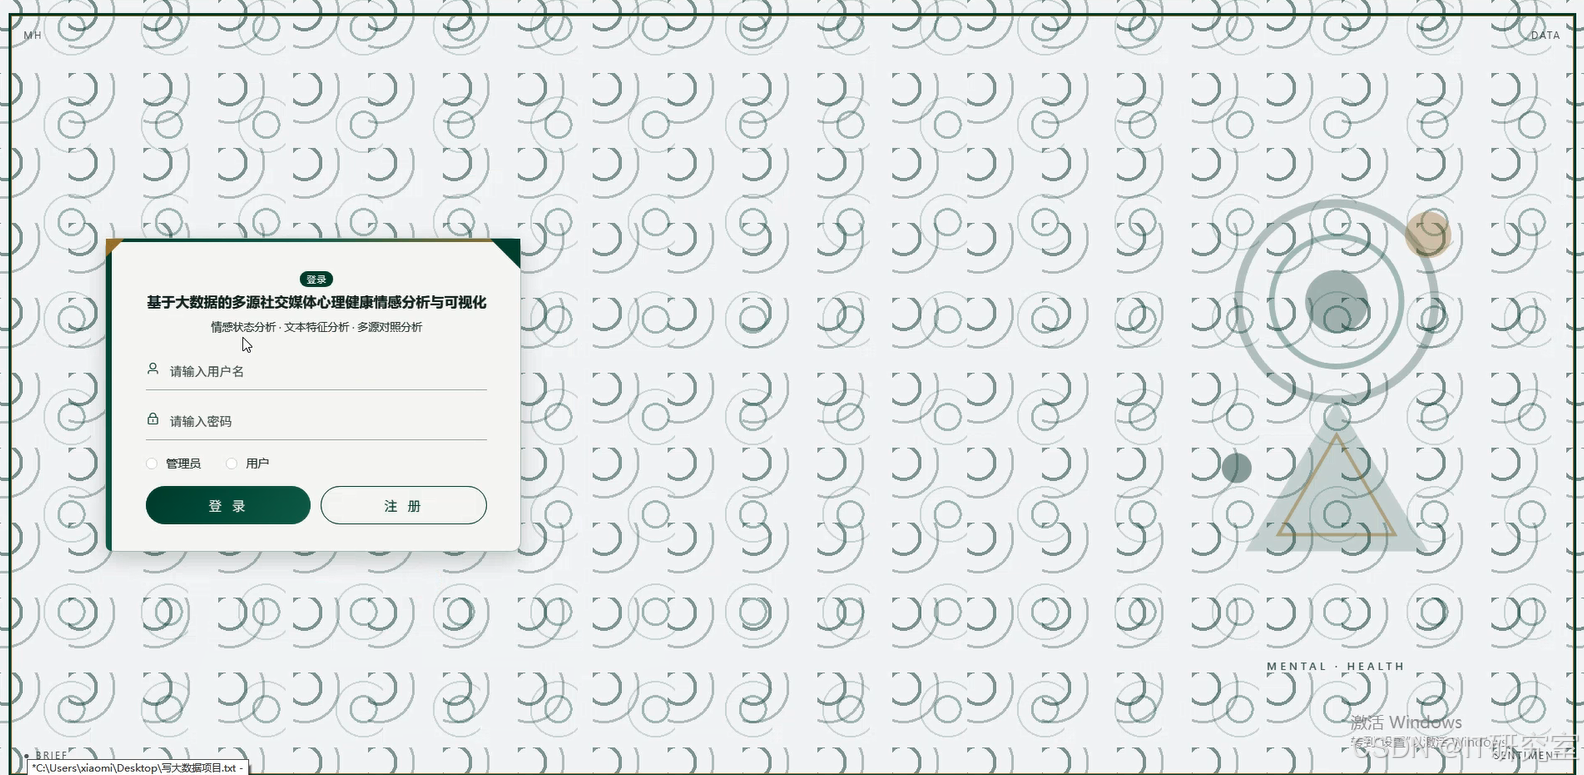
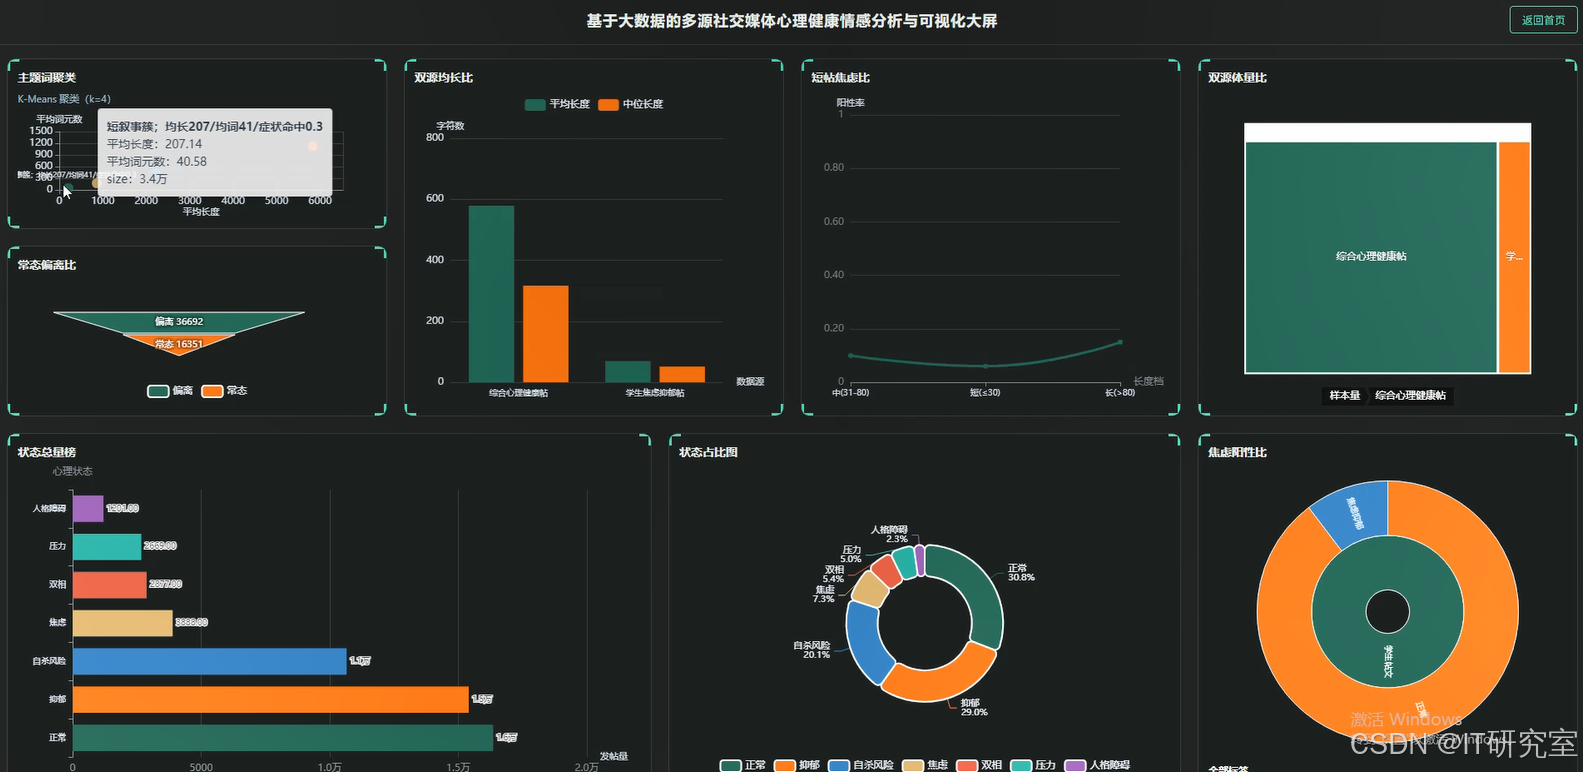
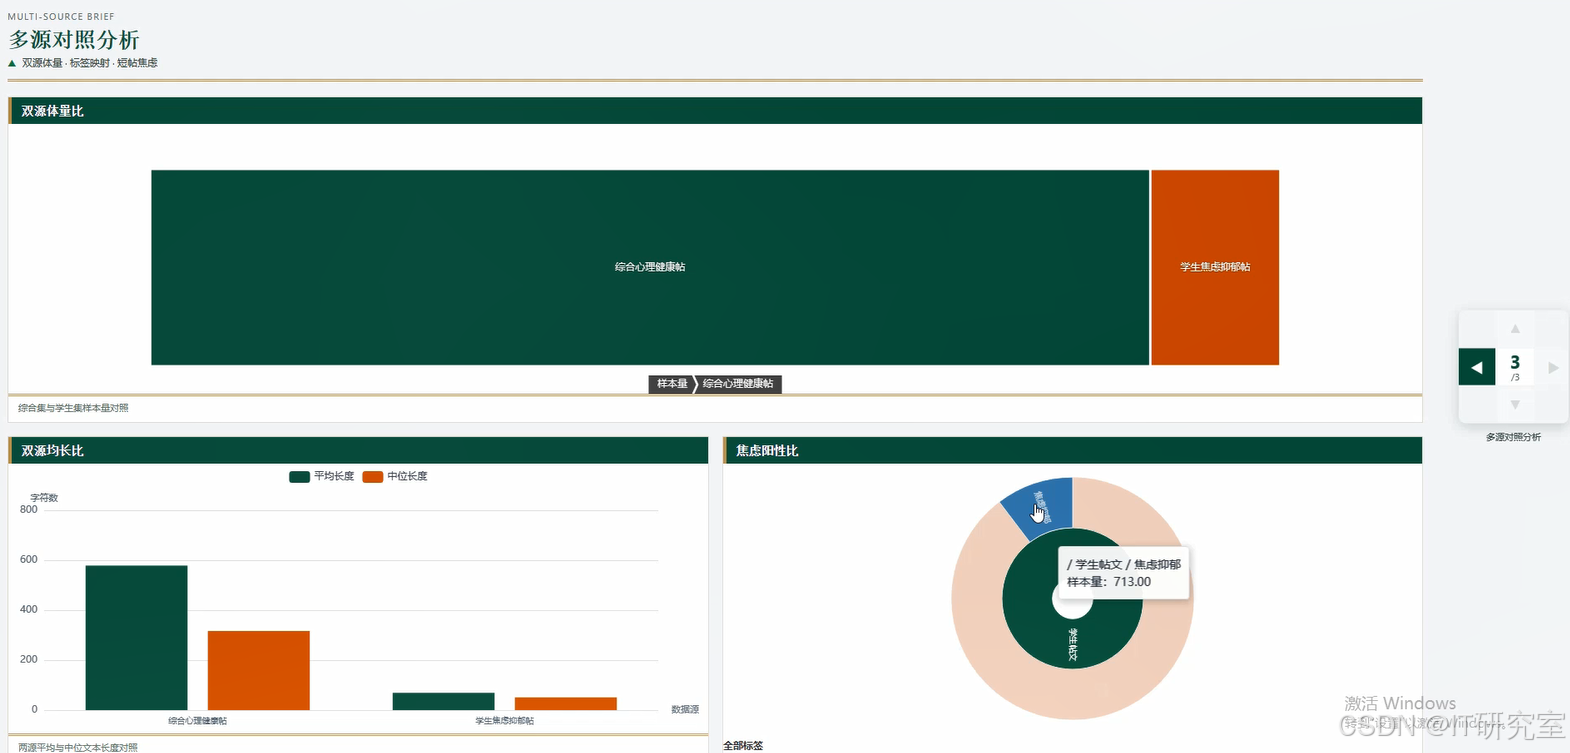
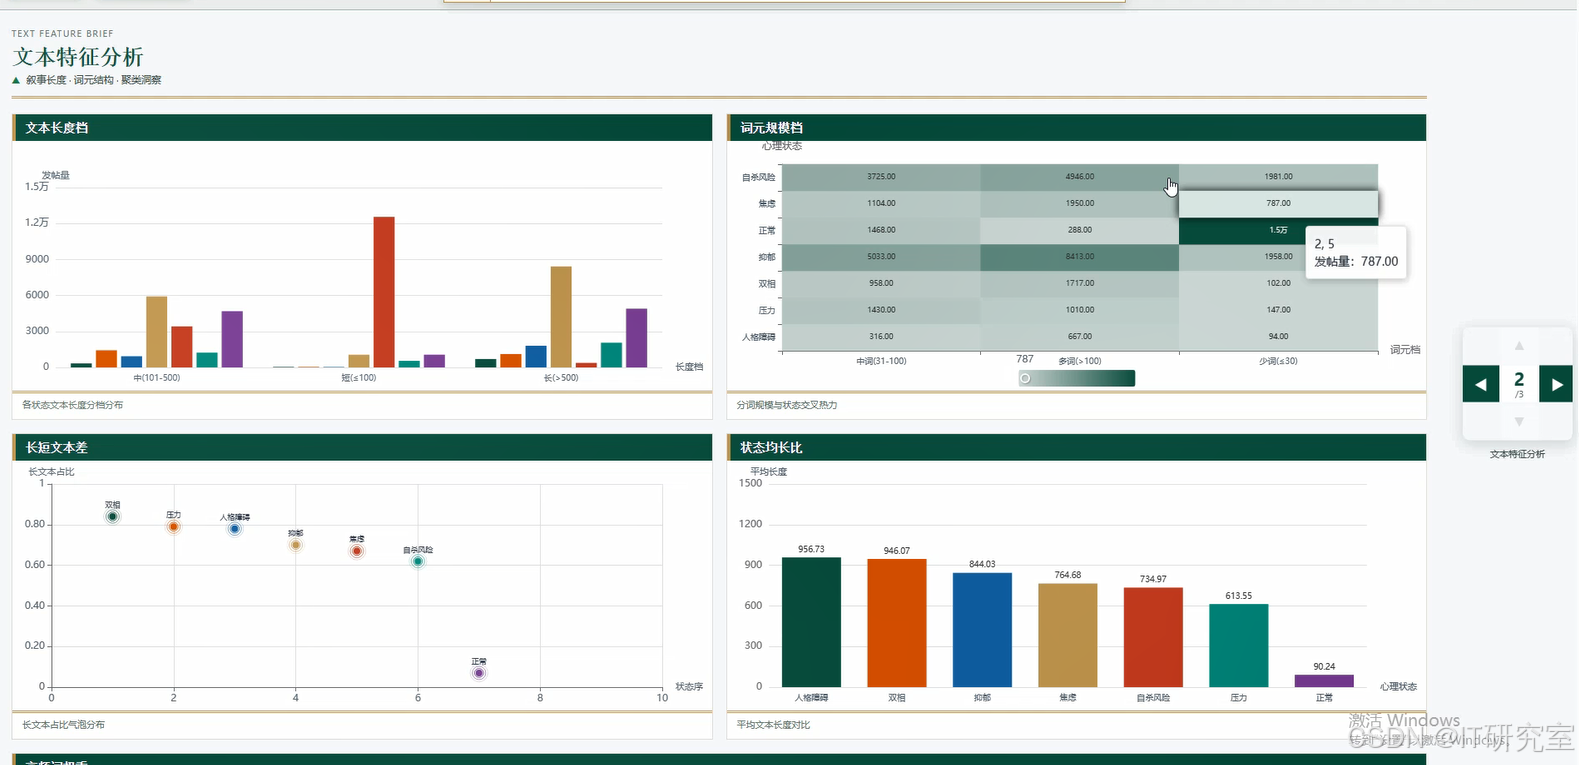
- 基于大数据的多源社交媒体心理健康情感分析与可视化界面展示:
四、代码参考
- 项目实战代码参考:
@Service
public class SentimentAnalysisService {

    @Autowired
    private SparkSession sparkSession;

    public Map<String, Object> multiSourceSentimentAnalysis(String topic, String startDate, String endDate) {
        Dataset<Row> weiboDf = sparkSession.read().option("header", "true").csv("hdfs://cluster/data/weibo/" + topic);
        Dataset<Row> zhihuDf = sparkSession.read().option("header", "true").csv("hdfs://cluster/data/zhihu/" + topic);
        Dataset<Row> twitterDf = sparkSession.read().option("header", "true").csv("hdfs://cluster/data/twitter/" + topic);
        Dataset<Row> weiboFiltered = weiboDf.filter(col("date").between(startDate, endDate)).select("text", "date");
        Dataset<Row> zhihuFiltered = zhihuDf.filter(col("date").between(startDate, endDate)).select("text", "date");
        Dataset<Row> twitterFiltered = twitterDf.filter(col("date").between(startDate, endDate)).select("text", "date");
        Dataset<Row> weiboTagged = weiboFiltered.withColumn("source", lit("weibo"));
        Dataset<Row> zhihuTagged = zhihuFiltered.withColumn("source", lit("zhihu"));
        Dataset<Row> twitterTagged = twitterFiltered.withColumn("source", lit("twitter"));
        Dataset<Row> unionDf = weiboTagged.union(zhihuTagged).union(twitterTagged);
        JavaRDD<String> textRdd = unionDf.select("text").as(Encoders.STRING()).javaRDD();
        JavaRDD<List<String>> wordsRdd = textRdd.map(text -> Arrays.asList(text.split(" ")));
        JavaRDD<String> wordRdd = wordsRdd.flatMap(list -> list.iterator());
        JavaPairRDD<String, Integer> pairRdd = wordRdd.mapToPair(word -> new Tuple2<>(word, 1));
        JavaPairRDD<String, Integer> reducedRdd = pairRdd.reduceByKey((a, b) -> a + b);
        List<Tuple2<String, Integer>> sortedWords = reducedRdd.mapToPair(tuple -> new Tuple2<>(tuple._2, tuple._1)).sortByKey(false).mapToPair(tuple -> new Tuple2<>(tuple._2, tuple._1)).take(20);
        Dataset<Row> weiboGroup = unionDf.filter(col("source").equalTo("weibo")).groupBy("date").count();
        Dataset<Row> zhihuGroup = unionDf.filter(col("source").equalTo("zhihu")).groupBy("date").count();
        Dataset<Row> twitterGroup = unionDf.filter(col("source").equalTo("twitter")).groupBy("date").count();
        List<Row> weiboList = weiboGroup.collectAsList();
        List<Row> zhihuList = zhihuGroup.collectAsList();
        List<Row> twitterList = twitterGroup.collectAsList();
        Map<String, Object> result = new HashMap<>();
        result.put("topWords", sortedWords);
        result.put("weiboDaily", weiboList);
        result.put("zhihuDaily", zhihuList);
        result.put("twitterDaily", twitterList);
        return result;
    }

    public Map<String, Object> emotionTrendAnalysis(String source, String dateRange) {
        Dataset<Row> sourceDf = sparkSession.read().option("header", "true").csv("hdfs://cluster/data/" + source);
        Dataset<Row> dateFiltered = sourceDf.filter(col("date").equalTo(dateRange));
        JavaRDD<String> textRdd = dateFiltered.select("text").as(Encoders.STRING()).javaRDD();
        JavaRDD<String> positiveRdd = textRdd.filter(text -> text.contains("开心") || text.contains("喜欢") || text.contains("优秀"));
        JavaRDD<String> negativeRdd = textRdd.filter(text -> text.contains("难过") || text.contains("讨厌") || text.contains("糟糕"));
        JavaRDD<String> neutralRdd = textRdd.filter(text -> !text.contains("开心") && !text.contains("喜欢") && !text.contains("优秀") && !text.contains("难过") && !text.contains("讨厌") && !text.contains("糟糕"));
        long positiveCount = positiveRdd.count();
        long negativeCount = negativeRdd.count();
        long neutralCount = neutralRdd.count();
        JavaPairRDD<String, String> textPairRdd = dateFiltered.select("text", "date").javaRDD().mapToPair(row -> new Tuple2<>(row.getString(1), row.getString(0)));
        JavaPairRDD<String, Iterable<String>> groupedRdd = textPairRdd.groupByKey();
        JavaPairRDD<String, Long> dateCountRdd = groupedRdd.mapToPair(tuple -> new Tuple2<>(tuple._1, (long) Iterables.size(tuple._2)));
        List<Tuple2<String, Long>> dateCountList = dateCountRdd.collect();
        JavaRDD<String> allTextRdd = dateFiltered.select("text").as(Encoders.STRING()).javaRDD();
        JavaRDD<String> emotionWordsRdd = allTextRdd.flatMap(text -> Arrays.asList(text.split(" ")).iterator()).filter(word -> word.equals("开心") || word.equals("难过") || word.equals("焦虑"));
        JavaPairRDD<String, Integer> emotionPairRdd = emotionWordsRdd.mapToPair(word -> new Tuple2<>(word, 1));
        JavaPairRDD<String, Integer> emotionCountRdd = emotionPairRdd.reduceByKey((a, b) -> a + b);
        List<Tuple2<String, Integer>> emotionList = emotionCountRdd.collect();
        Map<String, Object> trendResult = new HashMap<>();
        trendResult.put("positive", positiveCount);
        trendResult.put("negative", negativeCount);
        trendResult.put("neutral", neutralCount);
        trendResult.put("dateDistribution", dateCountList);
        trendResult.put("emotionWordCount", emotionList);
        return trendResult;
    }

    public Map<String, Object> crossPlatformComparison(String keyword) {
        Dataset<Row> weiboDf = sparkSession.read().option("header", "true").csv("hdfs://cluster/data/weibo/" + keyword);
        Dataset<Row> zhihuDf = sparkSession.read().option("header", "true").csv("hdfs://cluster/data/zhihu/" + keyword);
        Dataset<Row> twitterDf = sparkSession.read().option("header", "true").csv("hdfs://cluster/data/twitter/" + keyword);
        Dataset<Row> weiboSelected = weiboDf.select("text", "date", "user");
        Dataset<Row> zhihuSelected = zhihuDf.select("text", "date", "user");
        Dataset<Row> twitterSelected = twitterDf.select("text", "date", "user");
        JavaRDD<Row> weiboRdd = weiboSelected.javaRDD();
        JavaRDD<Row> zhihuRdd = zhihuSelected.javaRDD();
        JavaRDD<Row> twitterRdd = twitterSelected.javaRDD();
        JavaRDD<Row> weiboPositive = weiboRdd.filter(row -> row.getString(0).contains("好") || row.getString(0).contains("棒"));
        JavaRDD<Row> zhihuPositive = zhihuRdd.filter(row -> row.getString(0).contains("好") || row.getString(0).contains("棒"));
        JavaRDD<Row> twitterPositive = twitterRdd.filter(row -> row.getString(0).contains("好") || row.getString(0).contains("棒"));
        double weiboPositiveRatio = (double) weiboPositive.count() / weiboRdd.count();
        double zhihuPositiveRatio = (double) zhihuPositive.count() / zhihuRdd.count();
        double twitterPositiveRatio = (double) twitterPositive.count() / twitterRdd.count();
        JavaRDD<String> weiboWordRdd = weiboRdd.map(row -> row.getString(0)).flatMap(text -> Arrays.asList(text.split(" ")).iterator());
        JavaRDD<String> zhihuWordRdd = zhihuRdd.map(row -> row.getString(0)).flatMap(text -> Arrays.asList(text.split(" ")).iterator());
        JavaRDD<String> twitterWordRdd = twitterRdd.map(row -> row.getString(0)).flatMap(text -> Arrays.asList(text.split(" ")).iterator());
        JavaPairRDD<String, Integer> weiboPairRdd = weiboWordRdd.mapToPair(word -> new Tuple2<>(word, 1)).reduceByKey((a, b) -> a + b);
        JavaPairRDD<String, Integer> zhihuPairRdd = zhihuWordRdd.mapToPair(word -> new Tuple2<>(word, 1)).reduceByKey((a, b) -> a + b);
        JavaPairRDD<String, Integer> twitterPairRdd = twitterWordRdd.mapToPair(word -> new Tuple2<>(word, 1)).reduceByKey((a, b) -> a + b);
        List<Tuple2<String, Integer>> weiboTop = weiboPairRdd.mapToPair(tuple -> new Tuple2<>(tuple._2, tuple._1)).sortByKey(false).mapToPair(tuple -> new Tuple2<>(tuple._2, tuple._1)).take(10);
        List<Tuple2<String, Integer>> zhihuTop = zhihuPairRdd.mapToPair(tuple -> new Tuple2<>(tuple._2, tuple._1)).sortByKey(false).mapToPair(tuple -> new Tuple2<>(tuple._2, tuple._1)).take(10);
        List<Tuple2<String, Integer>> twitterTop = twitterPairRdd.mapToPair(tuple -> new Tuple2<>(tuple._2, tuple._1)).sortByKey(false).mapToPair(tuple -> new Tuple2<>(tuple._2, tuple._1)).take(10);
        Map<String, Object> compareResult = new HashMap<>();
        compareResult.put("weiboPositiveRatio", weiboPositiveRatio);
        compareResult.put("zhihuPositiveRatio", zhihuPositiveRatio);
        compareResult.put("twitterPositiveRatio", twitterPositiveRatio);
        compareResult.put("weiboTopWords", weiboTop);
        compareResult.put("zhihuTopWords", zhihuTop);
        compareResult.put("twitterTopWords", twitterTop);
        return compareResult;
    }
}
五、系统视频
基于大数据的多源社交媒体心理健康情感分析与可视化项目视频:
演示视频
结语
最新大数据毕业设计选题推荐-基于大数据的多源社交媒体心理健康情感分析与可视化-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/2301_79456892/article/details/164264331