
🔥 星光编译者 · 个人主页
📚 学习专栏: 《C/C++ 成长笔记》 · 《Linux 实践手册》 · 《数据结构与算法》
🌄 向云端飞扬,编译属于自己的代码星河。
☕ 写在开篇
你好,这里是 星光编译者。
这里记录我在 C/C++、Linux、数据结构与算法 学习中遇到的真实问题、亲手验证过的代码,以及那些容易被忽略的实现细节。
比起简单罗列结论,我更愿意从问题出发,把一个知识点的来由讲清楚,把“为什么会这样”和“应该怎样解决”说明白,让每一次踩坑都沉淀成可以复用的经验。
如果这篇记录能帮你少绕一点路,或让某个模糊的地方忽然变得清晰,那么这次分享便有了意义。愿我们在一次次阅读、编译与调试中稳步向前,慢慢搭起属于自己的技术世界。
🔥 本文定位:围绕课程第 22 讲,系统讲清 C 语言文件操作的完整链路:文件与流、文本与二进制、
FILE *、打开模式、顺序读写、随机访问、结束判定和缓冲区。💡 学习目标:能独立选择正确的打开模式与读写函数;能写出由返回值驱动的读取循环;能区分文件尾和 I/O 错误;能正确管理文件位置、缓冲区与关闭路径。
📌 平台说明:文中以标准 C 接口为主。Windows 与类 Unix 系统在路径分隔符、文本模式换行转换、对象表示和扩展接口上可能不同;涉及字节布局与文件大小的结论应在目标平台验证。
文章目录
- 一、为什么程序需要文件
- 二、程序眼中的文件与文件名
- 三、文本文件与二进制文件
- 四、流、标准流与 FILE 指针
- 五、fopen 与 fclose:建立和解除关联
- 六、顺序读写:按数据边界选择函数
- 七、完整案例:保存并读取学生记录
- 八、随机读写:fseek、ftell 与 rewind
- 九、文件读取结束的正确判定
- 十、文件缓冲区与 fflush
- 十一、可靠文件程序的设计方法
- 十二、高频问题、易错点与练习
- 总结
一、为什么程序需要文件
普通变量存在于程序的运行期。程序启动时创建进程,运行中使用内存,进程结束后,属于它的普通内存会被系统回收:
int score = 95;
如果 score 只保存在变量里,那么这次运行结束后,下次启动并不会自动恢复成 95。游戏存档、通讯录、日志、配置、模型参数和订单记录显然不能接受这种命运,它们需要一种能够跨越程序生命周期的保存方式。
文件承担的正是这项工作:
程序运行时:文件 → 读取 → 内存 → 计算
程序结束前:内存 → 写入 → 文件 → 长期保存
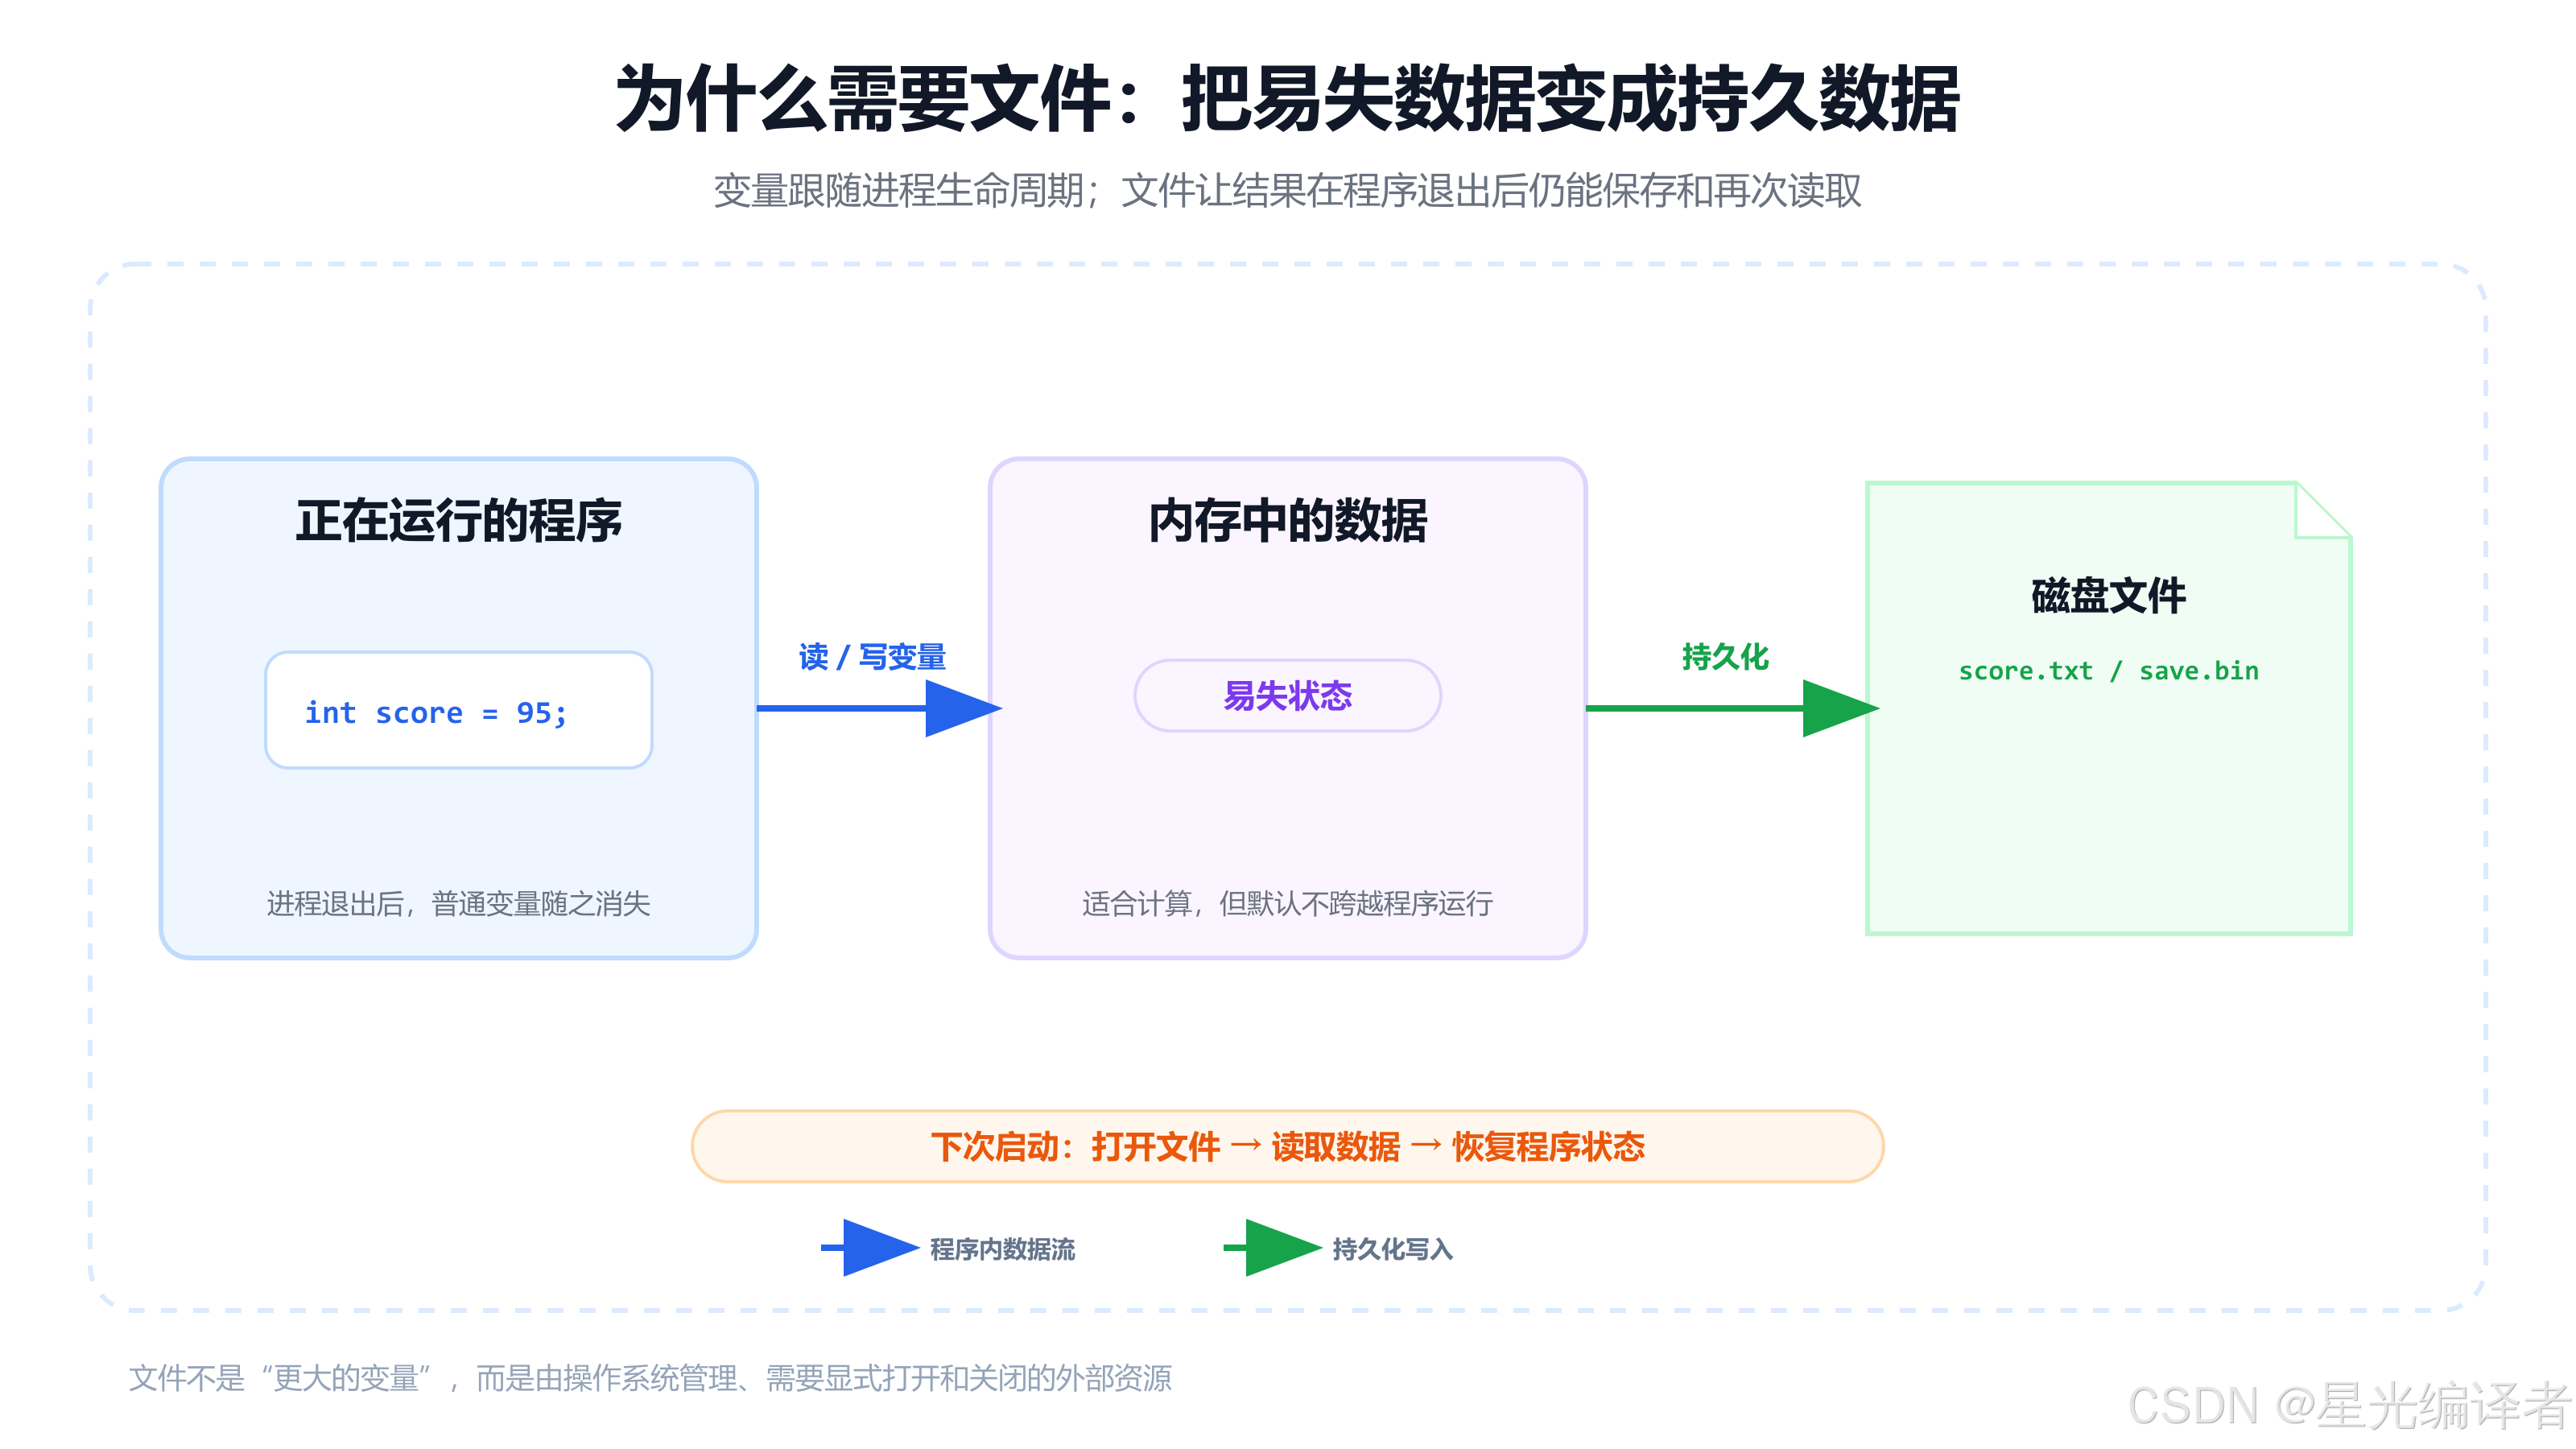
因此,文件操作不是简单地“把 printf 换成另一个函数”,而是引入了一种外部资源。程序必须主动处理它的生命周期:
- 确定文件路径和格式;
- 以合适的模式打开;
- 检查打开是否成功;
- 执行读取或写入;
- 检查每次操作的结果;
- 必要时刷新缓冲区;
- 在所有正常和异常路径上关闭文件。
真正可靠的文件程序,难点通常不在“函数名记不记得”,而在失败时是否还能保持数据与资源的一致性。
二、程序眼中的文件与文件名
2.1 程序文件与数据文件
从用途看,常见文件可以分成两类:
- 程序文件:源文件、目标文件、可执行文件等;
- 数据文件:程序运行时读取或写出的配置、记录、日志、图像、存档等。
例如在常见 Windows 工具链中,可能见到:
main.c      源程序文件
main.obj    目标文件
main.exe    可执行文件
scores.txt  数据文件
save.bin    数据文件
本章关注的是第二类:程序怎样通过标准 I/O 库与数据文件交互。
2.2 文件名不只是最后一段文字
一个文件通常由路径定位。可以把文件标识理解为:
路径 + 主文件名 + 扩展名
例如:
C:\code\project\data\scores.txt
在 C 字符串中,反斜杠是转义字符,所以 Windows 路径通常要写成:
FILE *fp = fopen("C:\\code\\project\\data\\scores.txt", "r");
或者在很多 Windows C 运行库中使用正斜杠:
FILE *fp = fopen("C:/code/project/data/scores.txt", "r");
相对路径则以进程的当前工作目录为基准,而不是必然以源文件所在目录或可执行文件所在目录为基准:
FILE *fp = fopen("data/scores.txt", "r");
“文件明明存在,fopen 却失败”时,第一件事应检查当前工作目录与实际拼出的路径,而不是反复修改读写函数。
2.3 扩展名只是约定
.txt、.bin、.dat 能帮助人理解文件用途,但标准 I/O 不会仅凭扩展名自动选择编码。一个名为 data.txt 的文件也可以装任意字节,一个名为 save.bin 的文件也可以只保存 ASCII 文本。
真正决定文件含义的是双方约定的格式:
- 字段按什么顺序出现;
- 数字使用字符还是固定字节表示;
- 字符编码是什么;
- 是否有长度、版本、校验和;
- 多字节整数采用什么字节序。
三、文本文件与二进制文件
3.1 两种表示方式
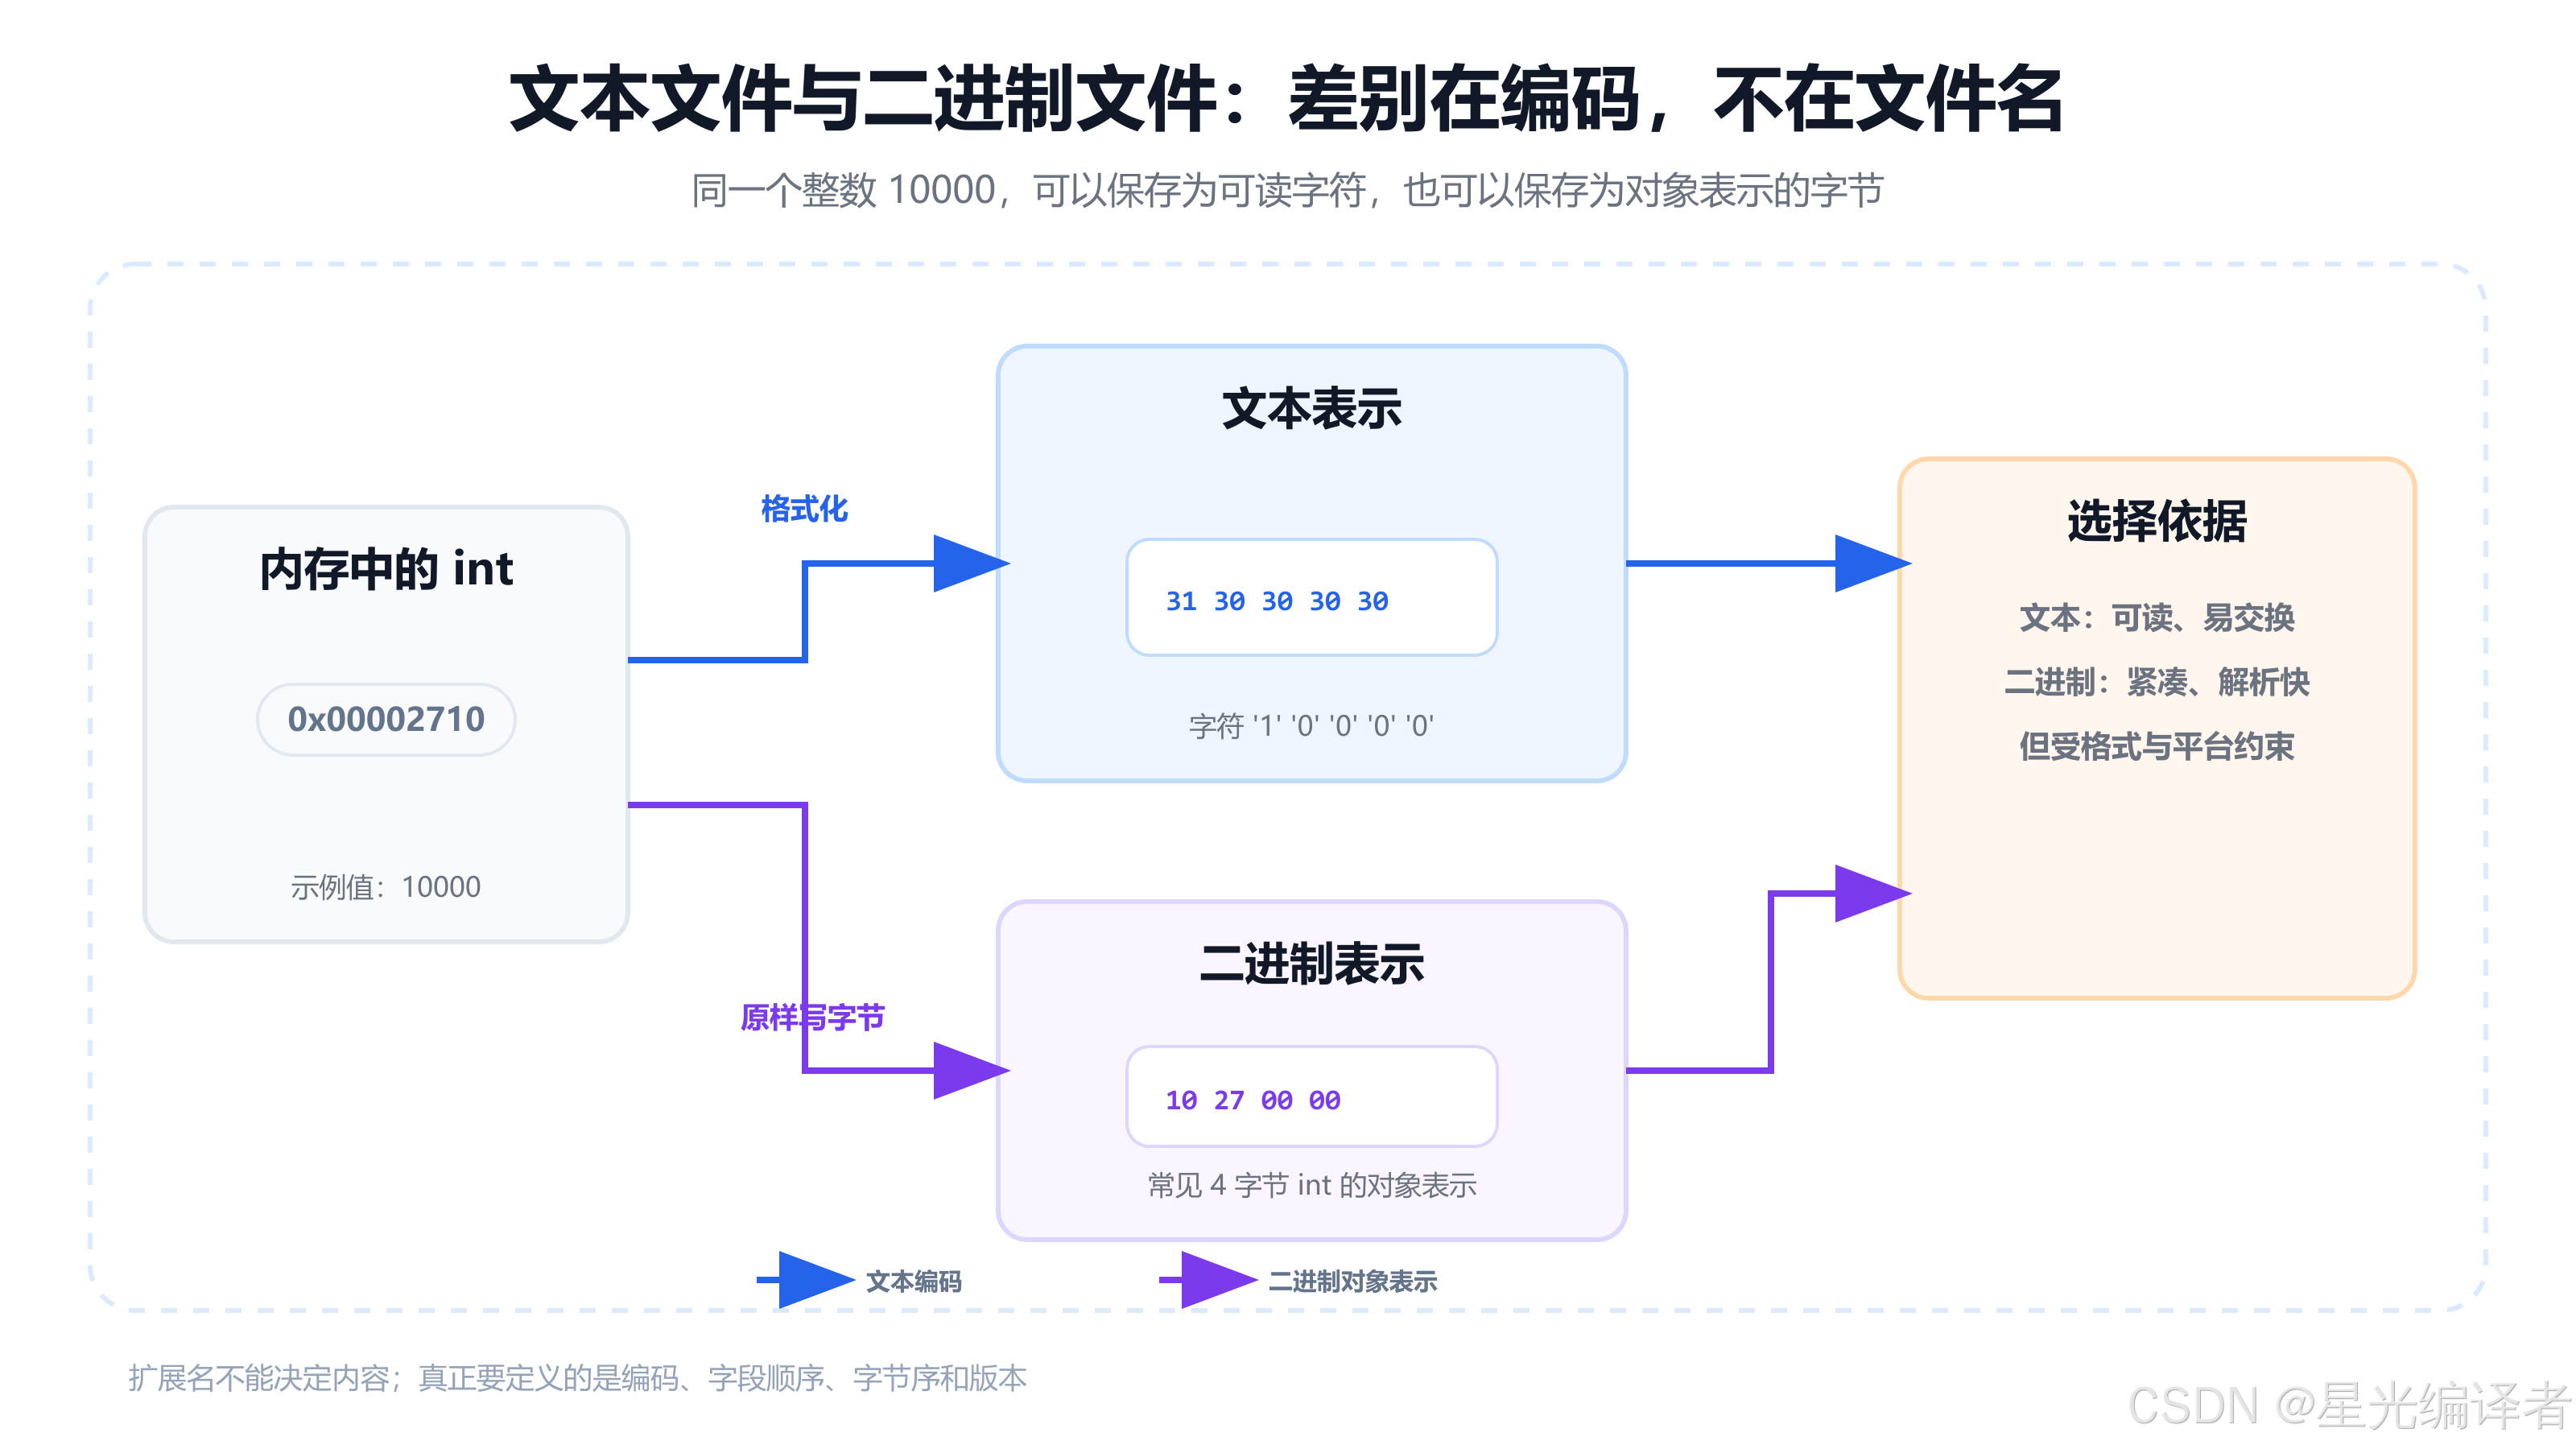
内存中的数据最终都是位模式。写入文件时,可以先把数值转换成人能阅读的字符,也可以把对象表示中的字节直接写出。
以整数 10000 为例:
int value = 10000;
若使用文本格式写出:
fprintf(fp, "%d", value);
文件中通常是 5 个字符:
'1' '0' '0' '0' '0'
按 ASCII/兼容编码观察,就是:
31 30 30 30 30
若使用二进制块写出:
fwrite(&value, sizeof value, 1, fp);
写出的是 int 的对象表示。在常见的 4 字节、小端实现中,可能看到:
10 27 00 00
3.2 文本格式的特点
文本格式通常具有这些优点:
- 人可以直接查看与修改;
- 便于日志、配置和简单数据交换;
- 不直接依赖某个平台的整数对象表示;
- 出问题时容易使用编辑器和命令行工具排查。
代价也很明显:数值需要格式化和解析,文件可能更大,还必须处理分隔符、空白、转义、区域设置和非法输入。
3.3 二进制格式的特点
二进制格式通常更紧凑,固定大小记录也更容易随机定位。但“直接 fwrite 一个结构体”并不自动得到可移植格式:
struct Student
{
    int id;
    double score;
};

struct Student s = {1001, 92.5};
fwrite(&s, sizeof s, 1, fp);
这个文件可能受到以下因素影响:
int、double的大小与表示;- 大小端;
- 结构体填充字节;
- 编译器 ABI;
- 结构体未来增加或调整成员;
- 浮点格式和对齐策略。
若文件只在同一程序、同一平台、同一版本中临时使用,这种写法有时足够;若要长期保存或跨平台交换,就应显式定义文件格式,逐字段编码,并包含版本信息。
3.4 文本模式中的换行转换
打开模式中的 b 表示二进制模式。在某些系统上,文本模式可能对换行或特殊字节做转换;在 POSIX 系统上,文本模式与二进制模式通常没有可观察差异。为了表达意图并兼容 Windows,处理原始字节、图像、压缩包和自定义二进制格式时应明确使用 rb、wb 或 ab。
b 不会把内容自动“变成二进制”。下面仍然写的是字符:
FILE *fp = fopen("data.bin", "wb");
fprintf(fp, "%d", 10000);
文本还是二进制,最终由使用的编码方式和读写函数共同决定。
四、流、标准流与 FILE 指针
4.1 为什么需要“流”这层抽象
键盘、终端、磁盘文件和其他设备的底层操作各不相同。如果每种设备都暴露完全不同的接口,程序员必须反复处理大量细节。C 标准 I/O 将它们抽象成流:程序面向一条按顺序传输字符或字节的通道进行输入输出。
于是很多函数可以同时操作标准流和普通文件流:
fputs("hello\n", stdout);
fputs("hello\n", fp);
二者调用形式相同,差别只在目标流。
4.2 三个标准流
C 程序正常启动后通常已经拥有三个标准流:
| 标准流 | 常见连接 | 典型函数 |
|---|---|---|
stdin | 键盘或重定向输入 | scanf、fgets |
stdout | 终端或重定向输出 | printf、puts |
stderr | 错误输出通道 | fprintf(stderr, ...) |
它们的类型都是 FILE *。这也是为什么下面的写法完全成立:
char line[128];

if (fgets(line, sizeof line, stdin) != NULL)
{
    fputs(line, stdout);
}
Shell 的重定向还能在不修改程序的情况下改变标准流连接的位置:
program < input.txt > output.txt
程序依旧从 stdin 读、向 stdout 写,只是终端替换成了文件。
4.3 FILE 对象保存什么
FILE 是标准库声明的类型。具体实现会在其中或其关联状态里维护:
- 缓冲区信息;
- 当前文件位置;
- EOF 标志;
- 错误标志;
- 读写模式与底层设备关联。
用户代码通常只保存指向它的指针:
FILE *fp = NULL;
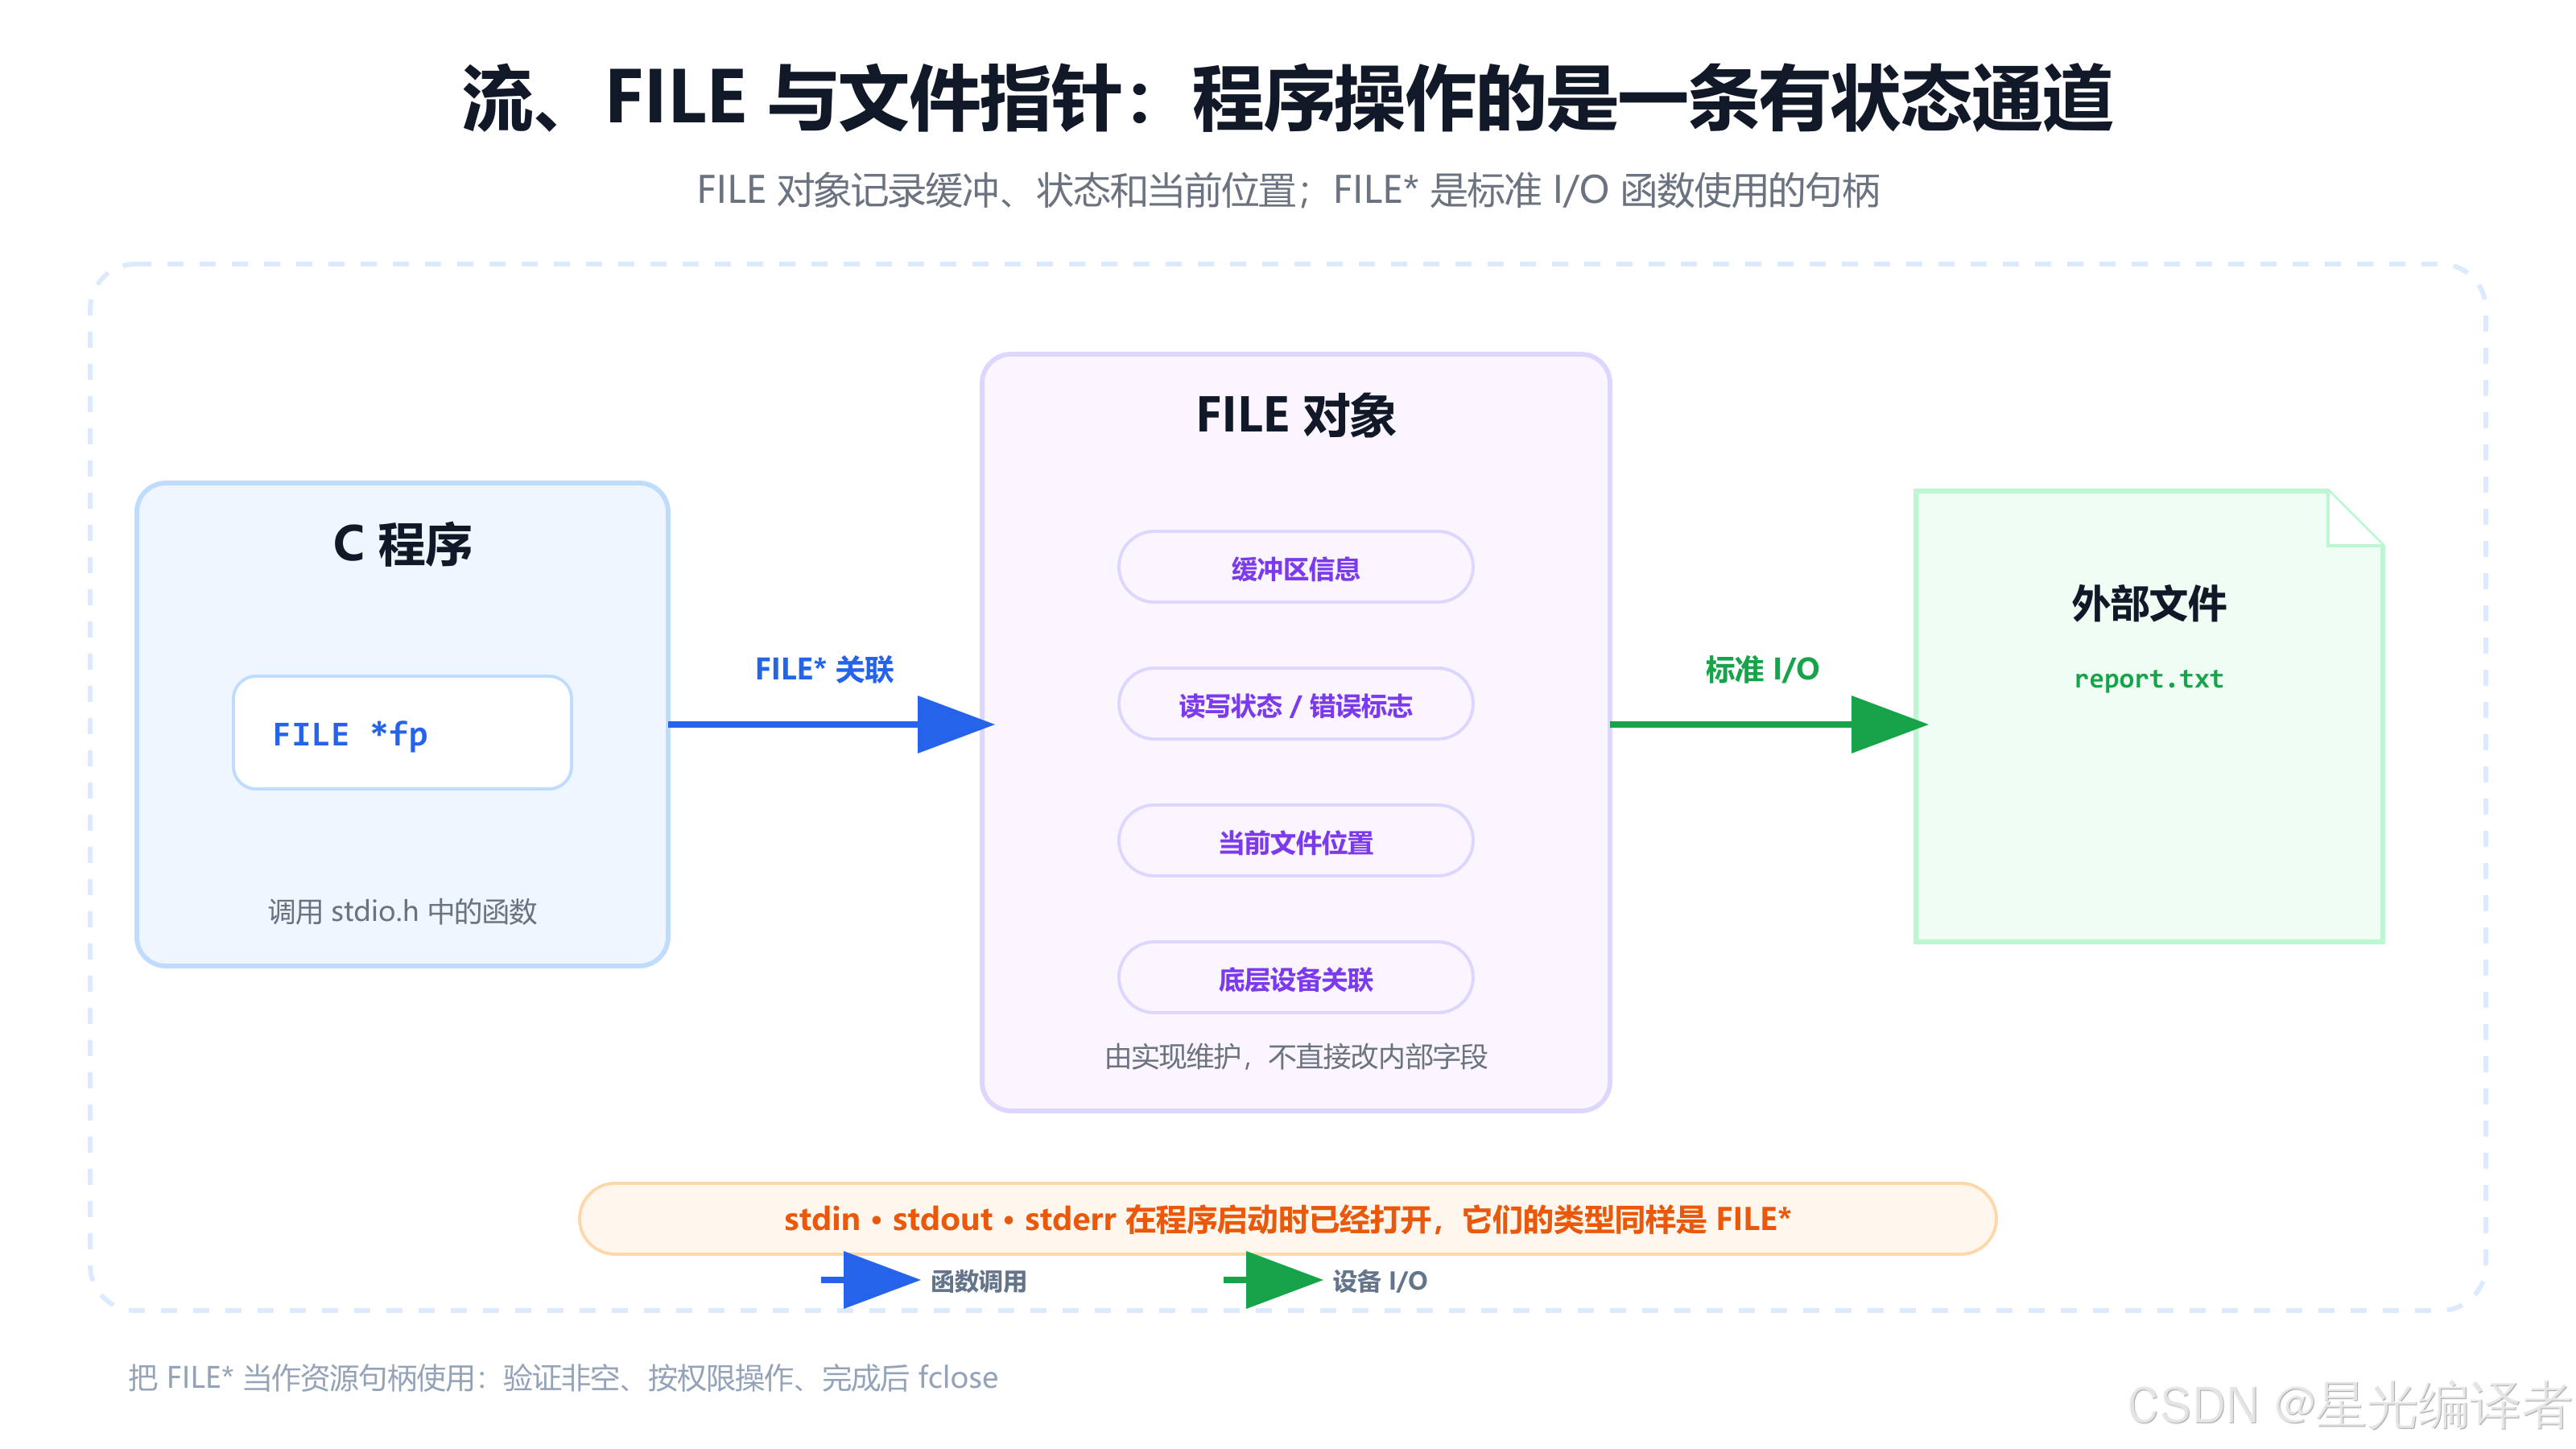
不要依赖某个编译器头文件里 struct FILE 的私有字段,更不要自己修改它。FILE 的内部结构属于实现细节,跨编译器和跨平台并不相同。程序应只通过 <stdio.h> 提供的函数操作流。
五、fopen 与 fclose:建立和解除关联
5.1 基本接口
标准 C 使用 fopen 打开文件:
FILE *fopen(const char *filename, const char *mode);
成功时返回可用于后续操作的 FILE *,失败时返回空指针。关闭文件使用:
int fclose(FILE *stream);
最小但完整的写入程序应这样写:
#include <stdio.h>
#include <stdlib.h>

int main(void)
{
    FILE *fp = fopen("message.txt", "w");

    if (fp == NULL)
    {
        perror("fopen message.txt");
        return EXIT_FAILURE;
    }

    if (fputs("hello, file\n", fp) == EOF)
    {
        perror("fputs message.txt");
        fclose(fp);
        return EXIT_FAILURE;
    }

    if (fclose(fp) == EOF)
    {
        perror("fclose message.txt");
        return EXIT_FAILURE;
    }

    return EXIT_SUCCESS;
}
这里有三个不能省略的判断:打开是否成功、写入是否成功、关闭是否成功。输出错误可能直到缓冲区真正提交时才暴露,因此成功的 fputs 并不保证最后的 fclose 一定成功。
5.2 打开模式的三大家族
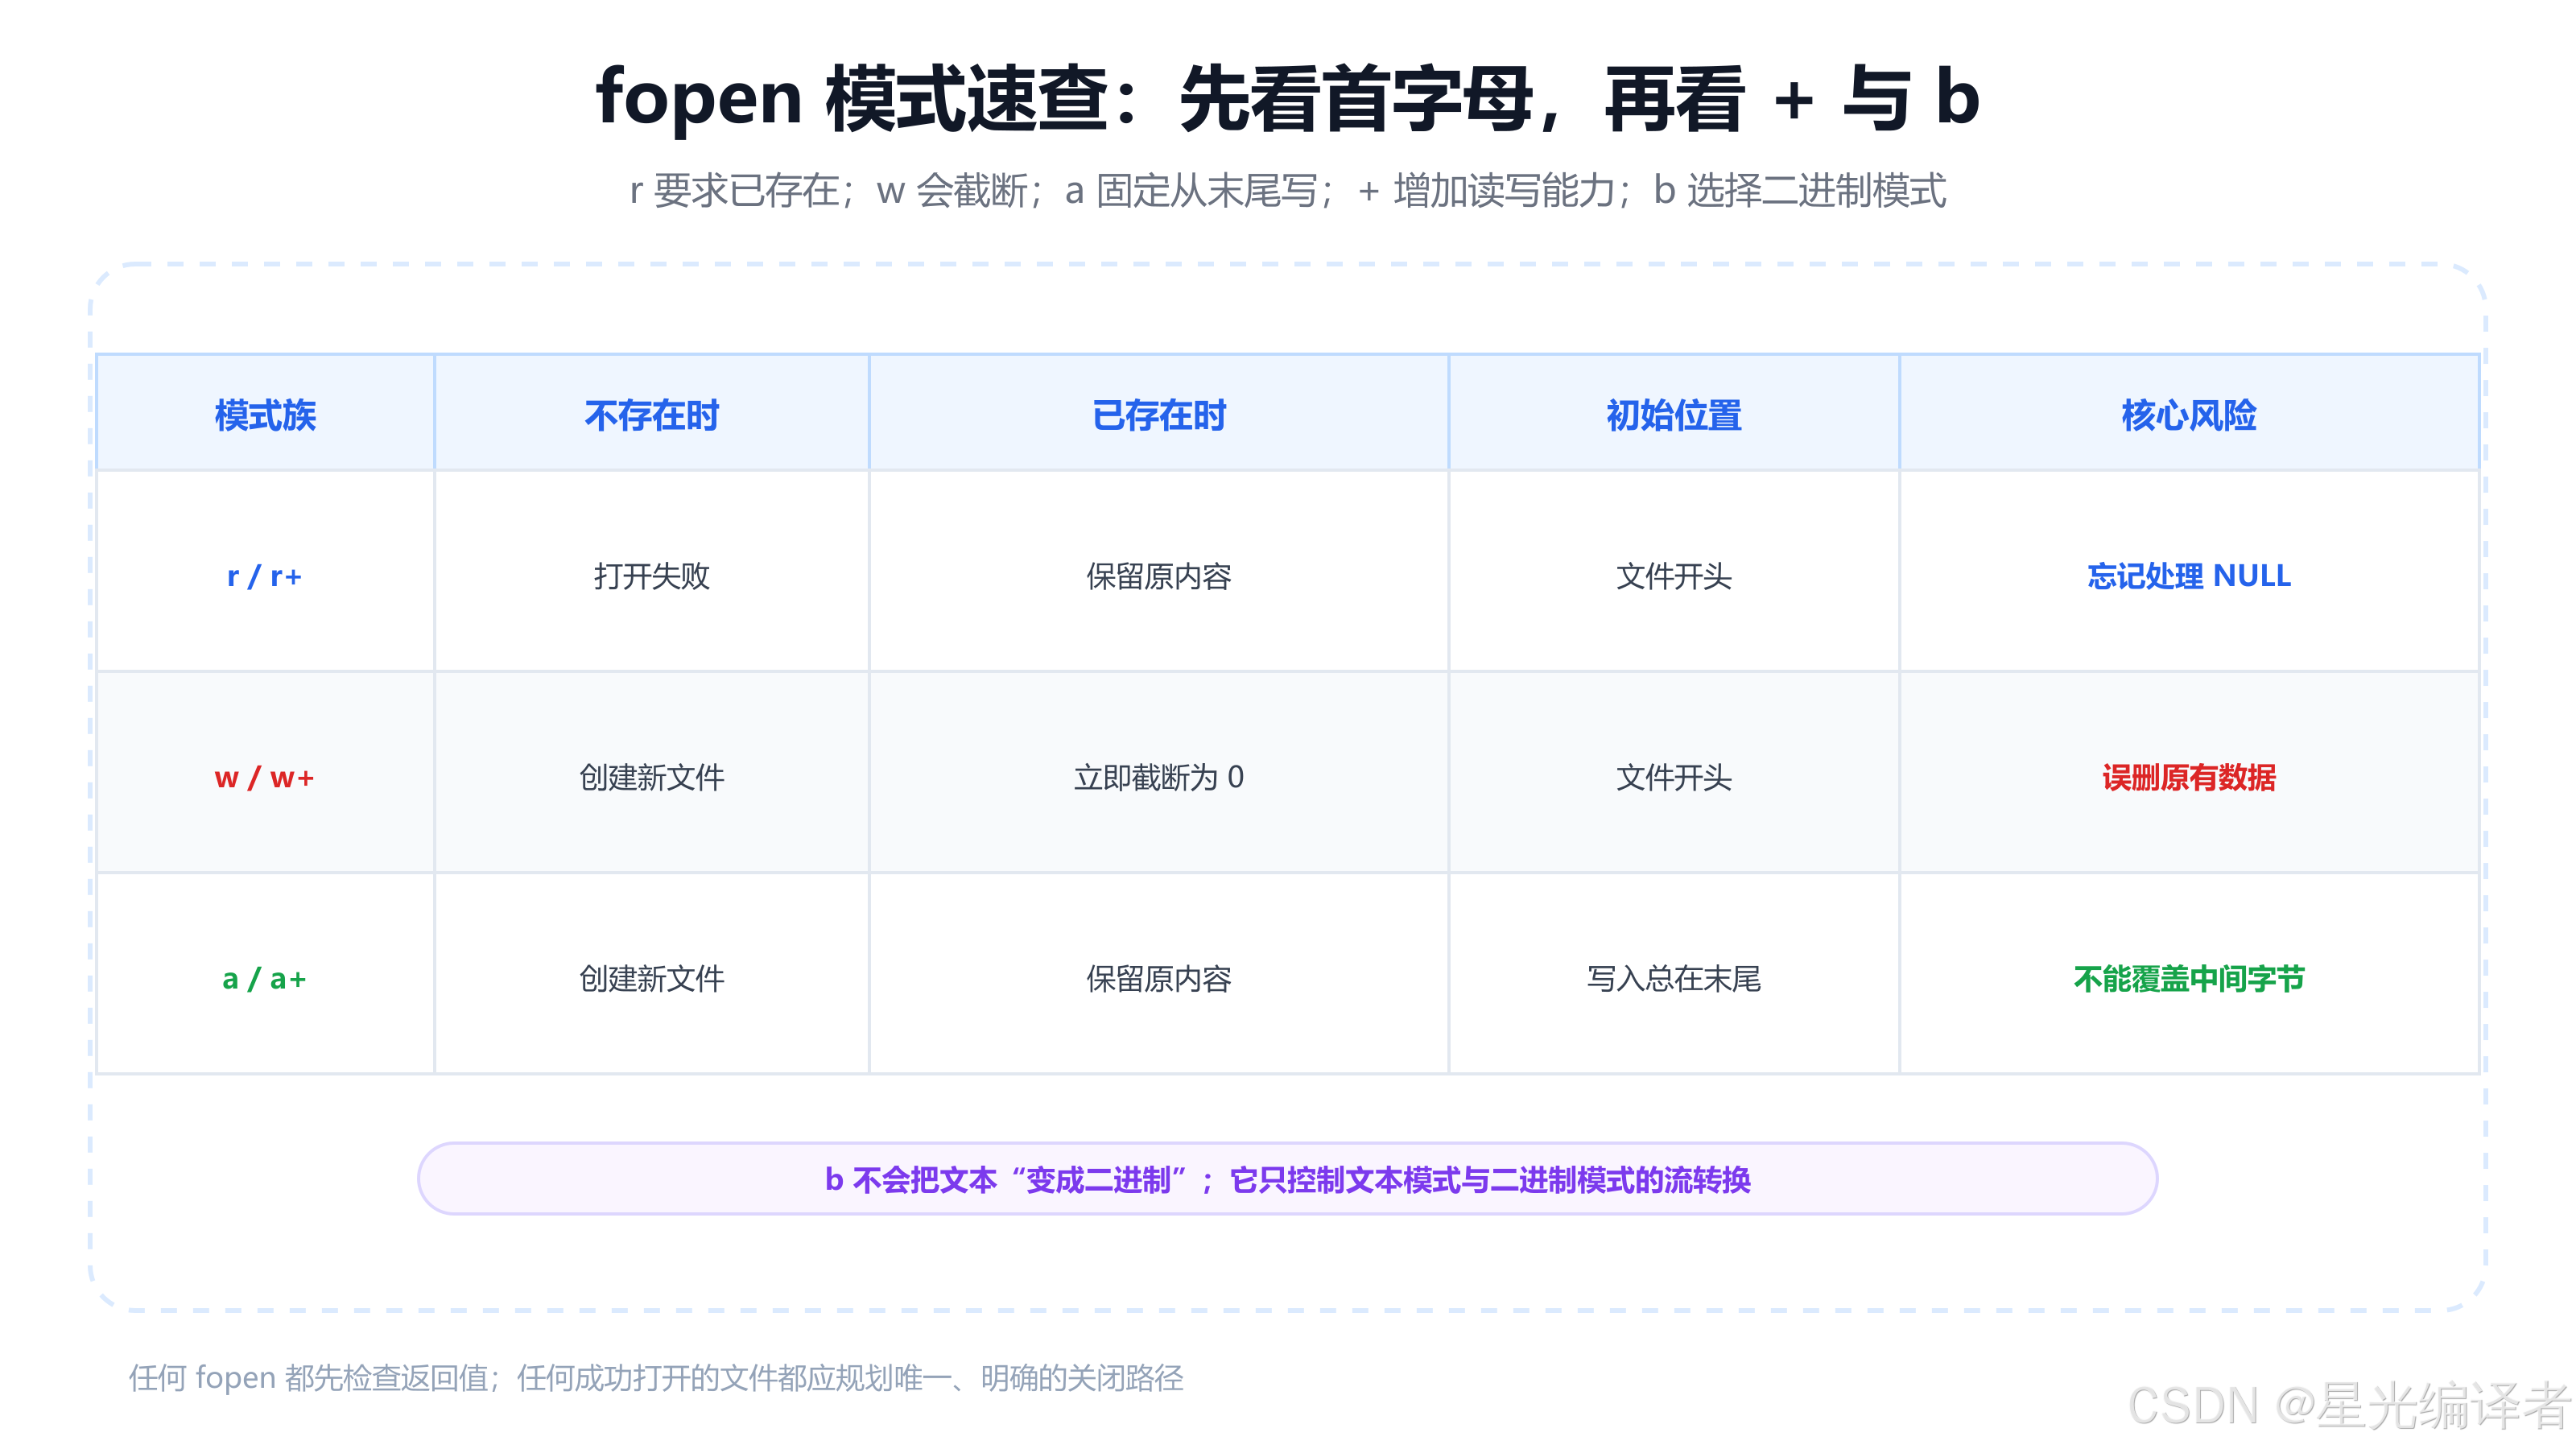
先看首字母,就能抓住最关键的行为:
| 模式 | 文件不存在 | 文件已存在 | 主要用途 |
|---|---|---|---|
r | 失败 | 保留内容 | 只读 |
w | 创建 | 截断为 0 长度 | 从头只写 |
a | 创建 | 保留内容 | 追加写 |
w 的截断行为非常危险:
FILE *fp = fopen("important.txt", "w");
只要打开成功,原文件内容就已经被清空,甚至还没来得及调用第一次写函数。若目标是保留原内容并在末尾添加,应使用 a。
5.3 + 和 b 分别改变什么
+ 增加更新能力,即同一流可以读也可以写:
| 模式 | 含义 |
|---|---|
r+ | 打开已存在文件,可读可写,不截断 |
w+ | 创建或截断文件,可读可写 |
a+ | 创建或打开文件,可读;写入固定追加到末尾 |
b 选择二进制模式:
rb wb ab r+b w+b a+b
rb+ 与 r+b 等价,其他组合也可按同样规则理解。
5.4 更新流切换方向的规则
使用 r+、w+ 或 a+ 时,不应把读写函数毫无过渡地交叉调用。标准 C 对更新流规定了方向切换约束:
- 输出后转输入:中间使用
fflush或文件定位函数; - 输入后转输出:中间使用文件定位函数,除非输入操作已经遇到文件尾。
例如:
FILE *fp = fopen("data.txt", "w+");

if (fp == NULL)
{
    return 1;
}

fputs("abc", fp);
rewind(fp);               /* 定位回开头,也完成方向切换所需的同步 */

int ch = fgetc(fp);
printf("%c\n", ch);

fclose(fp);
“我明明刚写完,为什么马上读不到”经常不是磁盘损坏,而是当前位置已经在文件尾,或者更新流没有按规则完成方向切换。
5.5 关闭后是否必须设为 NULL
fclose(fp) 成功或失败后,都不能再继续把原来的 fp 作为打开流使用。把局部变量设为 NULL 可以降低误用风险:
fclose(fp);
fp = NULL;
但这不是释放资源的动作,真正解除关联的是 fclose。若还有其他变量复制了同一个 FILE *,给其中一个变量赋 NULL 并不会让其他副本自动失效。
六、顺序读写:按数据边界选择函数
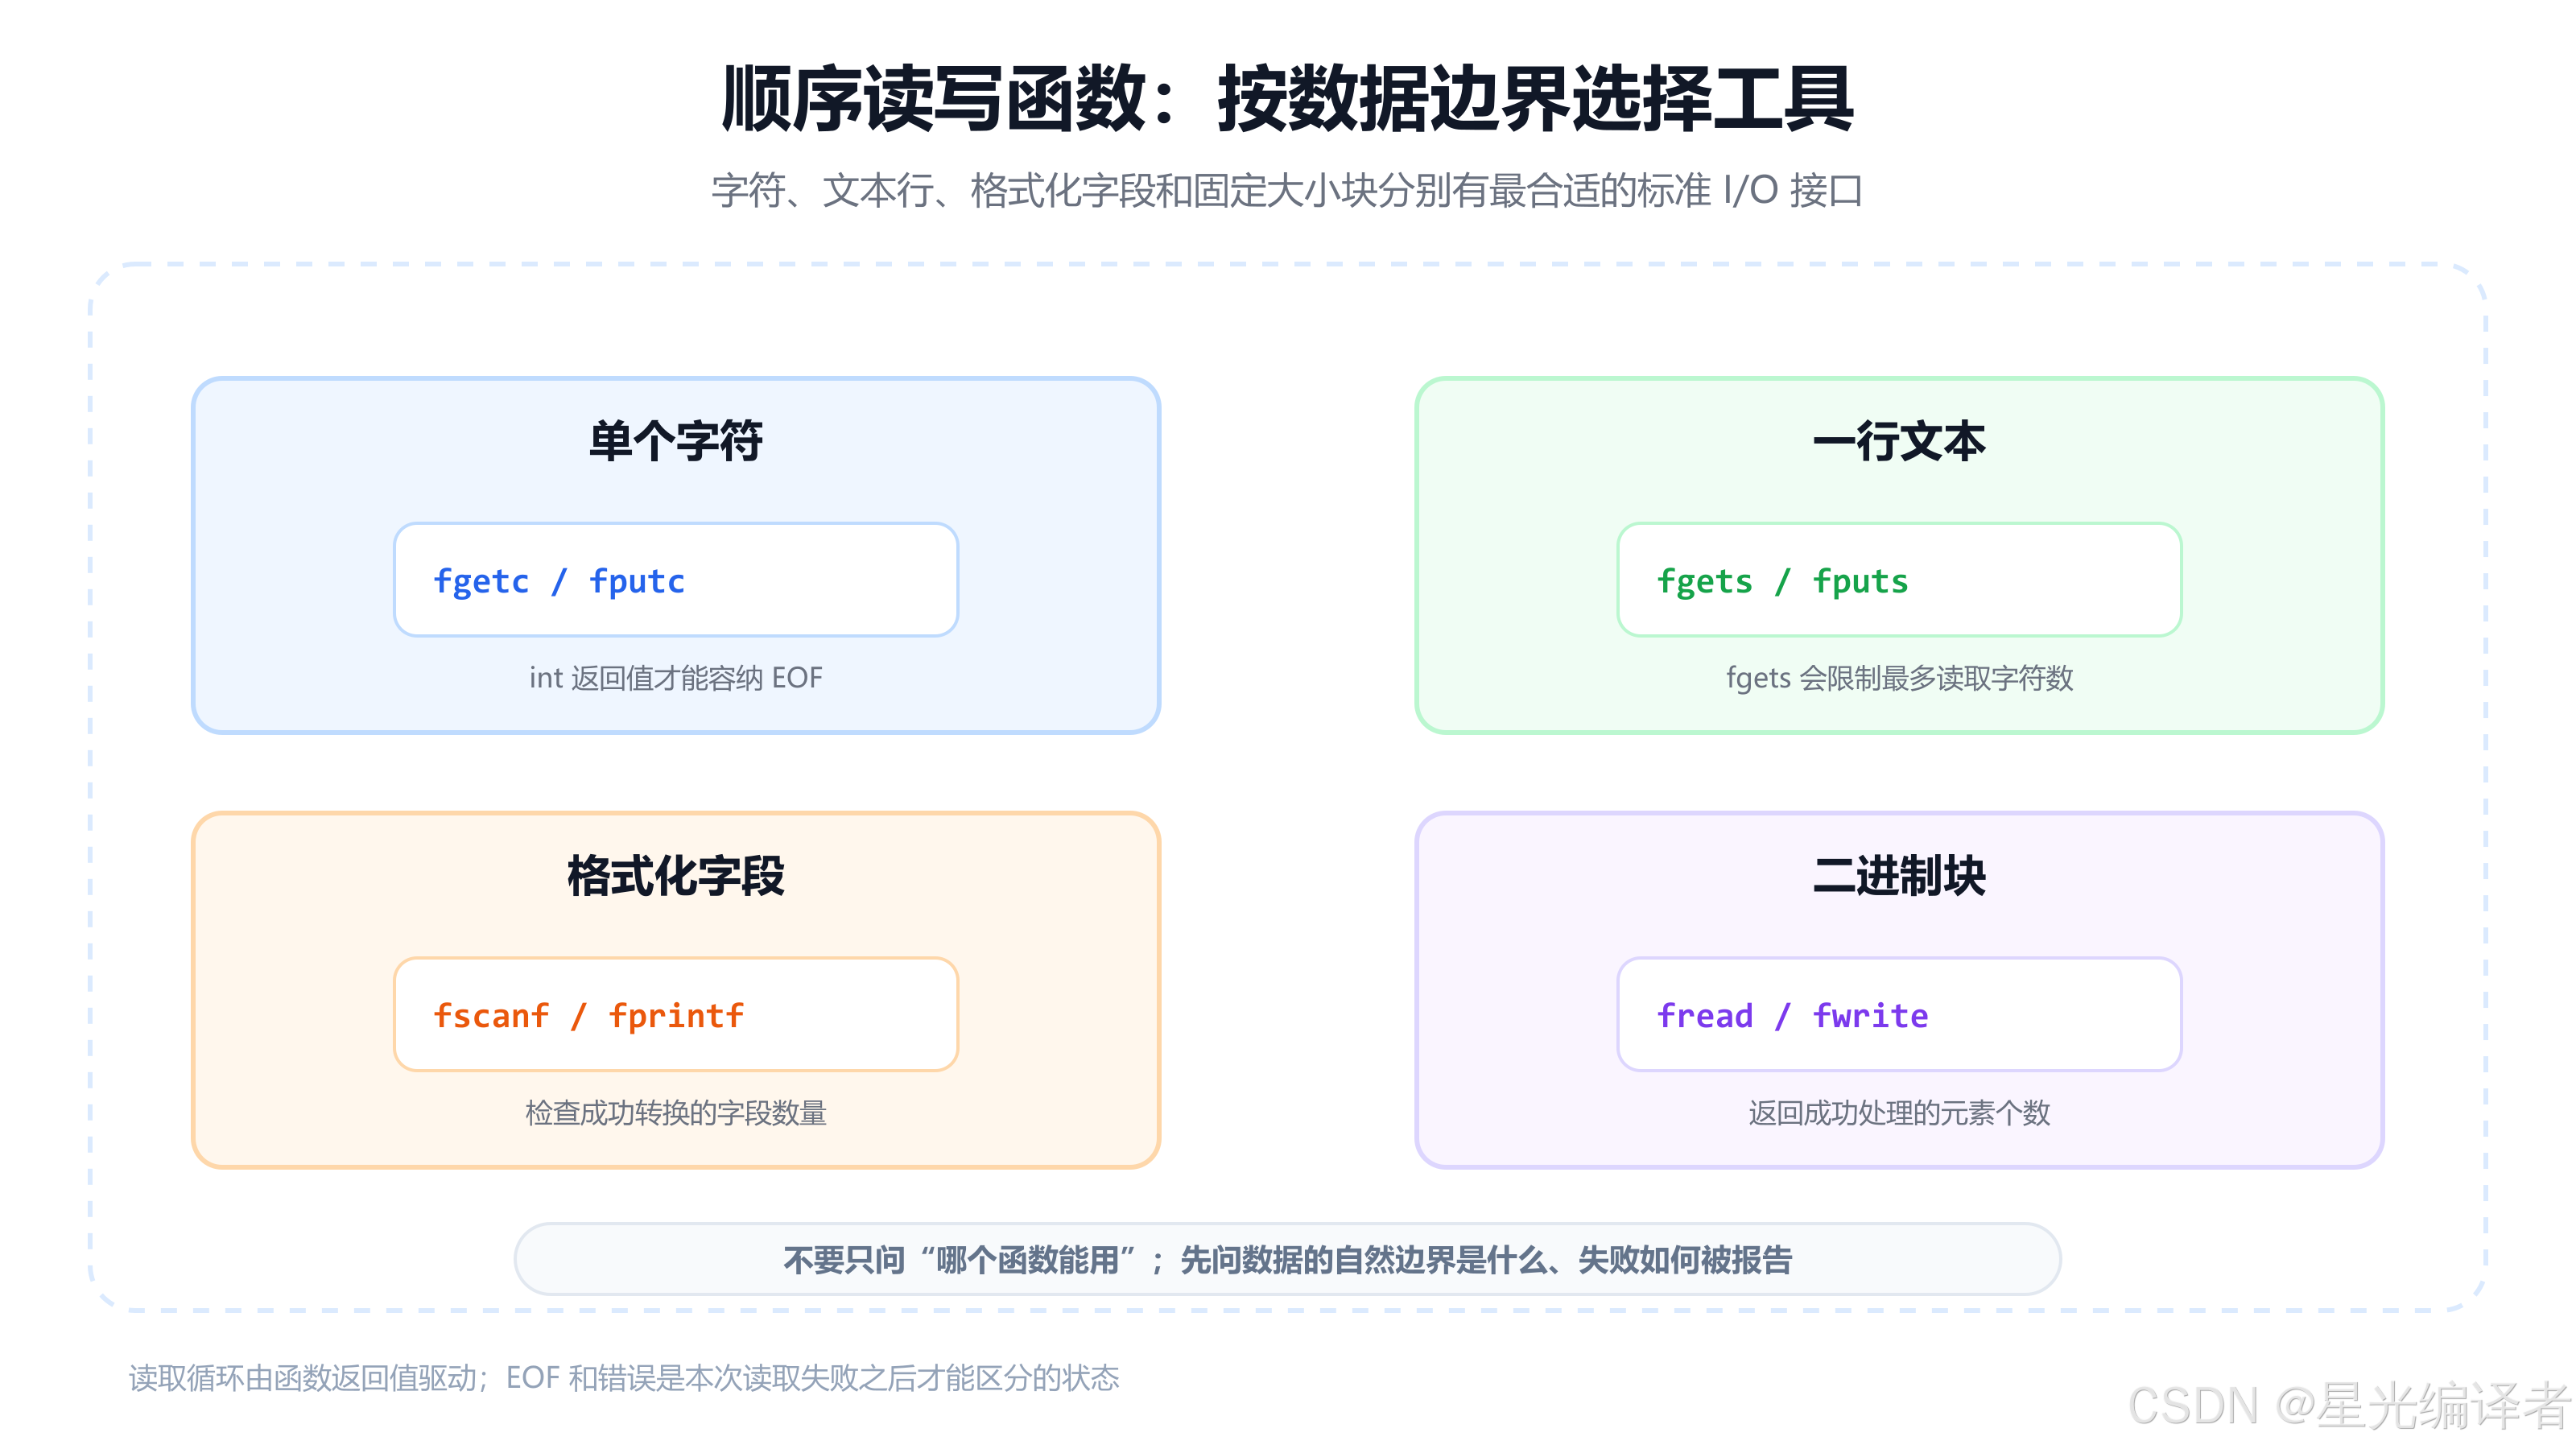
标准库提供多组读写函数,它们不是“谁高级就用谁”,而是分别面向不同的数据边界。
6.1 字符读写:fgetc 与 fputc
fgetc 从流中读取下一个字符:
int fgetc(FILE *stream);
它的返回类型是 int,不是 char,因为除了所有 unsigned char 可表示的值,还要额外表示 EOF:
int ch;

while ((ch = fgetc(fp)) != EOF)
{
    putchar(ch);
}
下面的写法是错误或至少不可移植的:
char ch;

while ((ch = fgetc(fp)) != EOF)
{
    /* ... */
}
当普通字节值和 EOF 经过 char 转换后混在一起时,循环可能提前结束,也可能永远无法识别真正的文件尾。
fputc 写出一个字符,成功时返回写出的字符值,失败时返回 EOF:
if (fputc('A', fp) == EOF)
{
    perror("fputc");
}
6.2 行读写:fgets 与 fputs
fgets 最多向数组写入 size - 1 个字符,并自动补 \0:
char *fgets(char *str, int size, FILE *stream);
常见循环:
char line[256];

while (fgets(line, sizeof line, fp) != NULL)
{
    fputs(line, stdout);
}
需要记住三点:
- 若在容量耗尽前读到换行,换行符会保留在数组中;
- 一行过长时,一次
fgets只能读到其中一段; - 返回
NULL既可能是到达文件尾,也可能是发生错误,之后可用feof与ferror区分。
fputs 写出一个以 \0 结尾的字符串,但不会像 puts 那样自动追加换行:
if (fputs("hello\n", fp) == EOF)
{
    perror("fputs");
}
6.3 格式化读写:fscanf 与 fprintf
fprintf 与 printf 的核心差别是多了一个目标流:
fprintf(fp, "%d %.2f\n", id, score);
printf("%d %.2f\n", id, score);
fscanf 与 scanf 同理,但可靠代码必须检查成功转换了几个字段:
int id;
double score;

while (fscanf(fp, "%d%lf", &id, &score) == 2)
{
    printf("id=%d, score=%.2f\n", id, score);
}
不能只写:
fscanf(fp, "%d%lf", &id, &score);
然后默认两个变量一定被更新。输入可能在第二个字段前结束,也可能出现不符合格式的文本。
对于字符串,还要限制最大宽度,避免数组越界:
char name[20];

if (fscanf(fp, "%19s", name) == 1)
{
    printf("%s\n", name);
}
6.4 scanf、fscanf、sscanf 的共同模型
这组三个函数都在做格式化输入,只是来源不同:
scanf   → 从 stdin 读取
fscanf  → 从指定 FILE* 读取
sscanf  → 从内存字符串读取
对应的输出函数是:
printf   → 写到 stdout
fprintf  → 写到指定 FILE*
sprintf  → 写到字符数组
工程中处理复杂文本时,常见的稳健策略是先用 fgets 取得完整一行,再用 sscanf、strtol 等函数解析。这样能把“读取边界”和“字段解析”分开,也更容易报告错误行。
6.5 块读写:fread 与 fwrite
接口形式为:
size_t fread(void *ptr, size_t size, size_t count, FILE *stream);
size_t fwrite(const void *ptr, size_t size, size_t count, FILE *stream);
size 是单个元素大小,count 是请求的元素数量,返回值是成功处理的完整元素个数,不是字节数。
写出数组:
double values[] = {1.0, 2.0, 3.0, 4.0, 5.0};
size_t count = sizeof values / sizeof values[0];

if (fwrite(values, sizeof values[0], count, fp) != count)
{
    perror("fwrite");
}
读回数组:
double values[5];
size_t got = fread(values, sizeof values[0], 5, fp);

for (size_t i = 0; i < got; ++i)
{
    printf("%.2f\n", values[i]);
}

if (got < 5)
{
    if (ferror(fp))
    {
        perror("fread");
    }
    else if (feof(fp))
    {
        puts("文件不足 5 个完整元素");
    }
}
若文件最后只剩不足一个完整元素的字节,fread 不会把它计入完整元素数量。自定义二进制格式应能识别这种截断文件,而不是默默把未填充的数组空间当作有效数据。
七、完整案例:保存并读取学生记录
这一节把打开、写入、关闭、读取和解析串成一条完整链路。为了便于查看和跨平台传递,我们先选择文本格式。
7.1 定义数据模型
#include <stdio.h>
#include <stdlib.h>

struct Student
{
    int id;
    char name[32];
    double score;
};
为简化示例,姓名中暂不允许空格。若需要保存任意文本,应设计转义、长度前缀或采用成熟格式,而不是简单用空格分隔。
7.2 写入记录
static int save_students(const char *path,
                         const struct Student *students,
                         size_t count)
{
    FILE *fp = fopen(path, "w");

    if (fp == NULL)
    {
        perror("fopen for writing");
        return 0;
    }

    int ok = 1;

    for (size_t i = 0; i < count; ++i)
    {
        if (fprintf(fp, "%d %s %.17g\n",
                    students[i].id,
                    students[i].name,
                    students[i].score) < 0)
        {
            perror("fprintf");
            ok = 0;
            break;
        }
    }

    if (fclose(fp) == EOF)
    {
        perror("fclose after writing");
        ok = 0;
    }

    return ok;
}
这里把关闭放在统一出口执行。即使中途某次 fprintf 失败,也仍然尝试关闭流。
%.17g 用于在常见 IEEE 754 双精度实现上保留足够的十进制有效数字,以便往返恢复;若文件格式面向不同实现,仍需明确浮点语义。
7.3 读取记录
static int load_students(const char *path,
                         struct Student *students,
                         size_t capacity,
                         size_t *out_count)
{
    FILE *fp = fopen(path, "r");

    if (fp == NULL)
    {
        perror("fopen for reading");
        return 0;
    }

    size_t count = 0;
    int ok = 1;

    while (count < capacity)
    {
        int converted = fscanf(fp, "%d%31s%lf",
                               &students[count].id,
                               students[count].name,
                               &students[count].score);

        if (converted == EOF)
        {
            if (ferror(fp))
            {
                perror("fscanf");
                ok = 0;
            }
            break;
        }

        if (converted != 3)
        {
            fprintf(stderr, "记录格式错误,已读取 %zu 条\n", count);
            ok = 0;
            break;
        }

        ++count;
    }

    if (fclose(fp) == EOF)
    {
        perror("fclose after reading");
        ok = 0;
    }

    *out_count = count;
    return ok;
}
这个循环区分了三种情况:
- 成功转换 3 个字段:接受一条记录;
- 返回
EOF:没有读到新的字段,再看是否发生 I/O 错误; - 返回 0、1 或 2:文件中出现了不完整或非法记录。
7.4 调用示例
int main(void)
{
    struct Student source[] = {
        {1001, "Alice", 92.5},
        {1002, "Bob", 88.0},
        {1003, "Carol", 95.25}
    };

    size_t source_count = sizeof source / sizeof source[0];

    if (!save_students("students.txt", source, source_count))
    {
        return EXIT_FAILURE;
    }

    struct Student loaded[10];
    size_t loaded_count = 0;

    if (!load_students("students.txt",
                       loaded,
                       sizeof loaded / sizeof loaded[0],
                       &loaded_count))
    {
        return EXIT_FAILURE;
    }

    for (size_t i = 0; i < loaded_count; ++i)
    {
        printf("%d %-10s %.2f\n",
               loaded[i].id,
               loaded[i].name,
               loaded[i].score);
    }

    return EXIT_SUCCESS;
}
这个案例仍然只是教学格式。真正需要可靠保存用户文本时,还应考虑空格、换行、编码、字段转义、版本升级以及先写临时文件再原子替换等策略。
八、随机读写:fseek、ftell 与 rewind
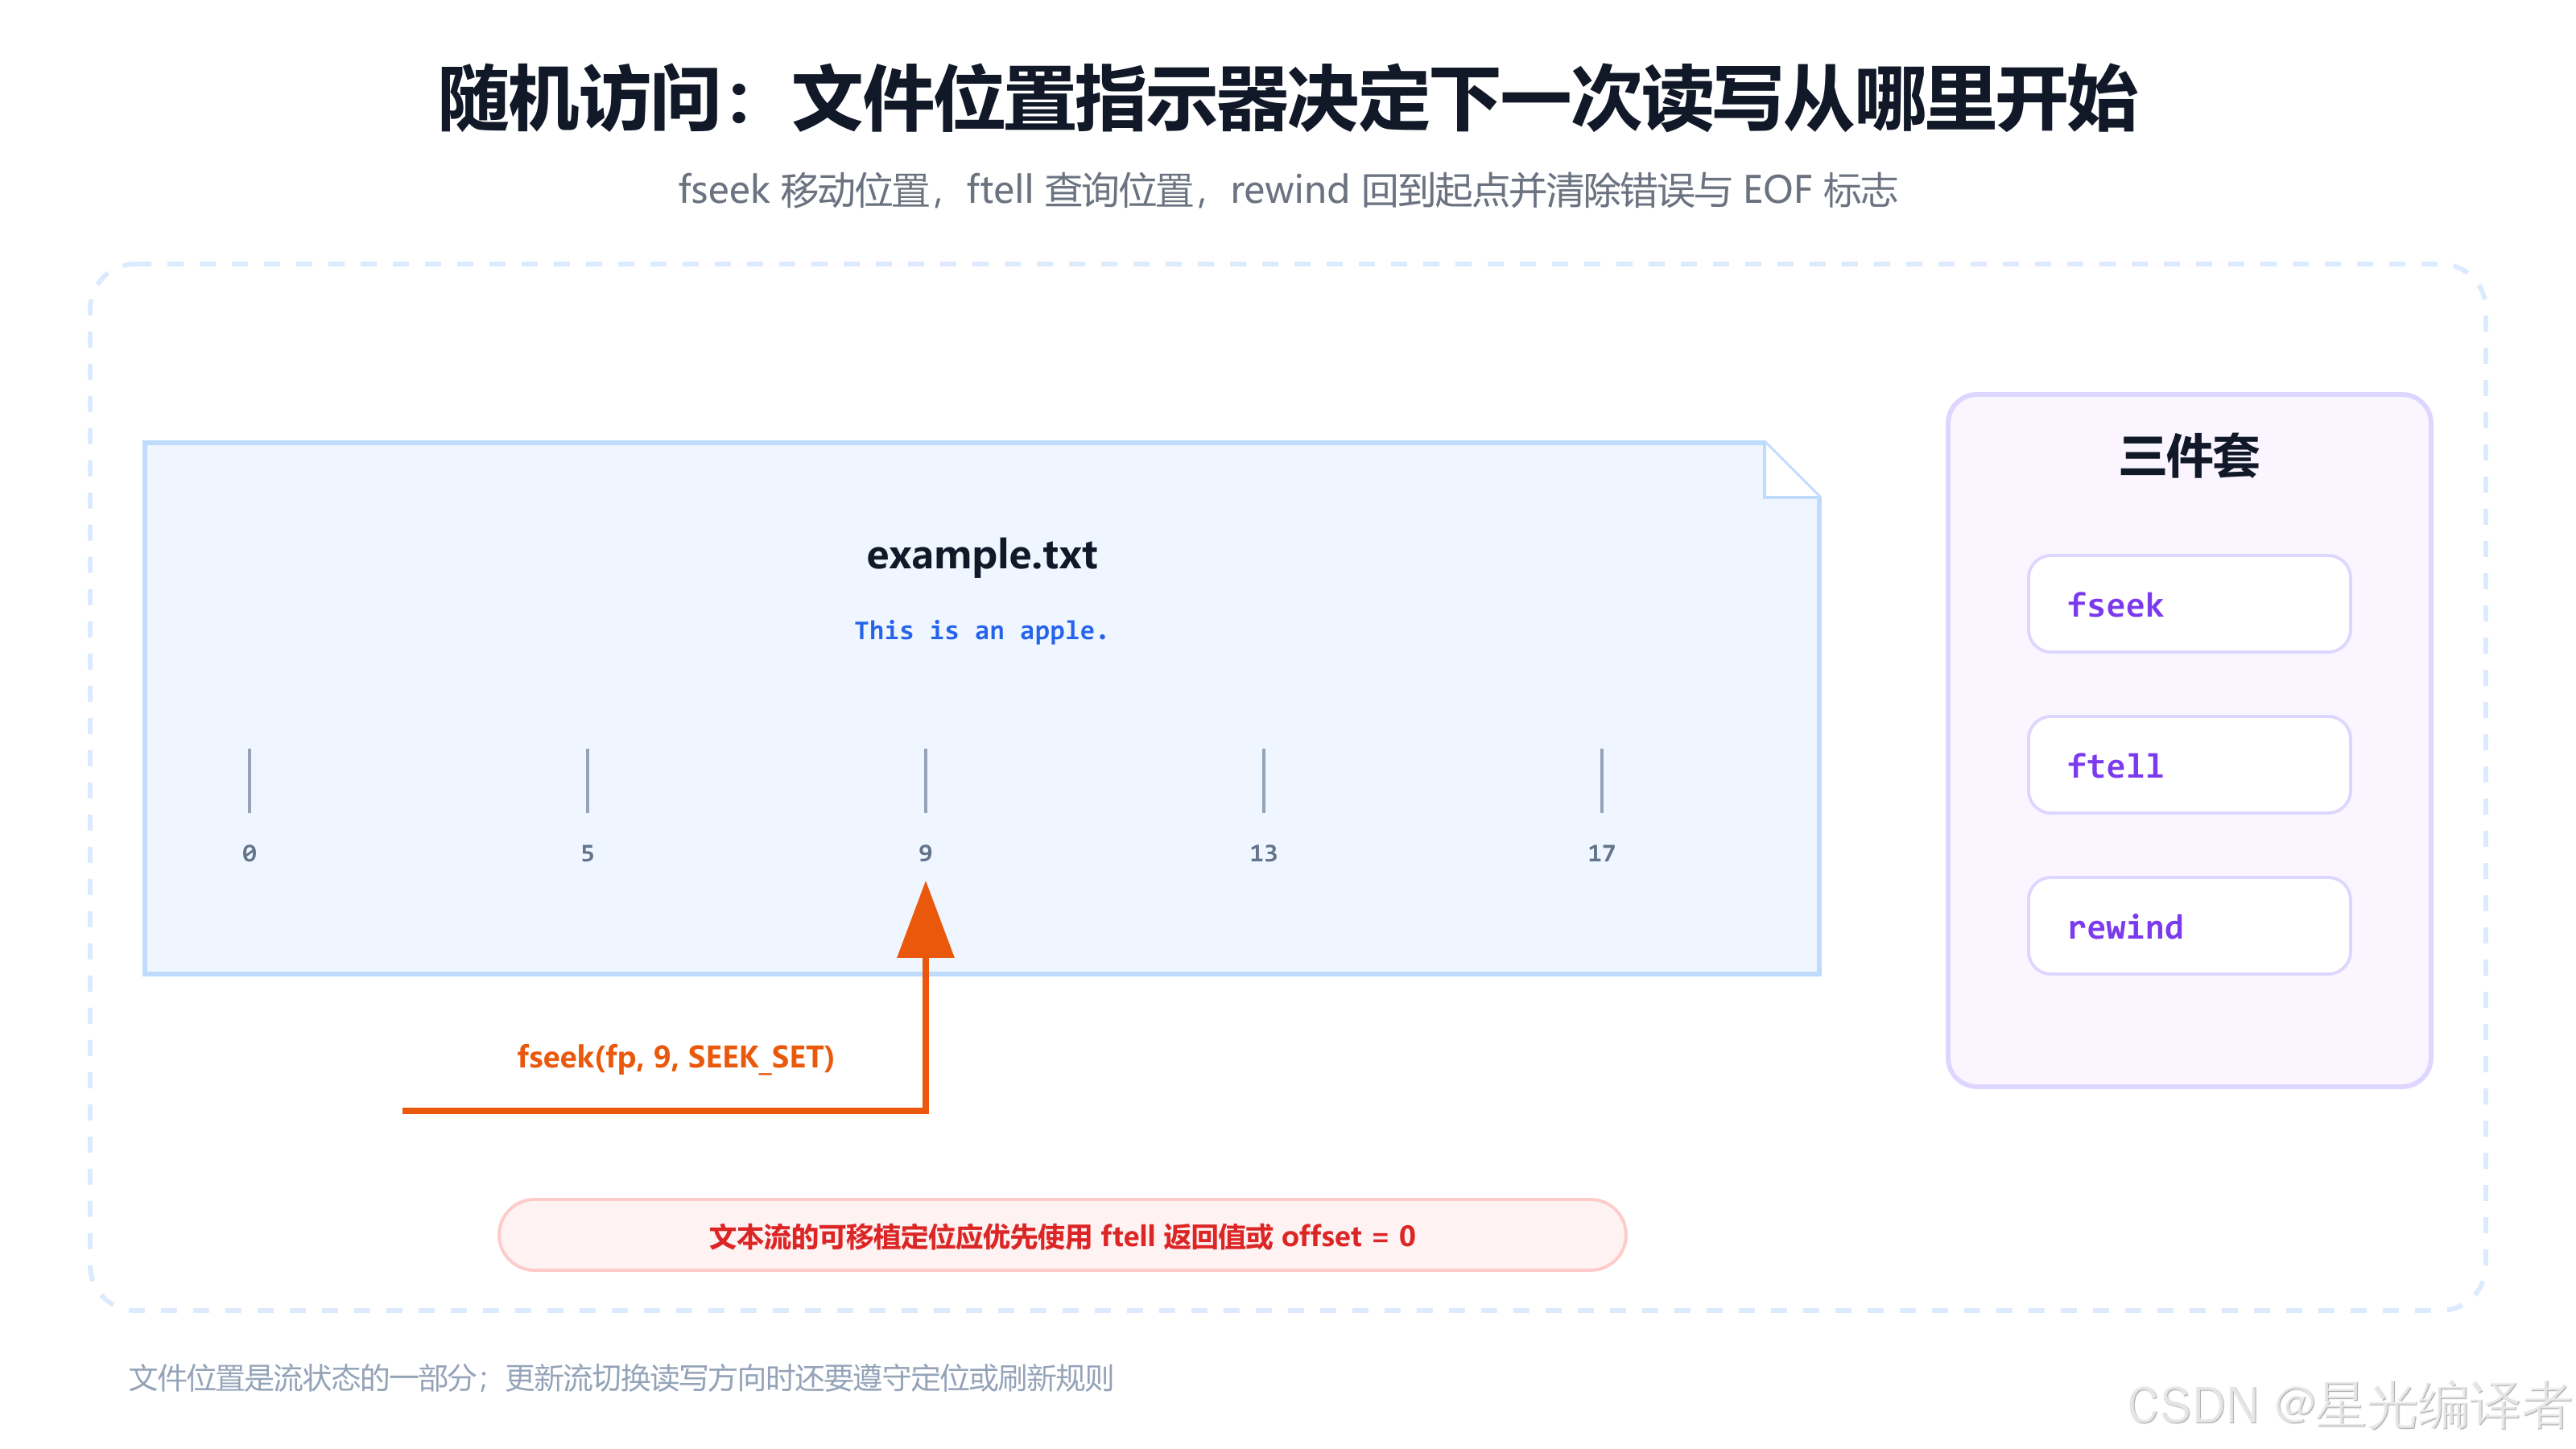
顺序读写从当前位置向后推进;随机访问则允许程序显式修改文件位置指示器。
8.1 fseek:移动文件位置
int fseek(FILE *stream, long offset, int origin);
origin 常用三个值:
| 起点 | 含义 |
|---|---|
SEEK_SET | 文件开头 |
SEEK_CUR | 当前位置 |
SEEK_END | 文件末尾 |
例如课程中的思路:
FILE *fp = fopen("example.txt", "wb");

if (fp == NULL)
{
    return 1;
}

fputs("This is an apple.", fp);

if (fseek(fp, 9L, SEEK_SET) != 0)
{
    perror("fseek");
    fclose(fp);
    return 1;
}

fputs(" sam", fp);
fclose(fp);
偏移 9 处原本开始于 an apple...,写入 " sam" 会覆盖对应位置的已有字节,不会自动把后续内容整体向右移动。文件不是文本编辑器中的“插入模型”。
8.2 ftell:查询当前位置
long ftell(FILE *stream);
成功时返回可供后续 fseek(..., SEEK_SET) 使用的位置值,失败时返回 -1L:
long pos = ftell(fp);

if (pos == -1L)
{
    perror("ftell");
}
在常见普通二进制文件上,下面的方法常用于取得文件长度:
if (fseek(fp, 0L, SEEK_END) != 0)
{
    /* 处理错误 */
}

long size = ftell(fp);
但不要把它写成对所有流都成立的绝对规则:某些设备不可定位,long 的范围也可能不足以表示超大文件。生产代码处理大文件时,通常需要平台提供的 64 位接口或文件状态 API。
8.3 rewind:回到开头
void rewind(FILE *stream);
它把位置移回文件开头,并清除该流的 EOF 与错误标志。可把它理解为接近:
fseek(stream, 0L, SEEK_SET);
clearerr(stream);
区别是 rewind 没有返回值,不能直接通过返回值报告定位失败。若需要知道是否成功,应使用 fseek 并检查结果。
8.4 文本流定位的可移植边界
在二进制流中,偏移通常按字节理解;文本流可能存在换行转换,因此标准对任意偏移有更多限制。编写可移植代码时,文本流应优先:
- 使用
offset == 0配合SEEK_SET、SEEK_CUR或SEEK_END; - 或把先前
ftell返回的位置原样交回fseek(..., SEEK_SET)。
不要默认“第 N 个可见字符一定等于偏移 N”,尤其是在存在多字节编码和文本模式转换时。
8.5 固定大小记录的随机访问
二进制固定记录可以根据索引计算位置:
struct Record
{
    int id;
    char name[32];
};

long index = 10;

if (fseek(fp, index * (long)sizeof(struct Record), SEEK_SET) != 0)
{
    perror("fseek record");
}
这只适合与当前 struct Record 对象布局一致的文件。若文件要长期保存或跨程序共享,仍应定义固定宽度字段与稳定的序列化格式,而不是让 sizeof(struct Record) 成为文件协议。
九、文件读取结束的正确判定
9.1 feof 最常见的误用
错误写法:
while (!feof(fp))
{
    int ch = fgetc(fp);
    putchar(ch);
}
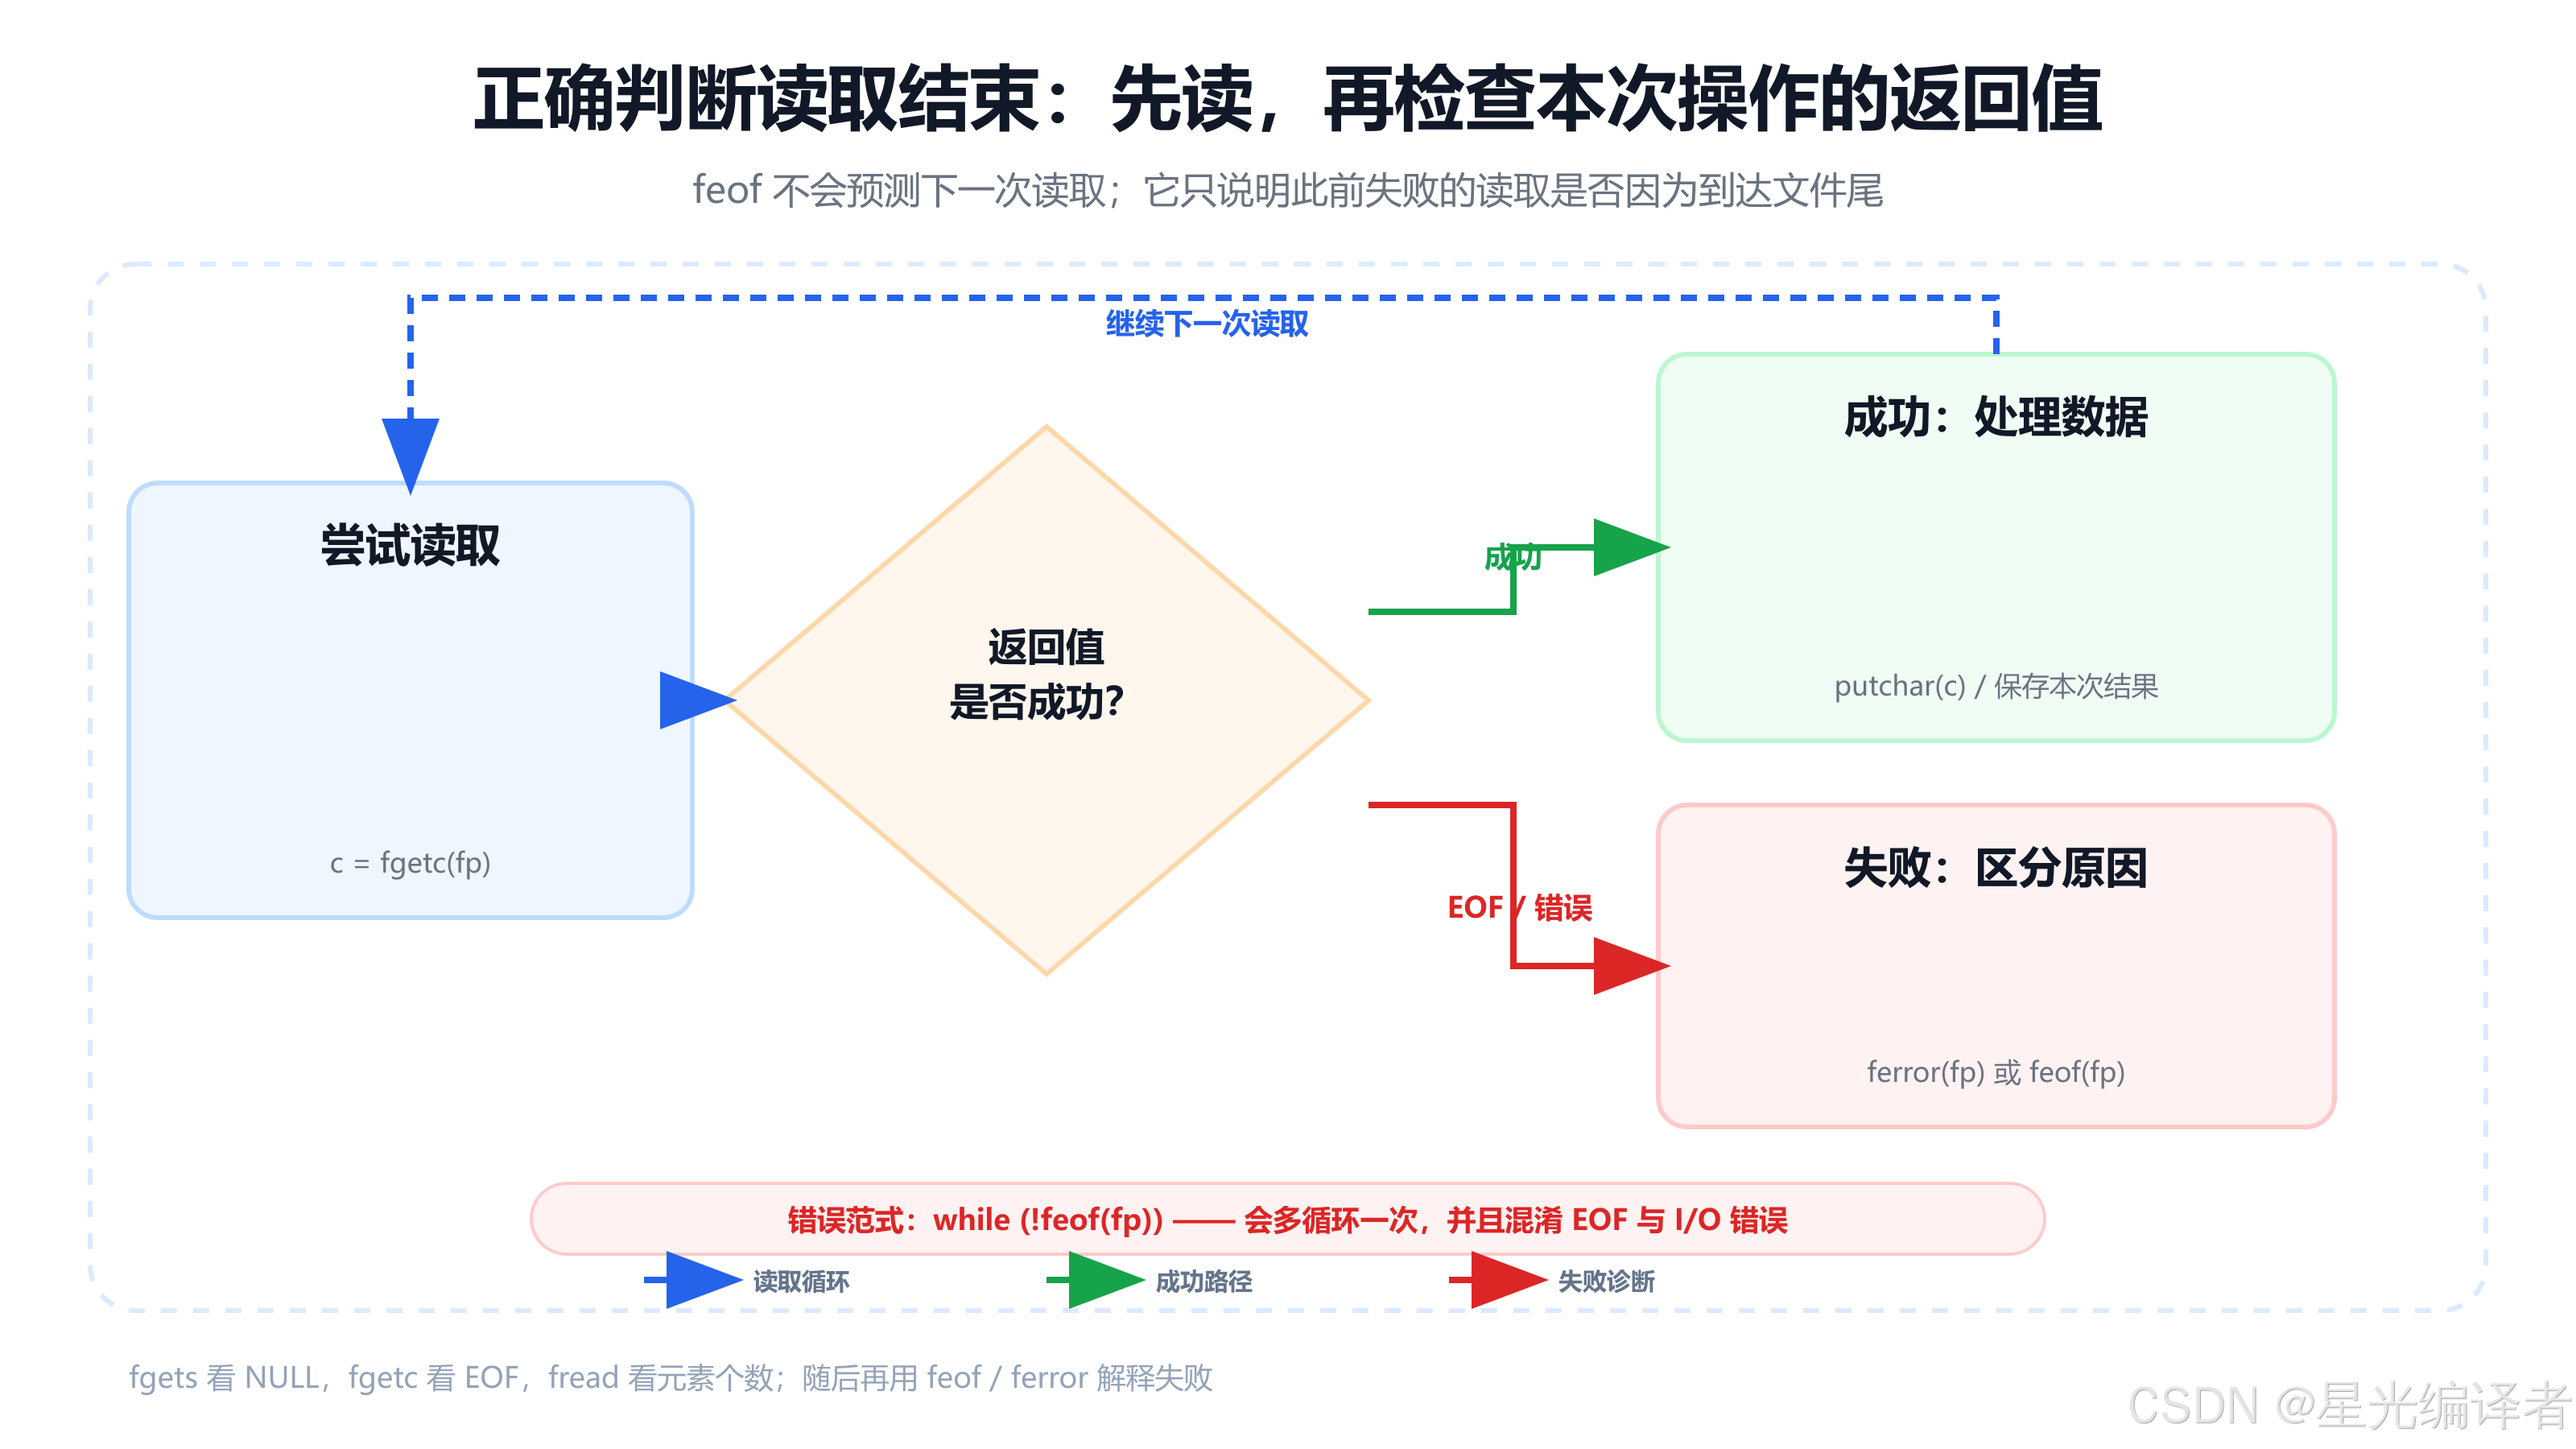
feof 不会提前告诉程序“下一次读取将到达文件尾”。只有一次读取尝试因为文件尾而失败后,EOF 标志才会被设置。因此上述循环通常会多执行一次,还可能把 EOF 当作普通字符处理。
正确模型是:
尝试读取 → 检查本次返回值 → 成功就处理 → 失败再判断原因
9.2 fgetc 循环
int ch;

while ((ch = fgetc(fp)) != EOF)
{
    putchar(ch);
}

if (ferror(fp))
{
    perror("fgetc");
}
else if (feof(fp))
{
    puts("正常到达文件尾");
}
fgetc 在“文件尾”和“读取错误”两种情况下都返回 EOF,所以循环退出后再用状态函数解释原因。
9.3 fgets 循环
char line[256];

while (fgets(line, sizeof line, fp) != NULL)
{
    fputs(line, stdout);
}

if (ferror(fp))
{
    perror("fgets");
}
若最后一行没有换行,fgets 仍能成功返回这一行;下一次读取才会返回 NULL 并设置 EOF 标志。
9.4 fread 循环
复制文件时常用字节块循环:
unsigned char buffer[4096];
size_t n;

while ((n = fread(buffer, 1, sizeof buffer, in)) > 0)
{
    size_t written = 0;

    while (written < n)
    {
        size_t part = fwrite(buffer + written, 1, n - written, out);

        if (part == 0)
        {
            if (ferror(out))
            {
                perror("fwrite");
            }
            return 0;
        }

        written += part;
    }
}

if (ferror(in))
{
    perror("fread");
    return 0;
}
这里以字节为元素,fread 的返回值就是本轮得到的字节数。最后一轮少于 4096 字节完全可能是正常文件尾;只有检查状态后才能决定是否发生错误。
9.5 clearerr 有什么用
clearerr(fp) 会清除流的 EOF 和错误标志。它不移动文件位置,也不会修复底层故障:
clearerr(fp);
如果想在到达文件尾后重新从头读取,可以:
rewind(fp);
rewind 同时回到开头并清除状态。若错误来自磁盘、设备或无效操作,仅清标志并不会让后续操作必然成功,程序仍需理解并处理根因。
十、文件缓冲区与 fflush
10.1 为什么标准 I/O 要缓冲
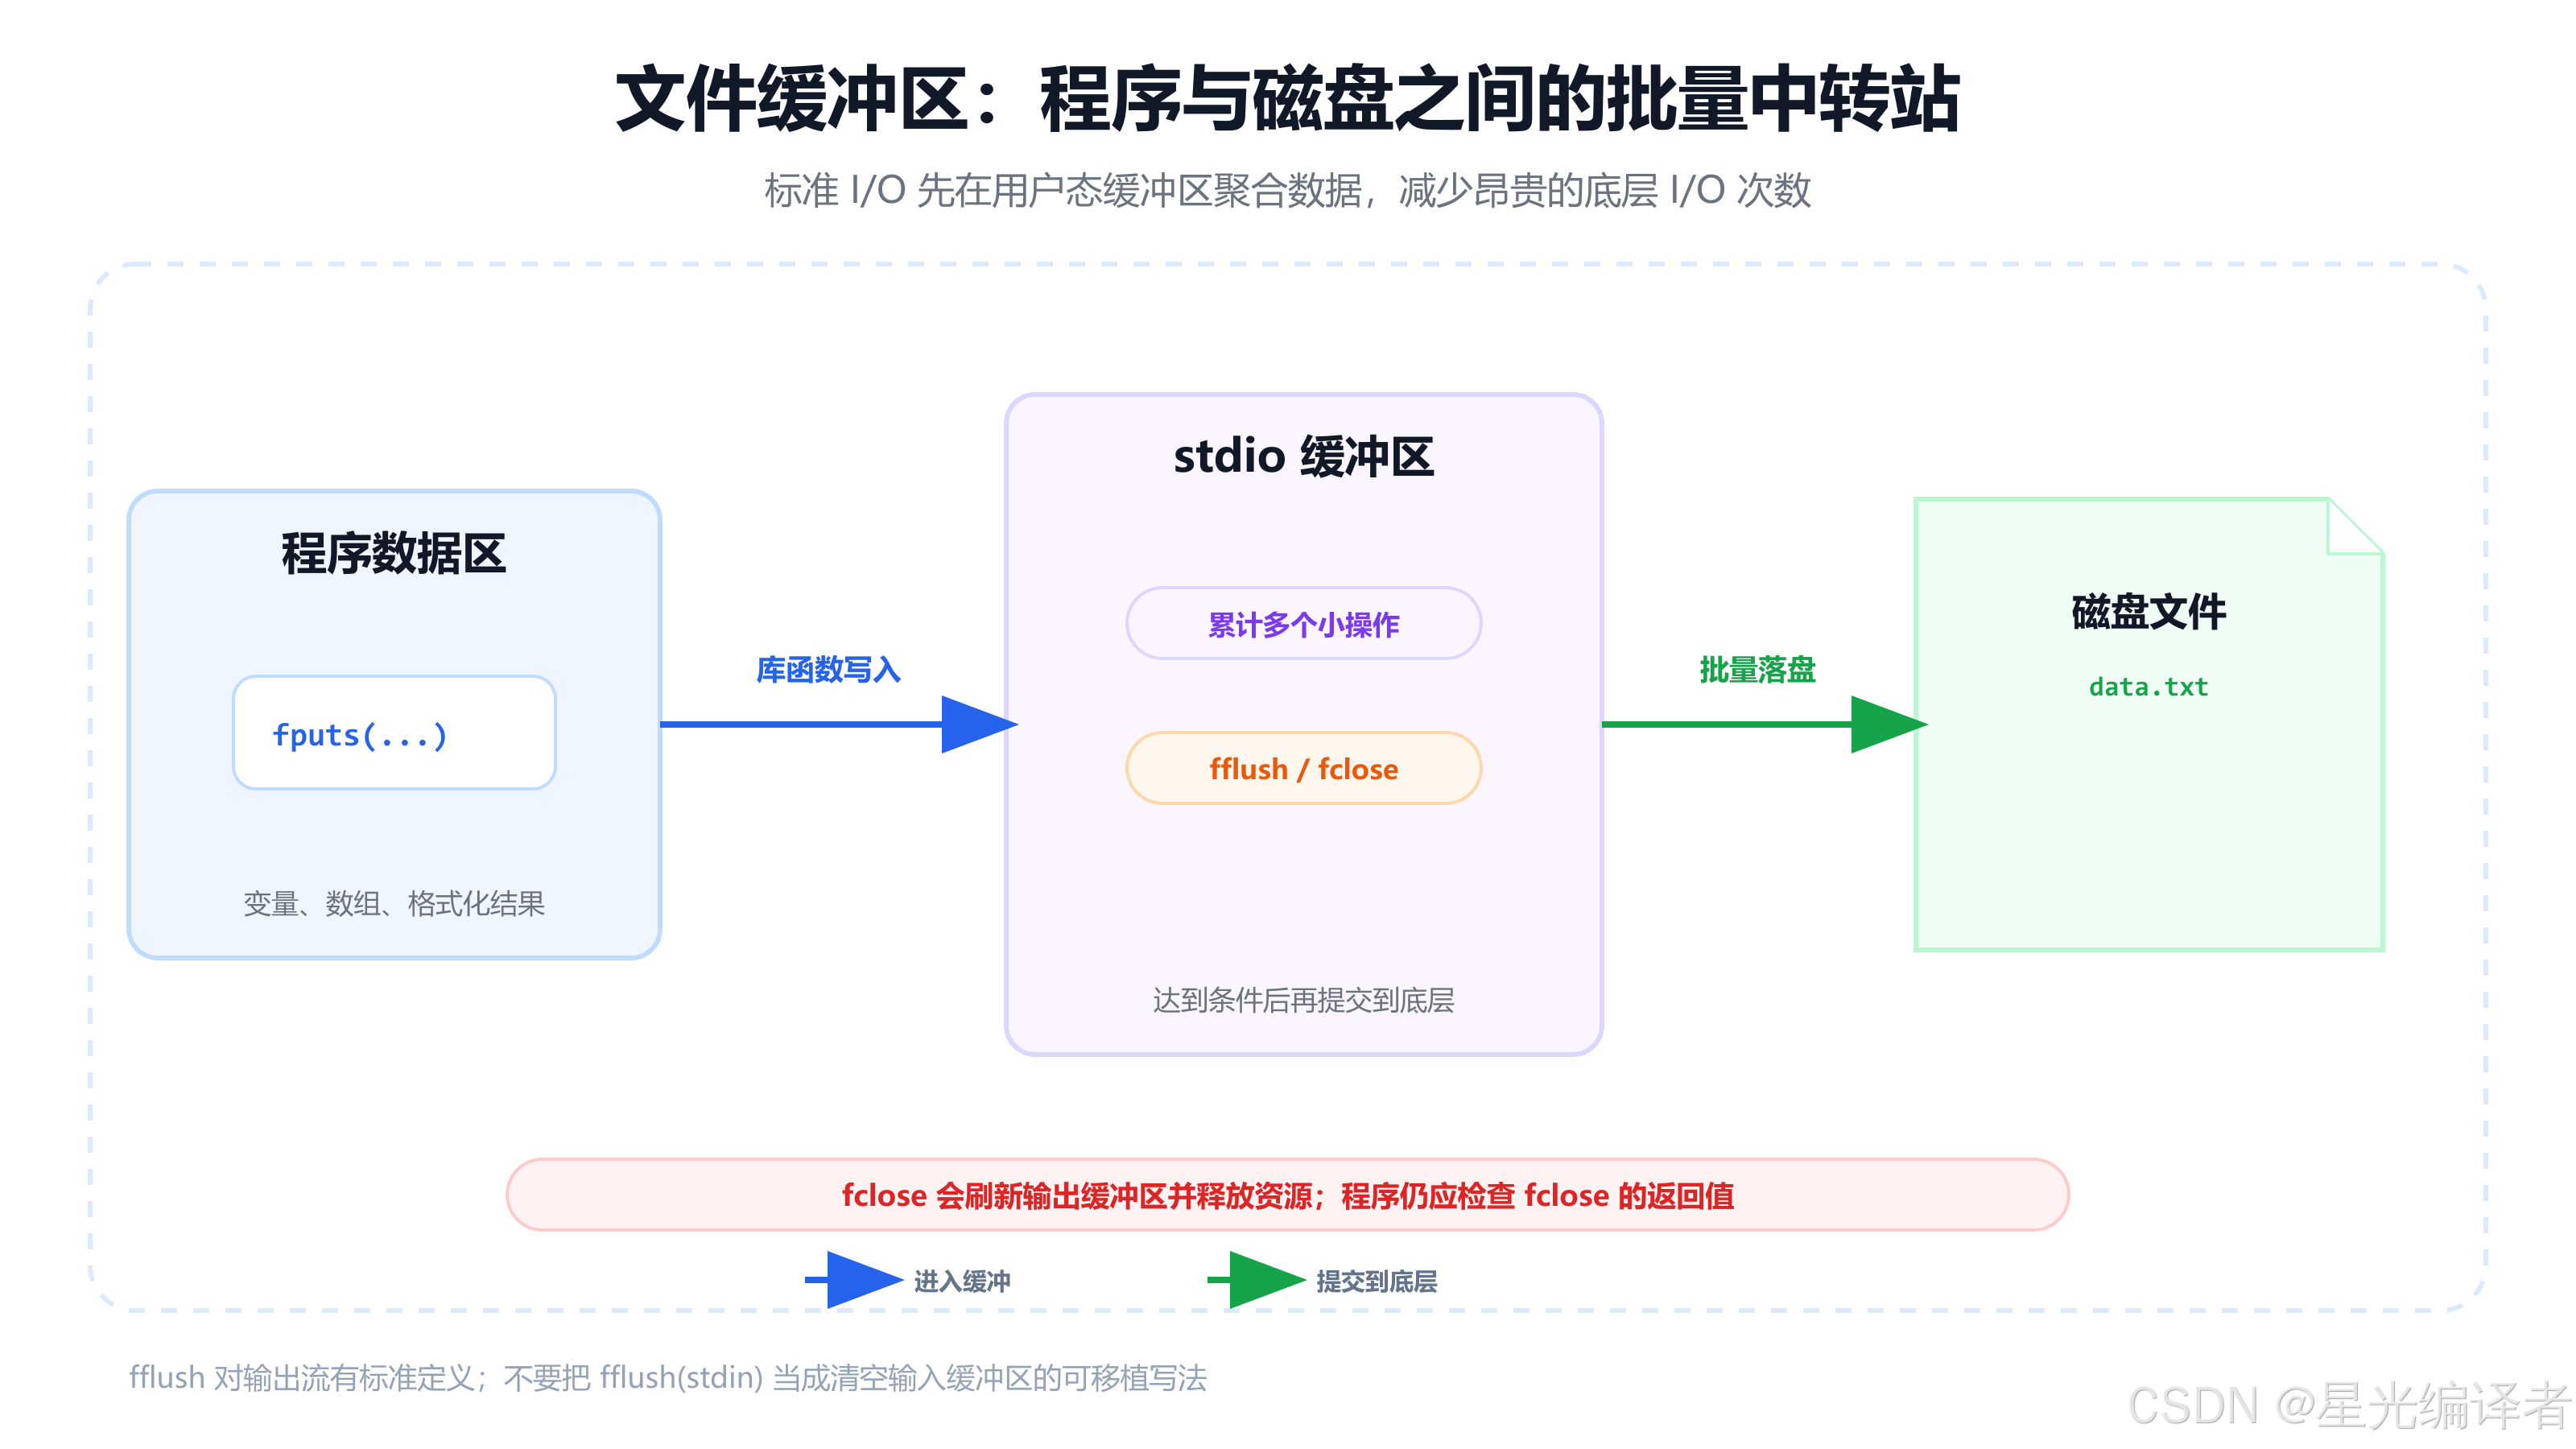
一次底层磁盘或设备操作通常比一次内存访问昂贵得多。如果每写一个字符都立刻发起底层 I/O,效率会很差。标准 I/O 库会为流维护缓冲区,把多个小操作聚合起来,再按条件批量提交。
写入路径可以理解为:
程序变量 → stdio 缓冲区 → 操作系统 / 设备 → 文件
读取也类似:库可能一次从底层取得一批数据,再逐步交给 fgetc、fgets 或 fread。
10.2 什么时候数据会被提交
输出缓冲区通常可能在以下时机被提交:
- 缓冲区装满;
- 对输出流调用
fflush; - 调用
fclose; - 程序通过
exit正常终止时,标准库执行正常收尾; - 某些终端行缓冲场景遇到换行或输入请求。
不要把程序崩溃、abort、强制结束进程或突然断电视为可靠刷新时机。重要数据需要更完整的持久化设计,fflush 也不等同于保证物理介质已经完成写入。
10.3 fflush 的正确使用
接口为:
int fflush(FILE *stream);
对于带有待写数据的输出流或更新流,fflush 请求把标准库缓冲的数据提交给底层:
if (fflush(fp) == EOF)
{
    perror("fflush");
}
对所有输出流进行刷新可以传空指针:
fflush(NULL);
这里必须澄清一个常见误区:标准 C 中,对输出流使用 fflush 是正常、标准的操作。 不可移植的是把 fflush(stdin) 当作“清空键盘输入缓冲区”的通用方法。输入清理由读取和丢弃规则完成,不应依赖某个编译器扩展。
10.4 fclose 为什么仍然要检查
fclose 会处理尚未写出的缓冲数据并解除流关联:
if (fclose(fp) == EOF)
{
    perror("fclose");
}
若底层设备空间不足、网络文件系统失败或其他写入错误延迟出现,关闭阶段可能是程序第一次收到错误。因此,“前面的 fprintf 都成功了”不能成为忽略 fclose 返回值的理由。
10.5 stdout 与 stderr 的区别
stdout 和 stderr 都可能显示在终端,但用途不同。普通结果写到 stdout,诊断信息写到 stderr:
printf("处理完成:%zu 条记录\n", count);
fprintf(stderr, "第 %zu 行格式错误\n", line_number);
这样用户可以单独重定向结果与错误:
program > result.txt 2> error.txt
不要依赖“stderr 永远完全无缓冲”这样的过度简化;标准对其初始状态与交互行为有规定,但具体重定向环境和实现仍可能影响观察到的时序。真正需要顺序保证时,应显式刷新相关输出流。
十一、可靠文件程序的设计方法
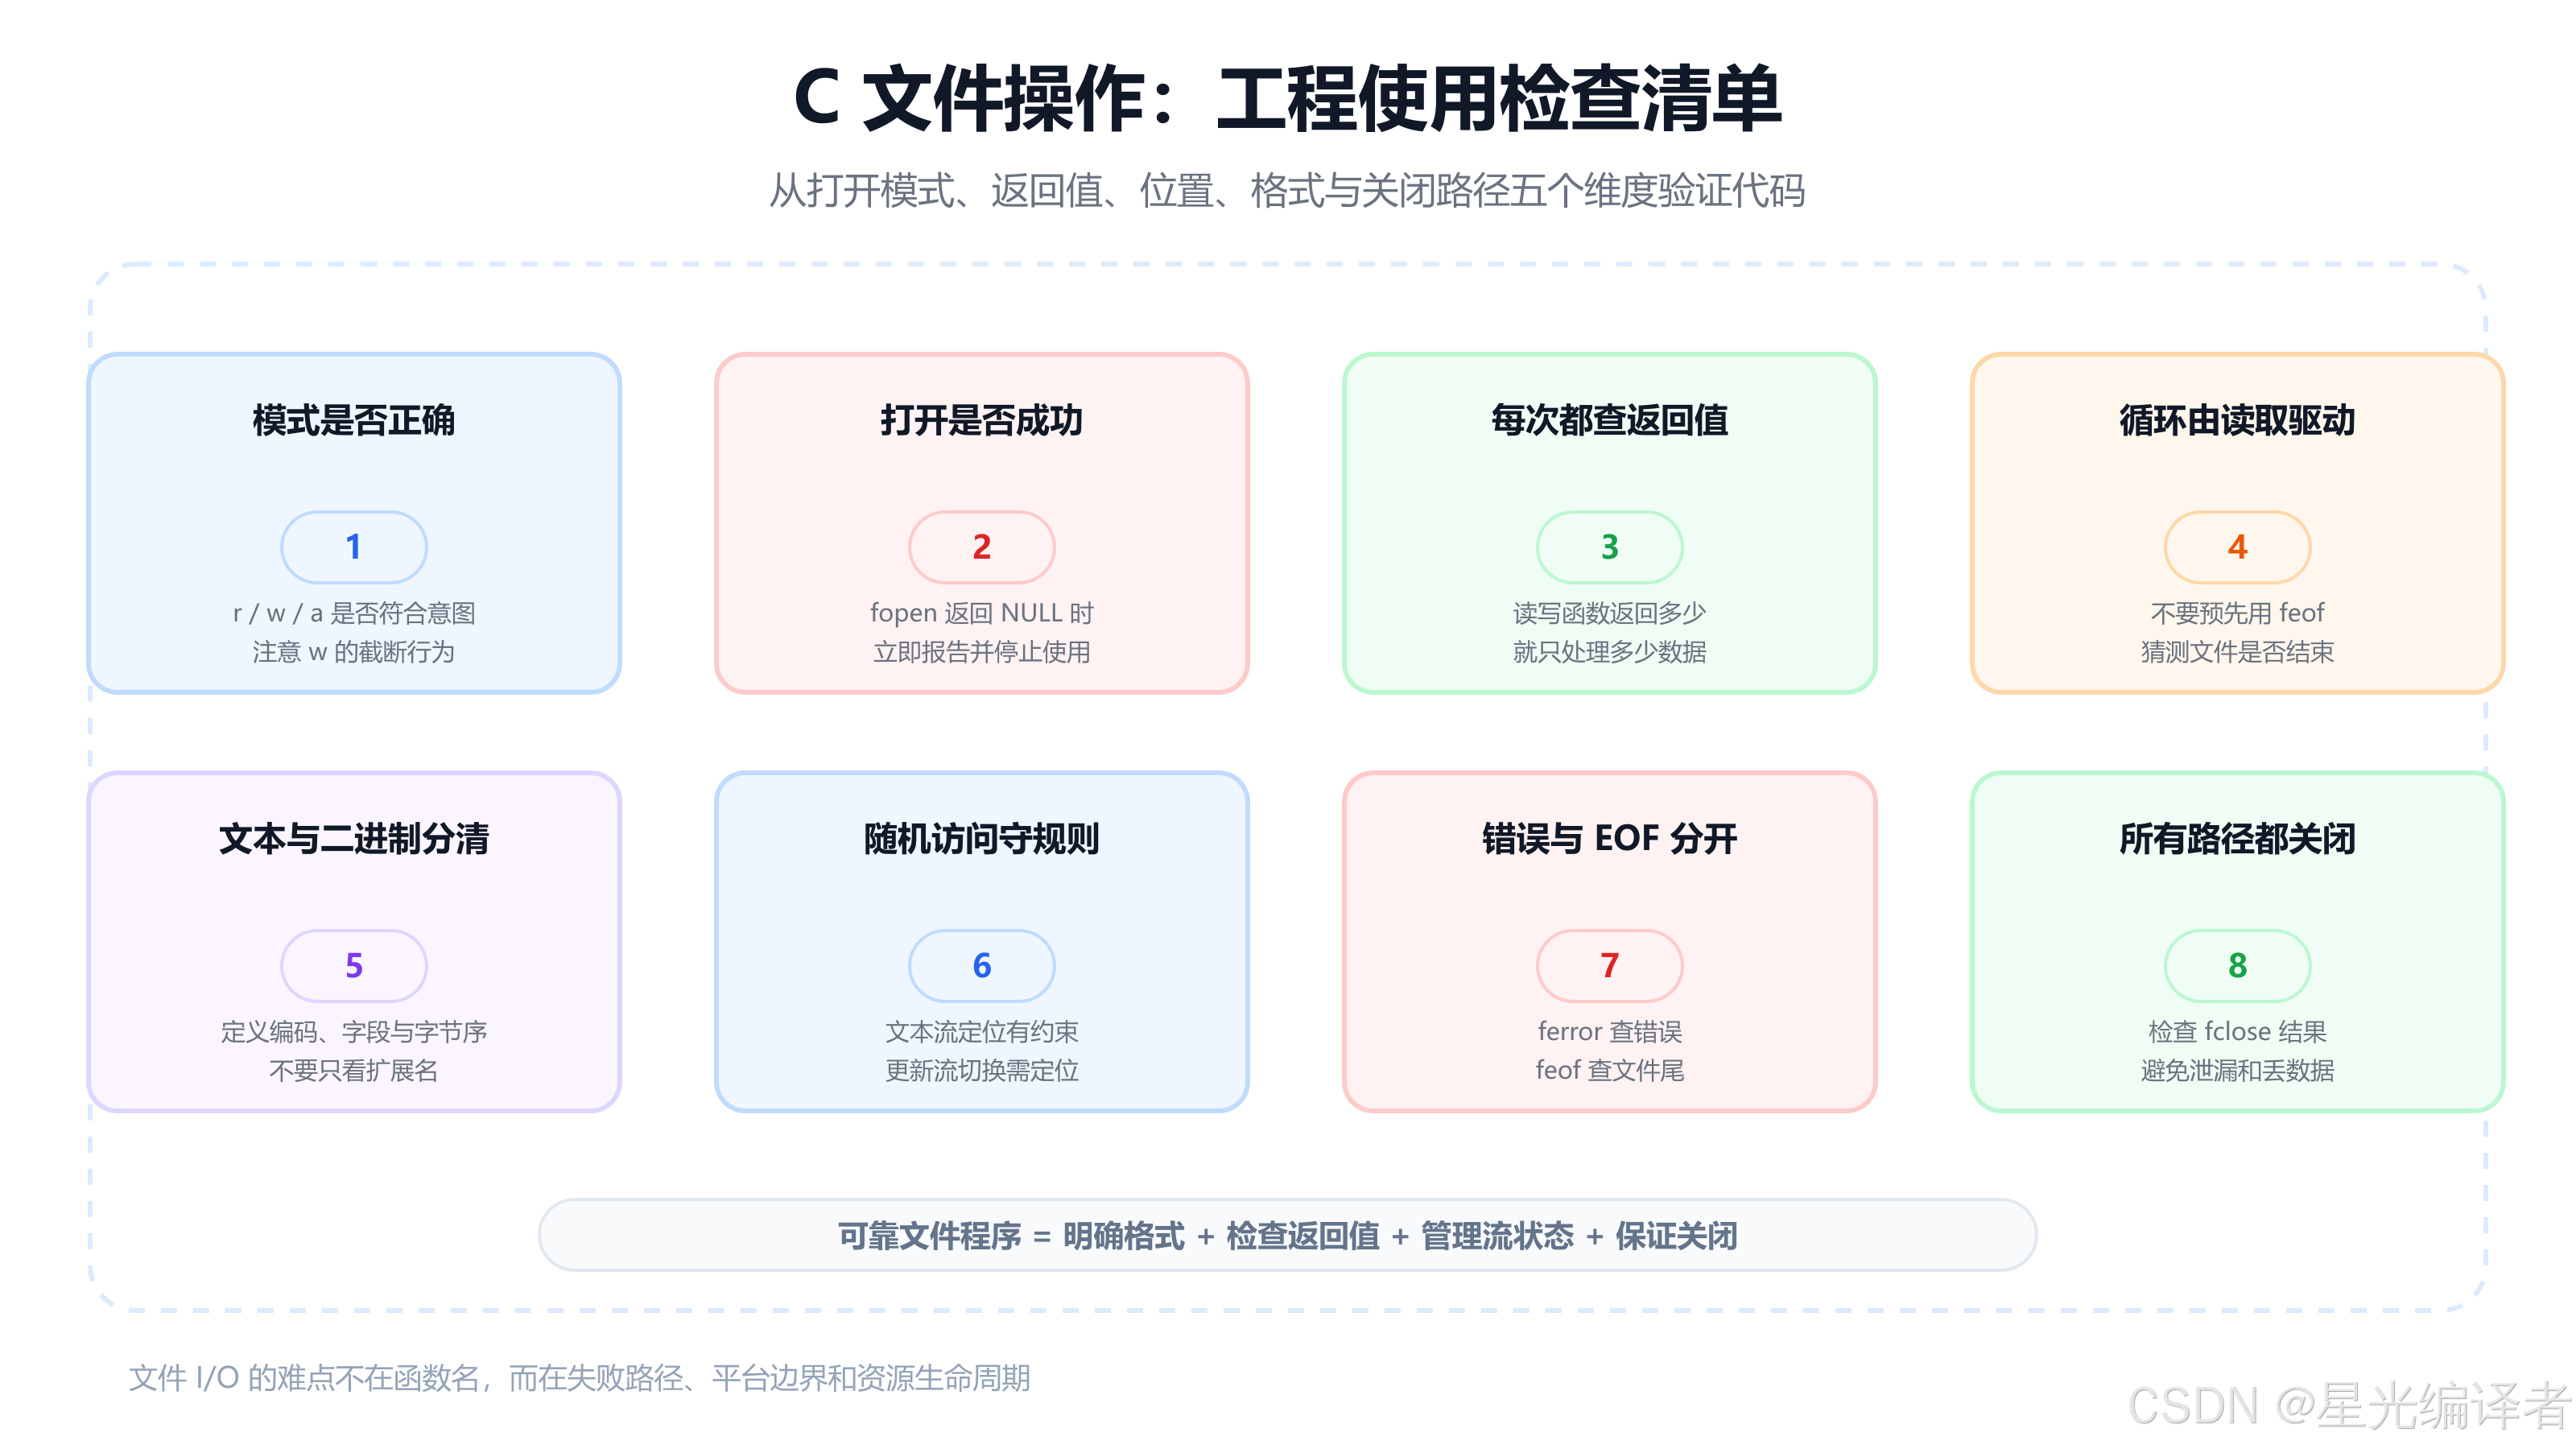
11.1 把资源生命周期画成一条直线
一个函数只管理一个文件时,尽量让流程清楚:
参数验证
  ↓
fopen
  ↓
检查返回值
  ↓
读写循环
  ↓
统一 fclose
  ↓
返回最终状态
若函数中途有多个失败点,可以使用一个清理出口,避免漏关文件:
int process_file(const char *path)
{
    int ok = 0;
    FILE *fp = fopen(path, "rb");

    if (fp == NULL)
    {
        perror("fopen");
        return 0;
    }

    if (!read_header(fp))
    {
        goto cleanup;
    }

    if (!read_body(fp))
    {
        goto cleanup;
    }

    ok = 1;

cleanup:
    if (fclose(fp) == EOF)
    {
        perror("fclose");
        ok = 0;
    }

    return ok;
}
在 C 中,goto cleanup 是资源清理的常见用法。它避免复制多段 fclose,也减少后续新增资源时遗漏某条错误路径的概率。
11.2 写文件时避免直接破坏原文件
若更新重要配置或存档,直接使用 w 打开原文件会先截断。一旦后续写入失败,旧数据也已经消失。更稳妥的基本思路是:
- 在同一目录写入临时文件;
- 检查所有写入和关闭操作;
- 必要时进行更强的持久化同步;
- 成功后再用平台支持的原子替换方式替换目标文件。
标准 C 的 rename 提供重命名接口,但“覆盖已存在目标是否原子、断电后是否持久”等语义取决于操作系统和文件系统。关键业务不能只凭一个库函数名字推断完整事务保证。
11.3 明确定义文件格式
一个可维护格式至少应回答:
- 文件开头如何识别格式;
- 当前版本是多少;
- 每个字段的类型、范围和编码是什么;
- 变长字段怎样表示长度;
- 整数和浮点怎样序列化;
- 如何发现截断或损坏;
- 新版本怎样兼容旧文件。
简单二进制头可以使用“魔数 + 版本 + 长度”的思路,但写入时仍需逐字段编码:
4 bytes magic
2 bytes version
2 bytes flags
4 bytes payload_length
N bytes payload
4 bytes checksum
这比 fwrite(&object, sizeof object, 1, fp) 更啰嗦,却把协议从编译器内存布局中解耦出来。
11.4 对外部文件永远不信任
文件可能来自旧版本、用户编辑、下载失败、恶意输入或磁盘损坏。读取前后都要验证:
- 长度是否在合理范围;
- 计数乘元素大小是否溢出;
- 字符串是否有终止符或明确长度;
- 枚举值是否落在有效集合;
- 索引与偏移是否越界;
- 文件是否在字段中途截断;
- 校验和是否匹配。
不要先按文件中的巨大长度分配内存,再考虑它是否可信:
if (length > MAX_PAYLOAD)
{
    /* 拒绝异常文件 */
}
11.5 文本解析不要吞掉错误
若使用 fscanf,返回值不足时要决定怎样处理剩余字符,否则下一轮可能在同一非法位置重复失败。复杂格式更适合逐行读取:
char line[512];
size_t line_number = 0;

while (fgets(line, sizeof line, fp) != NULL)
{
    ++line_number;

    int id;
    double score;
    char extra;

    if (sscanf(line, " %d %lf %c", &id, &score, &extra) != 2)
    {
        fprintf(stderr, "第 %zu 行格式错误\n", line_number);
        continue;
    }

    /* 使用 id 与 score */
}
末尾的 %c 用于发现额外的非空白内容。真实项目还应处理超长行:若缓冲区中没有换行且流中仍有剩余字符,就不能把当前片段误认为完整记录。
十二、高频问题、易错点与练习
12.1 高频问题
Q1:FILE * 是不是磁盘文件的地址?
不是。它是指向标准库流对象的指针,流对象维护缓冲、状态、位置和底层关联。不要对它做地址运算,也不要访问实现私有字段。
Q2:为什么 fopen 返回 NULL?
可能是路径错误、当前工作目录不符合预期、父目录不存在、权限不足、文件被其他程序以冲突方式占用、打开文件过多或设备故障。应在失败后及时使用 perror 或保存并解释 errno,不要继续把空指针传给 I/O 函数。
Q3:w 和 a 最大的区别是什么?
w 成功打开已有文件时立即截断;a 保留原内容,并让写入发生在文件末尾。需要改写文件中间位置时,a 并不合适。
Q4:为什么 fgets 读到的字符串里还有 \n?
因为只要缓冲区有空间,fgets 会保留本次读到的换行。需要去掉时应显式处理:
#include <string.h>

line[strcspn(line, "\r\n")] = '\0';
这种写法可以处理常见的 \n 和 \r\n 行尾;若行中本来就允许嵌入相关字符,格式设计需要更明确。
Q5:为什么 fgetc 的返回值必须存到 int?
因为它既要覆盖所有可能的字节值,也要额外表达 EOF。char 不保证能同时无歧义地表达这两类结果。
Q6:feof 什么时候才会变成真?
在一次读取尝试因为到达文件尾而失败后。它不是“是否已经站在最后一个字节”的预测函数。
Q7:fread 返回 0 一定是文件尾吗?
不一定。可能请求数量本来就是 0,也可能到达文件尾,也可能发生错误。结合参数和 feof、ferror 判断。
Q8:fflush(fp) 会保证断电后数据也存在吗?
不能这样保证。它刷新的是 C 标准 I/O 层到宿主环境;操作系统和存储设备还可能继续缓存。强持久性需要平台级同步、正确的替换协议和对文件系统语义的理解。
Q9:可以直接 fwrite 指针吗?
可以写出指针变量本身的字节,但这个地址在另一次运行、另一个进程或另一台机器上通常毫无意义。要保存的是指针指向的数据和对象关系,而不是虚拟地址数值。
Q10:为什么 printf(buffer); 不安全?
buffer 会被当作格式字符串。若文件内容包含 %,就可能触发未定义行为或格式字符串漏洞。应写成:
printf("%s", buffer);
或者:
fputs(buffer, stdout);
12.2 常见错误清单
fopen失败后仍然使用fp;- 用
w打开重要文件,却没意识到它会立即截断; - 用
while (!feof(fp))控制读取循环; - 用
char保存fgetc返回值; - 忽略
fread、fwrite实际处理的元素个数; - 把
fread返回值误认为字节数; - 认为
fputs会自动写换行; - 认为
b会自动完成二进制序列化; - 把含指针或填充的结构体直接当作长期文件格式;
- 在更新流上直接交叉读写,没有定位或刷新;
- 用
printf(buffer)输出来自文件的字符串; - 只检查写函数,不检查
fflush或fclose; - 错误路径提前
return,导致文件没有关闭; - 假定相对路径相对于源文件目录;
- 把
fflush(stdin)当作可移植的输入清理方法。
12.3 动手练习
- 编写程序逐字符复制文本文件,并分别统计字符数与换行数。
- 使用
fgets逐行读取日志,为每行添加行号后输出到新文件。 - 使用
fprintf保存 5 条学生记录,再用fscanf读回并计算平均分。 - 修改第 3 题,让程序能报告具体哪一行格式错误。
- 使用
fread与fwrite实现通用二进制文件复制,并处理短写。 - 创建固定大小整数数组文件,用
fseek读取第 N 个元素。 - 故意写出
while (!feof(fp))版本,与正确版本对比循环次数和输出。 - 构造一个只有最后一行没有换行符的文本文件,验证
fgets的行为。 - 设计一个包含魔数、版本、记录数的简单二进制格式,并拒绝异常记录数。
- 把“直接覆盖配置文件”改成“写临时文件,全部成功后再替换”的流程。
12.4 文件复制参考骨架
#include <stdio.h>
#include <stdlib.h>

static int copy_stream(FILE *in, FILE *out)
{
    unsigned char buffer[8192];
    size_t n;

    while ((n = fread(buffer, 1, sizeof buffer, in)) > 0)
    {
        size_t total = 0;

        while (total < n)
        {
            size_t written = fwrite(buffer + total, 1, n - total, out);

            if (written == 0)
            {
                return 0;
            }

            total += written;
        }
    }

    return !ferror(in) && !ferror(out);
}

int main(int argc, char **argv)
{
    if (argc != 3)
    {
        fprintf(stderr, "用法:%s <源文件> <目标文件>\n", argv[0]);
        return EXIT_FAILURE;
    }

    FILE *in = fopen(argv[1], "rb");

    if (in == NULL)
    {
        perror("打开源文件失败");
        return EXIT_FAILURE;
    }

    FILE *out = fopen(argv[2], "wb");

    if (out == NULL)
    {
        perror("打开目标文件失败");
        fclose(in);
        return EXIT_FAILURE;
    }

    int ok = copy_stream(in, out);

    if (fclose(in) == EOF)
    {
        perror("关闭源文件失败");
        ok = 0;
    }

    if (fclose(out) == EOF)
    {
        perror("关闭目标文件失败");
        ok = 0;
    }

    return ok ? EXIT_SUCCESS : EXIT_FAILURE;
}
这个骨架故意保留了一个工程问题供继续思考:目标文件在复制完成前已经以 wb 截断,若复制失败会留下半成品。下一步可把输出改为临时文件,并在全部检查通过后替换正式目标。
总结
C 语言文件操作可以归纳成一条清晰的主线:
确定格式
  → 选择打开模式
  → fopen 并检查
  → 根据数据边界选择读写函数
  → 用返回值驱动循环
  → 区分 EOF 与错误
  → 管理位置和缓冲
  → fclose 并检查
文件之所以重要,是因为它把数据从一次程序运行中解放出来,实现持久化保存。C 标准库用“流”统一抽象不同 I/O 设备,用 FILE * 维护缓冲、状态和当前位置。打开模式决定文件是否必须存在、是否被截断、写入是否追加;选错模式,后果可能在第一次读写前就已经发生。
顺序读写函数各自面向不同边界:fgetc 处理字符,fgets 处理文本片段与行,fscanf/fprintf 处理格式化字段,fread/fwrite 处理固定大小元素。真正控制循环的始终是本次操作的返回值,而不是事先调用 feof 猜测未来。
随机访问通过 fseek、ftell 和 rewind 管理文件位置,但文本流、超大文件和不可定位设备都有边界。缓冲区提升效率,也意味着错误可能延迟到 fflush 或 fclose 才出现。因此,写函数返回成功并不是最后一步,关闭结果同样值得检查。
最后还要记住:内存布局不是天然的文件协议。 若文件需要长期保存、跨平台交换或接收外部输入,就应明确编码、版本、长度、字节序与校验规则,并把所有长度、索引和返回值都当作需要验证的数据。
掌握这些原则后,文件操作就不再是一张零散的函数表,而是一套完整的资源管理与数据格式设计方法。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/weixin_64304261/article/details/167577697