
论文
Cross-Task Generalization via Natural Language Crowdsourcing Instructions
通过自然语言众包指令实现跨任务泛化
摘要
人类(例如,众包工作者)具有一种非凡的能力:只需阅读定义不同任务的文本指令并查看少量示例,就能解决这些任务。尽管传统监督学习在单个数据集上取得了成功,但这类模型往往难以实现跨任务泛化(例如,一个问答系统无法解决分类任务)。人工智能领域一个长期存在的挑战是构建一个模型,使其能够通过理解定义新任务的人类可读指令来学习新任务。为了研究这一问题,我们引入了 NATURAL INSTRUCTIONS,这是一个包含 61 个不同任务、其由人类撰写的指令以及 193k 个任务实例(输入-输出对)的数据集。这些指令来自用于创建现有 NLP 数据集的众包指令,并被映射到统一的模式。利用这一元数据集,我们通过在已见任务上训练模型并衡量其对剩余未见任务的泛化能力,来度量跨任务泛化。我们采用生成式预训练语言模型,将任务特定指令与输入一起编码,并生成任务输出。我们的结果表明,在评估对未见任务的泛化时,模型能够从指令中受益(使用指令的模型性能提升 19%)。然而,这些模型仍远低于估计的性能上界,这表明在此方向上仍有巨大的进步空间。
1.引言
我们已经在通过微调预训练语言模型(LMs)来解决众多NLP数据集方面见证了巨大进展(Peters et al., 2018; Brown et al., 2020)。更近期研究表明,通过多任务训练和统一编码,在已观测任务集合内的泛化方面展现出巨大前景(Khashabi et al., 2020; Aghajanyan et al.,2021)。然而,跨任务泛化——即对未见任务的泛化——总体上仍未得到充分探索。例如,我们能否用语法检查或问答任务的实例来监督一个模型,却又期望它解决像问题类型分类这样的不同任务(图1)。显然,人类能够进行此类泛化;普通人能够遵循自然语言指令来解决各种问题,众包平台的成功便证明了这一点(Efrat 和 Levy (2020) 也提出了这一论点)。在本文中,我们研究模型在给定其众包指令的情况下能否泛化到未见任务(图1)。我们构建了 NATURAL INSTRUCTIONS,这是一个由各种任务的自然众包指令及其实例组成的数据集。在我们数据集中的已见任务 T seen T_{\text{seen}} Tseen 上进行训练,我们构建了一个模型,该模型学习遵循定义任务的自然指令并执行任务(即将输入映射到输出)。在未见任务 T unseen T_{\text{unseen}} Tunseen 上进行测试,我们评估模型能否仅从其指令,且没有任何任务特定的标注数据(表2a;右)。与实例级泛化(表2a;左)相比,我们的模型将指令作为额外输入,并在训练阶段未观察到的任务上进行评估。我们从研究人员为众包现有 NLP 数据集而撰写的任务指令中汇编出 NATURAL INSTRUCTIONS。此类众包指令通常会详细说明任务应(以及不应)如何完成的多种细节。为了系统研究众包指令的各种要素,我们将其映射到统一模式,以涵盖任务描述中最重要的要素——如定义、约束、正例和负例。我们将 NATURAL INSTRUCTIONS 中的任务收集为提供给众包工作者的最小独立步骤,以完成下游 NLP 任务。例如,从 QASC(Khot et al., 2020)收集的任务包括生成主题词或组合事实的子任务,以及回答多跳问题。因此,我们的数据集不仅包含 NLP 中典型的下游任务,还包含在常见基准中未被充分表示的中间子任务。统一模式和最小子任务的收集使得能够训练出可通过从指令中学习而跨不同任务泛化的 LMs。总体而言,我们的数据集包含 61 个不同的 NLP 任务和 193k 个实例。我们的实验结果表明,LMs 会利用自然语言指令,因为它们对新任务表现出更好的泛化。例如,与不使用指令的模型相比,BART(Lewis et al., 2019)在跨任务泛化方面取得了 19 % 19\% 19% 的提升(§6)。重要的是,如果 LMs 在训练中观察到更多任务,它们就能更好地泛化到未见任务(图2b)。这种上升轨迹表明,当扩大任务指令元数据集中所表示任务的多样性时,有可能获得更强的跨任务泛化模型。尽管指令带来了益处,我们仍观察到模型的泛化与其估计上界(6.4)之间存在相当大的差距,这鼓励社区致力于解决这一具有挑战性的问题。贡献:总之,本工作的贡献如下:(a)我们引入了 NATURAL INSTRUCTIONS,这是一个人类撰写的指令数据集,这些指令从现有知名数据集中整理并映射到统一模式,为从指令中学习提供了训练和评估数据;(b)我们构建了能够编码指令的模型,并表明:(b.1)通过利用指令进行跨任务泛化的优势;(b.2)指令的不同要素在性能中的重要性;(b.3)我们的基准上仍有值得注意的改进空间,希望这能推动该方向的进一步研究。
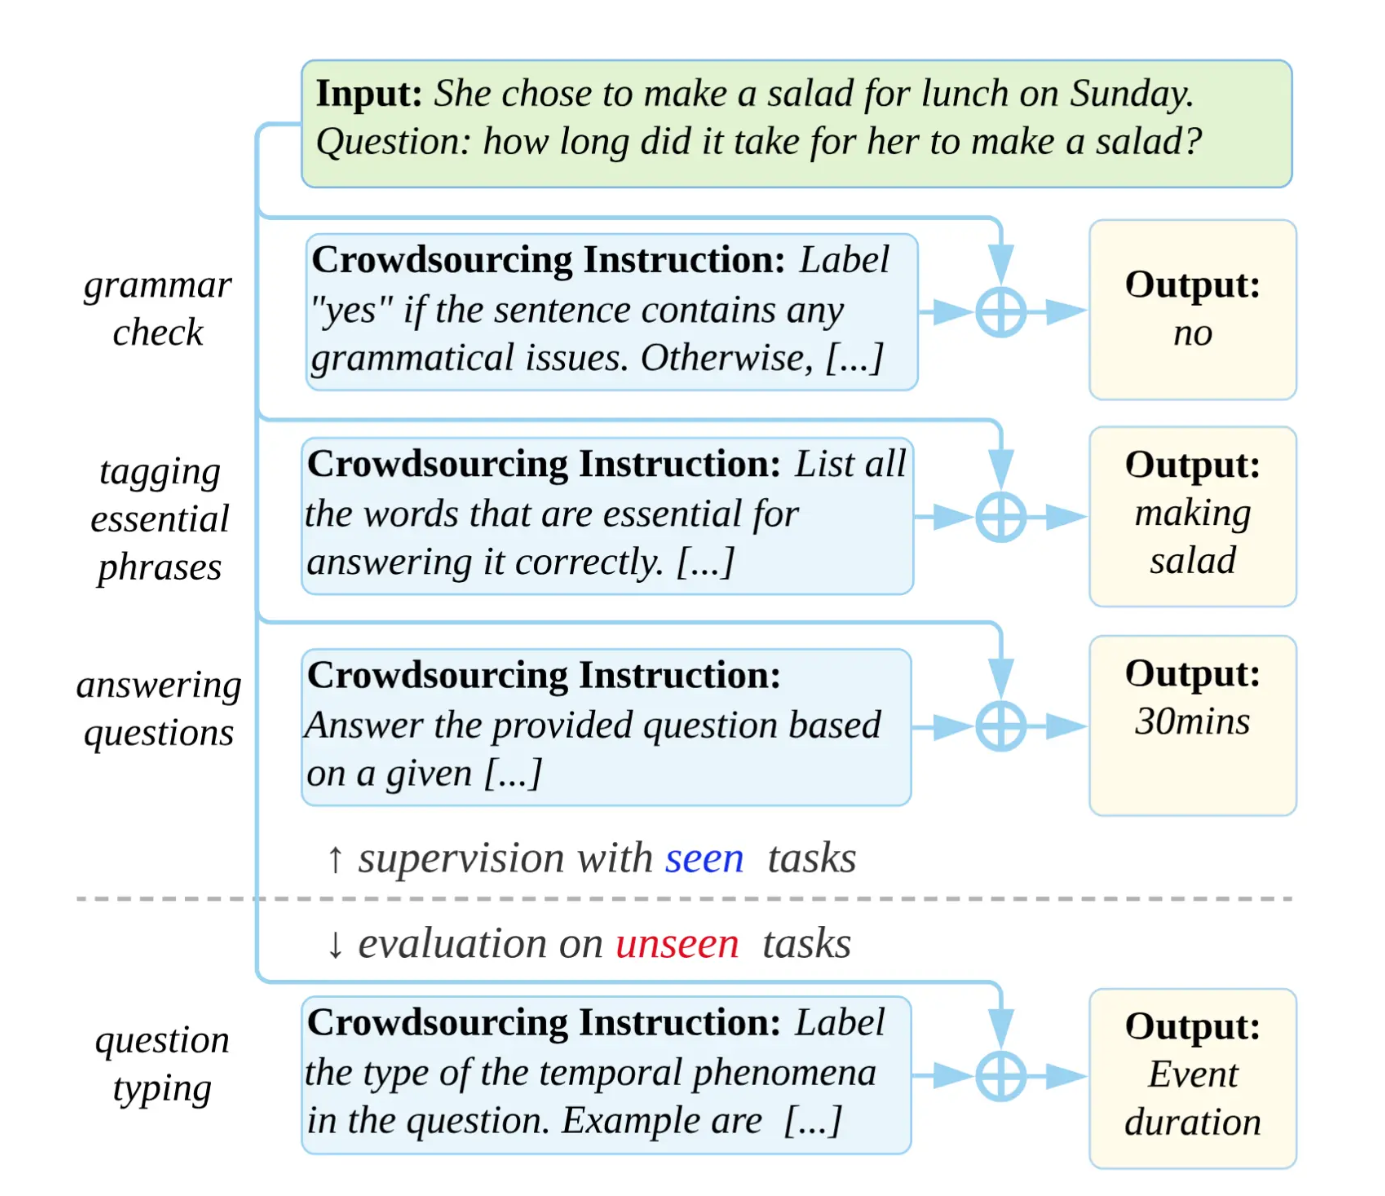
图 1:我们基于众包指令和不同 NLP 数据集的实例构建了 NATURAL INSTRUCTIONS 数据集。我们研究模型能否在给定其自然众包指令的情况下,从已见任务中学习并泛化到未见任务。
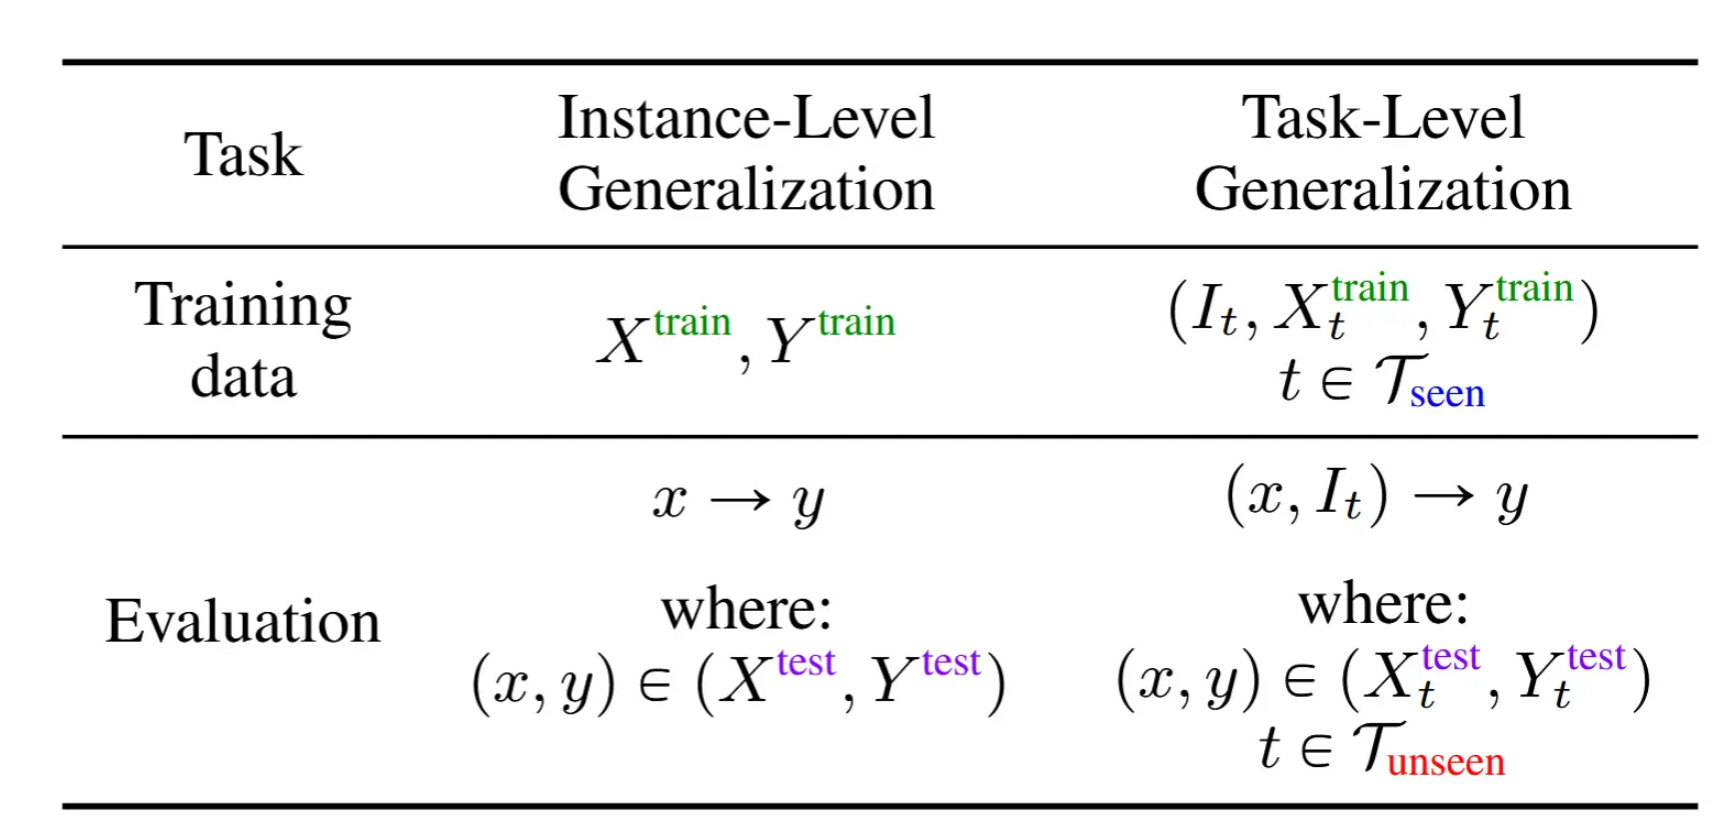
(a) 任务级与实例级泛化的比较。
I
t
I_t
It、
X
t
X_t
Xt 和
Y
t
Y_t
Yt 分别表示任务
t
t
t 的自然语言指令、输入和输出集合。在常规设置中,训练和评估在同一任务的实例上进行。然而,在任务级泛化中,模型被期望泛化到未见任务,其中
T
unseen
∩
T
seen
=
∅
T_{\text{unseen}} \cap T_{\text{seen}} = \emptyset
Tunseen∩Tseen=∅
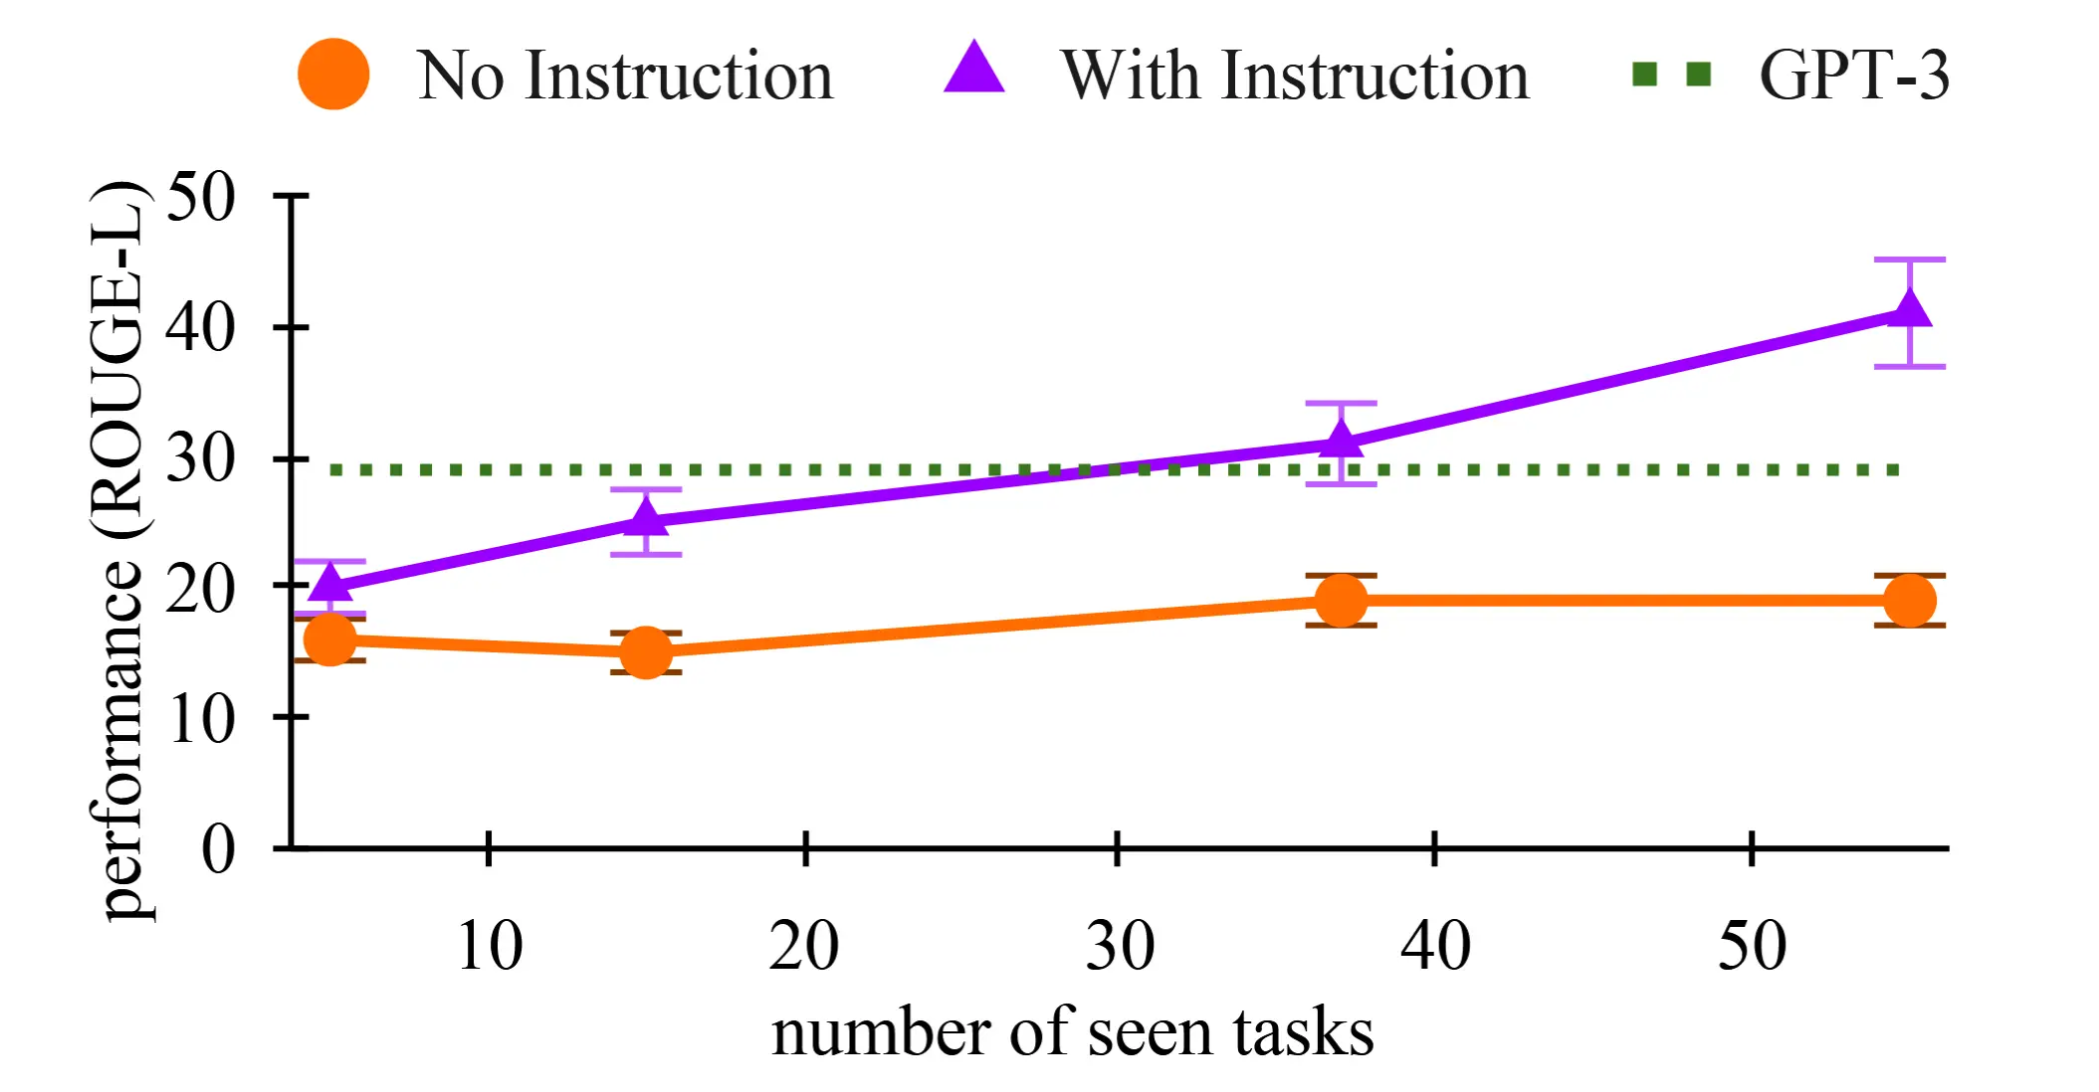
(b)当用已见任务进行监督时,在未见任务上的 BART 评估(y 轴为在 T unseen T_{\text{unseen}} Tunseen 上的性能,x 轴为 ∣ T seen ∣ |T_{\text{seen}}| ∣Tseen∣)。使用指令( I t I_t It)的模型会随着观察到的任务增多而持续提升。相反,无法访问指令的模型没有表现出泛化能力提升的迹象。详情见 §6.3。
图 2:对未见任务泛化的形式化定义(a)及其实证结果总结(b)。
2.相关工作
从指令中学习。近期文献研究了模型在多大程度上遵循语言指令(Hase 和 Bansal,2021;Ye 和 Ren,2021;Gupta 等,2021;Zhong 等,2021)。例如,Efrat 和 Levy(2020)考察语言模型是否能在无需进一步训练的情况下遵循众包指令。相反,我们的工作追求一个根本不同的目标:创建一个众包指令与任务实例的数据集,并通过在已见任务上训练模型以及度量模型对其余未见任务的泛化能力,来形式化跨任务泛化。Weller 等(2020)构建了一个众包数据集,其中包含简短的、类似问题的任务描述。与这项工作相比,我们的指令更长、更复杂且更自然,因为它们被用于通过众包收集数据集。PromptSource 和 FLAN(Wei 等,2022;Sanh 等,2022)是两项追求与我们相似目标的同期工作。我们的工作与这些工作之间的一个关键区别在于数据收集策略。我们的工作使用由 NLP 研究者在众包工作者创建数据集实例之前创建的自然指令,因此它包含每个任务的完整定义(定义、应避免的事项、负例等)。另一方面,同期工作中的指令是基于已有任务实例回溯性收集的。我们的自然指令使得能够评估模型在给定任务描述的不同要素时如何学习任务。(进一步比较见 §A.5。)尽管如此,我们认为,所有这些构建指令和任务类别的方法都是互补的,社区将从同时考虑它们以解决跨任务泛化这一挑战性问题中受益。
提示工程。为语言模型构建有效的离散提示以执行 NLP 任务是一个活跃的研究领域(Schick 和 Schütze,2021;Reynolds 和 McDonell,2021;Liu 等,2021)。此类提示通常极短,并且可能不包含复杂任务的完整定义。相比之下,我们的指令编码了收集数据集时所使用的详细指令。此外,目标不同:大多数提示工程方法寻求在特定任务上具有更高性能的提示,通常是通过对其目标任务作出假设,而这些假设使这些提示难以泛化到任何其他任务。然而,我们提出的元数据集能够度量对未见任务的泛化能力。
超越标准多任务学习。多任务学习是 AI 的一个长期目标(Caruana,1997),并已催生出能够支持更广泛任务的成功模型(McCann 等,2018;Raffel 等,2020;Khashabi 等,2020;Mishra 等,2020;Aghajanyan 等,2021;Ye 等,2021)。多任务文献中的大多数常规设置都在属于已见任务的实例上进行评估,即其带标签实例在训练期间已被观察到(表 2a 的第 1 列)。我们通过引入自然语言指令来扩展这一设置,这些指令使我们的模型能够桥接到训练期间未见的任务。
3 定义跨任务泛化
在此,我们正式定义跨任务泛化的问题设置。每个任务 t t t 由输入/输出实例 ( X t , Y t ) (X_t, Y_t) (Xt,Yt) 组成,并以其自然语言指令 I t I_t It 来描述。
任务特定模型。标准监督学习算法使用任务特定的带标签实例来学习从输入 x x x 到输出 y y y 的映射:对于 ( x , y ) ∈ ( X t train , Y t train ) (x, y) \in (X_t^{\text{train}}, Y_t^{\text{train}}) (x,y)∈(Xttrain,Yttrain),有 M ( x ) = y M(x)=y M(x)=y,并在同一(或相似)任务的测试实例 ( X t test , Y t test ) (X_t^{\text{test}}, Y_t^{\text{test}}) (Xttest,Yttest) 上进行评估。我们将此称为实例级泛化(表2a;左)。
跨任务模型。在此设置中,目标是学习一个模型 M M M,其在推理时给定输入 x x x 和任务指令 I t I_t It 获得输出 y y y:对于 ( x , y ) ∈ ( X t , Y t ) (x, y) \in (X_t, Y_t) (x,y)∈(Xt,Yt),有 M ( I t , x ) = y M(I_t, x)=y M(It,x)=y。与任务特定模型相比,学习映射 M M M 时不使用任何任务特定的训练数据。我们收集 NATURAL INSTRUCTIONS(§4)来研究这个问题:一个模型能否通过训练任务 T seen T_{\text{seen}} Tseen 被训练以遵循指令,并泛化到为任务 t ′ ∈ T unseen t' \in T_{\text{unseen}} t′∈Tunseen 遵循指令。我们将此称为任务级泛化(表2a;右)。
4 NATURAL INSTRUCTIONS
NATURAL INSTRUCTIONS 由描述任务(例如,问答)的指令以及该任务的实例(例如,为给定问题抽取的答案)组成。图3展示了一个任务示例指令,该任务为“生成需要理解事件持续时间的问题”,并附有为该任务提供上下文的正例和负例。这里,我们引入一种用于表示指令的模式(§4.1),然后描述现有数据集(及其众包模板)如何映射到我们的模式中(§4.2)。
4.1 指令模式
在众包各种数据集时所使用的指令由不同作者为不同目的撰写,并在多种方面存在差异(其差异见附录A.2)。我们引入一个统一模式(图4)来一致地表示这些多样的指令形式。我们的指令模式是我们试点研究的结果在一部分数据集上开展的研究。下面我们描述该模式的组成要素: • TITLE 提供任务及其相关技能的高层描述(如问题生成、答案生成)。 • PROMPT 是单句指令,通常出现在输入实例之前,并将其与指令连接起来。 • DEFINITION 提供任务的核心详细指令。 • THINGS TO AVOID 包含关于必须避免的不良标注的指令。这些有助于界定任务的范围以及可接受响应的空间。 • EMPHASIS AND CAUTION 是众包模板中突出显示的简短但重要的陈述,旨在强调或警示。 • POSITIVE EXAMPLES 包含与提供给工作者/系统的输入及其预期输出相似的输入/输出,帮助众包工作者更好地理解任务(Ali, 1981)。 • NEGATIVE EXAMPLES 包含输入/输出以提供不得生成的示例来强调应避免的事项。• 原因:提供某个示例为何是正例或负例背后的解释。• 建议:包含关于如何修改负例以将其转变为正例的建议。下一节描述将原始指令(为众包工作者设计)映射到我们的指令模式的过程。
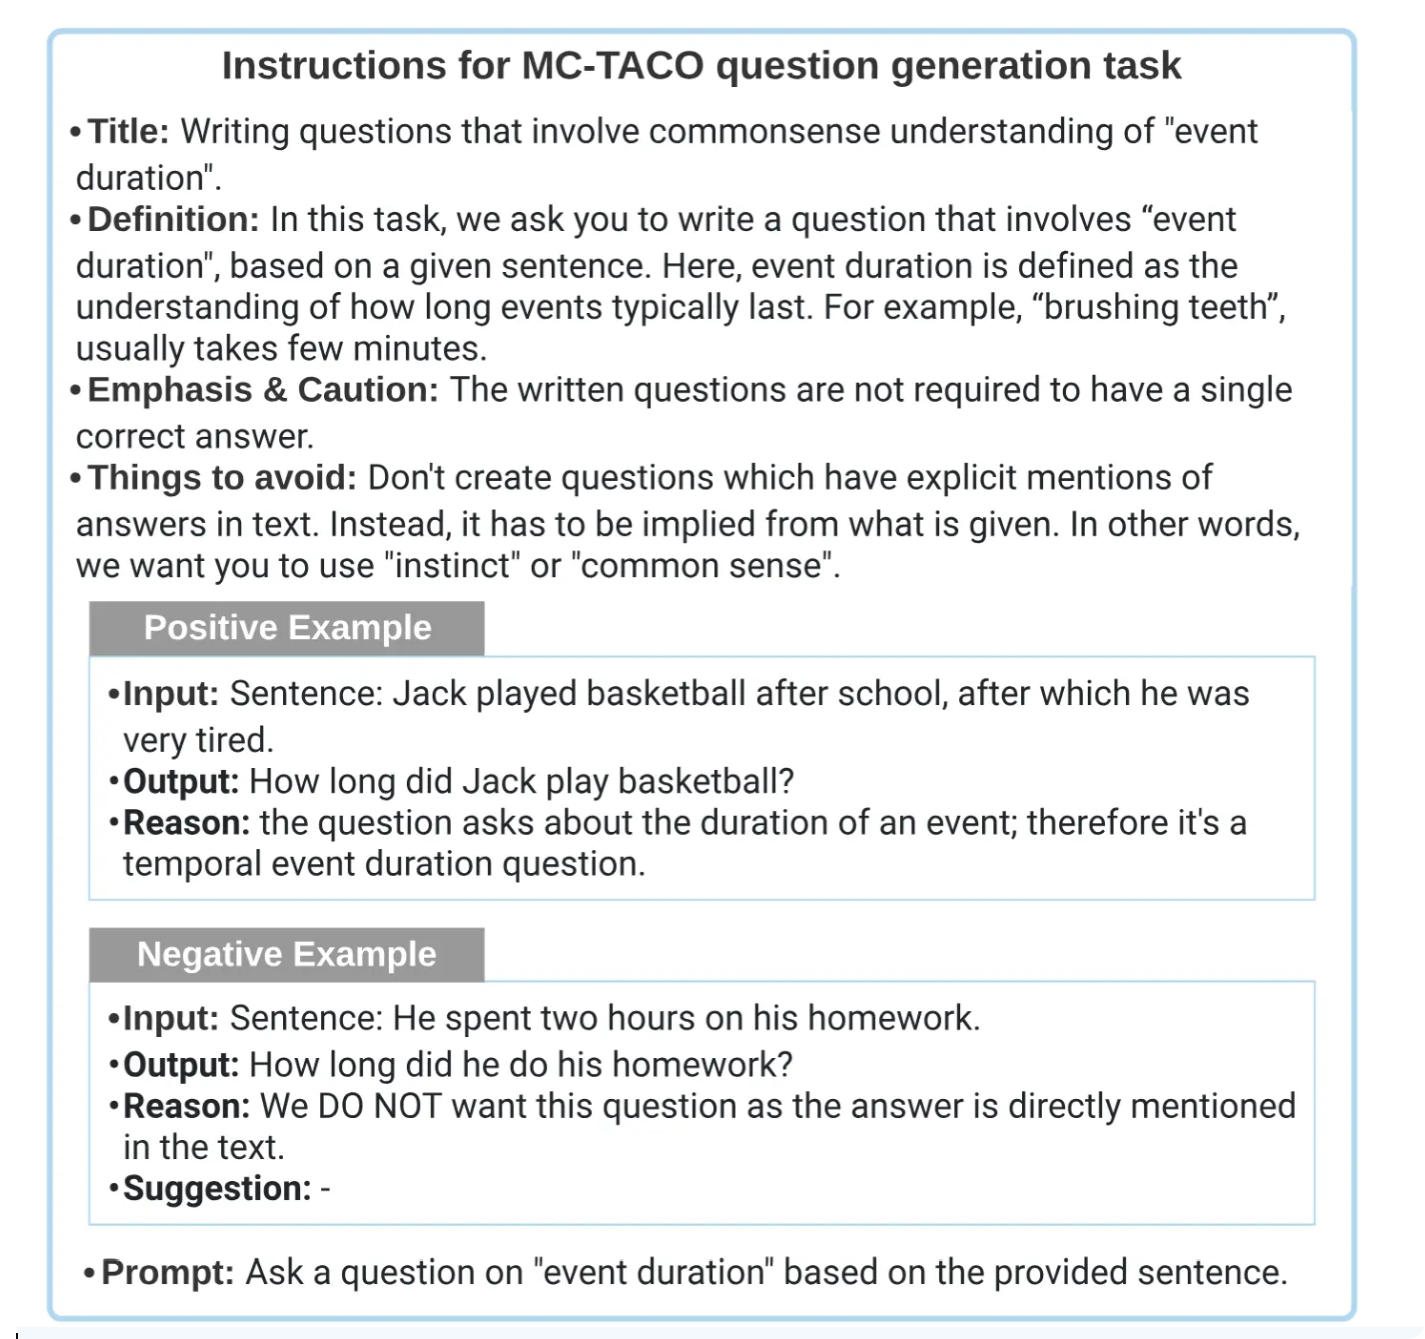
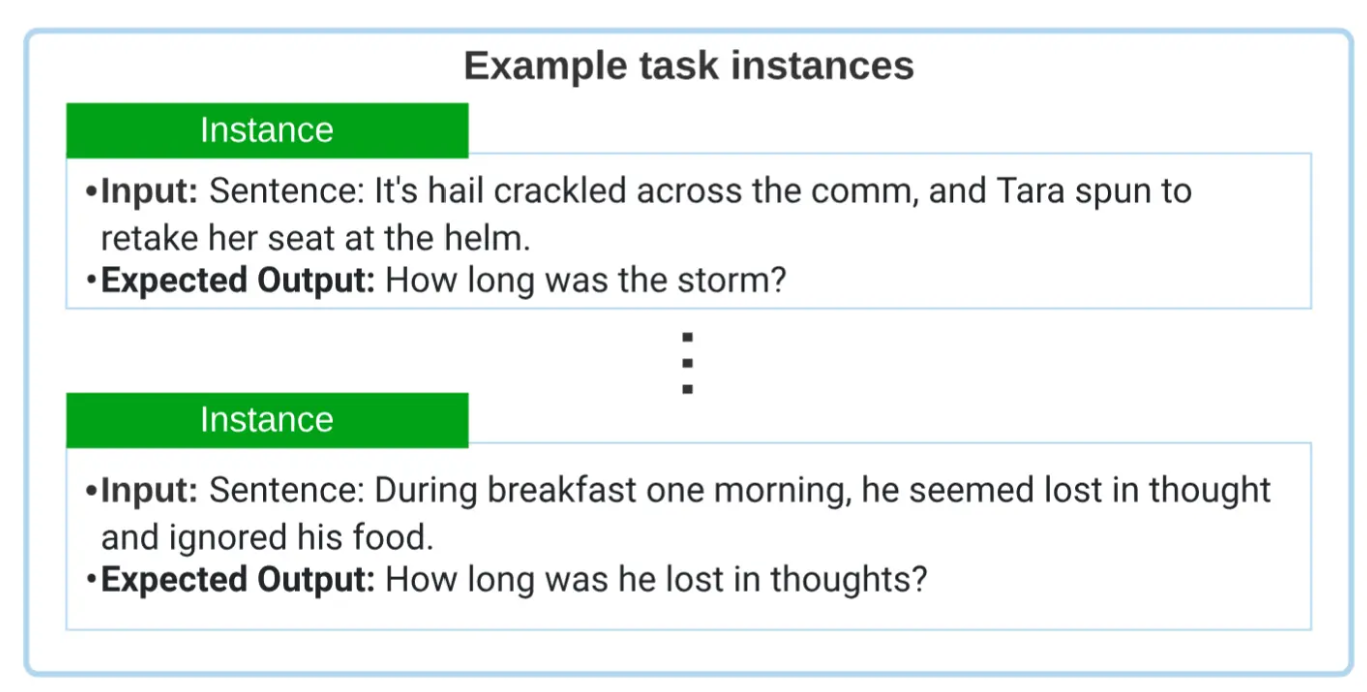
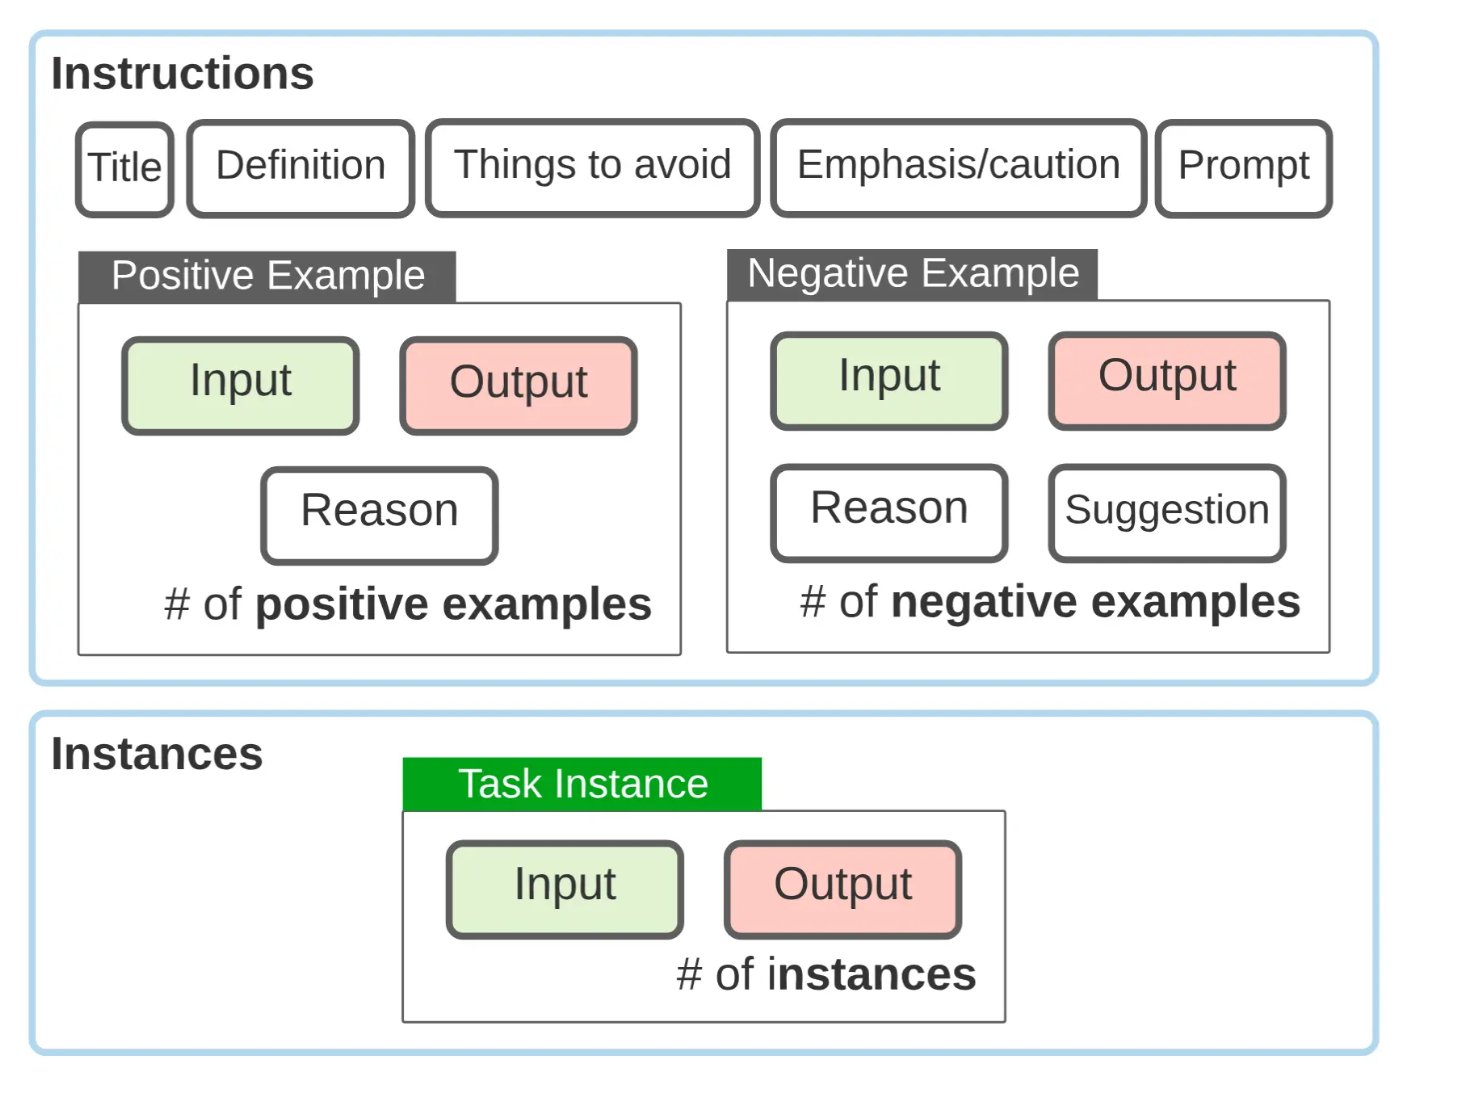
图4:用于在 NATURAL INSTRUCTIONS(§4.1)中表示指令的模式,以平板表示法展示。
4.2 构建 NATURAL INSTRUCTIONS
4.2.1 收集数据
收集原始指令与实例。我们使用现有的、被广泛采用的 NLP 基准,这些基准通过众包平台收集,因此附带众包模板。在第一步中,我们确定了若干数据集,并与这些数据集的作者接洽以获取其众包模板和原始数据。这产生了以下数据集:CosmosQA (Huang et al., 2019)、DROP (Dua et al., 2019)、EssentialTerms (Khashabi et al., 2017)、MCTACO (Zhou et al., 2019)、MultiRC (Khashabi et al., 2018)、QASC (Khot et al., 2020)、Quoref (Dasigi et al., 2019)、ROPES (Lin et al., 2019) 以及 Winogrande (Sakaguchi et al., 2020).2
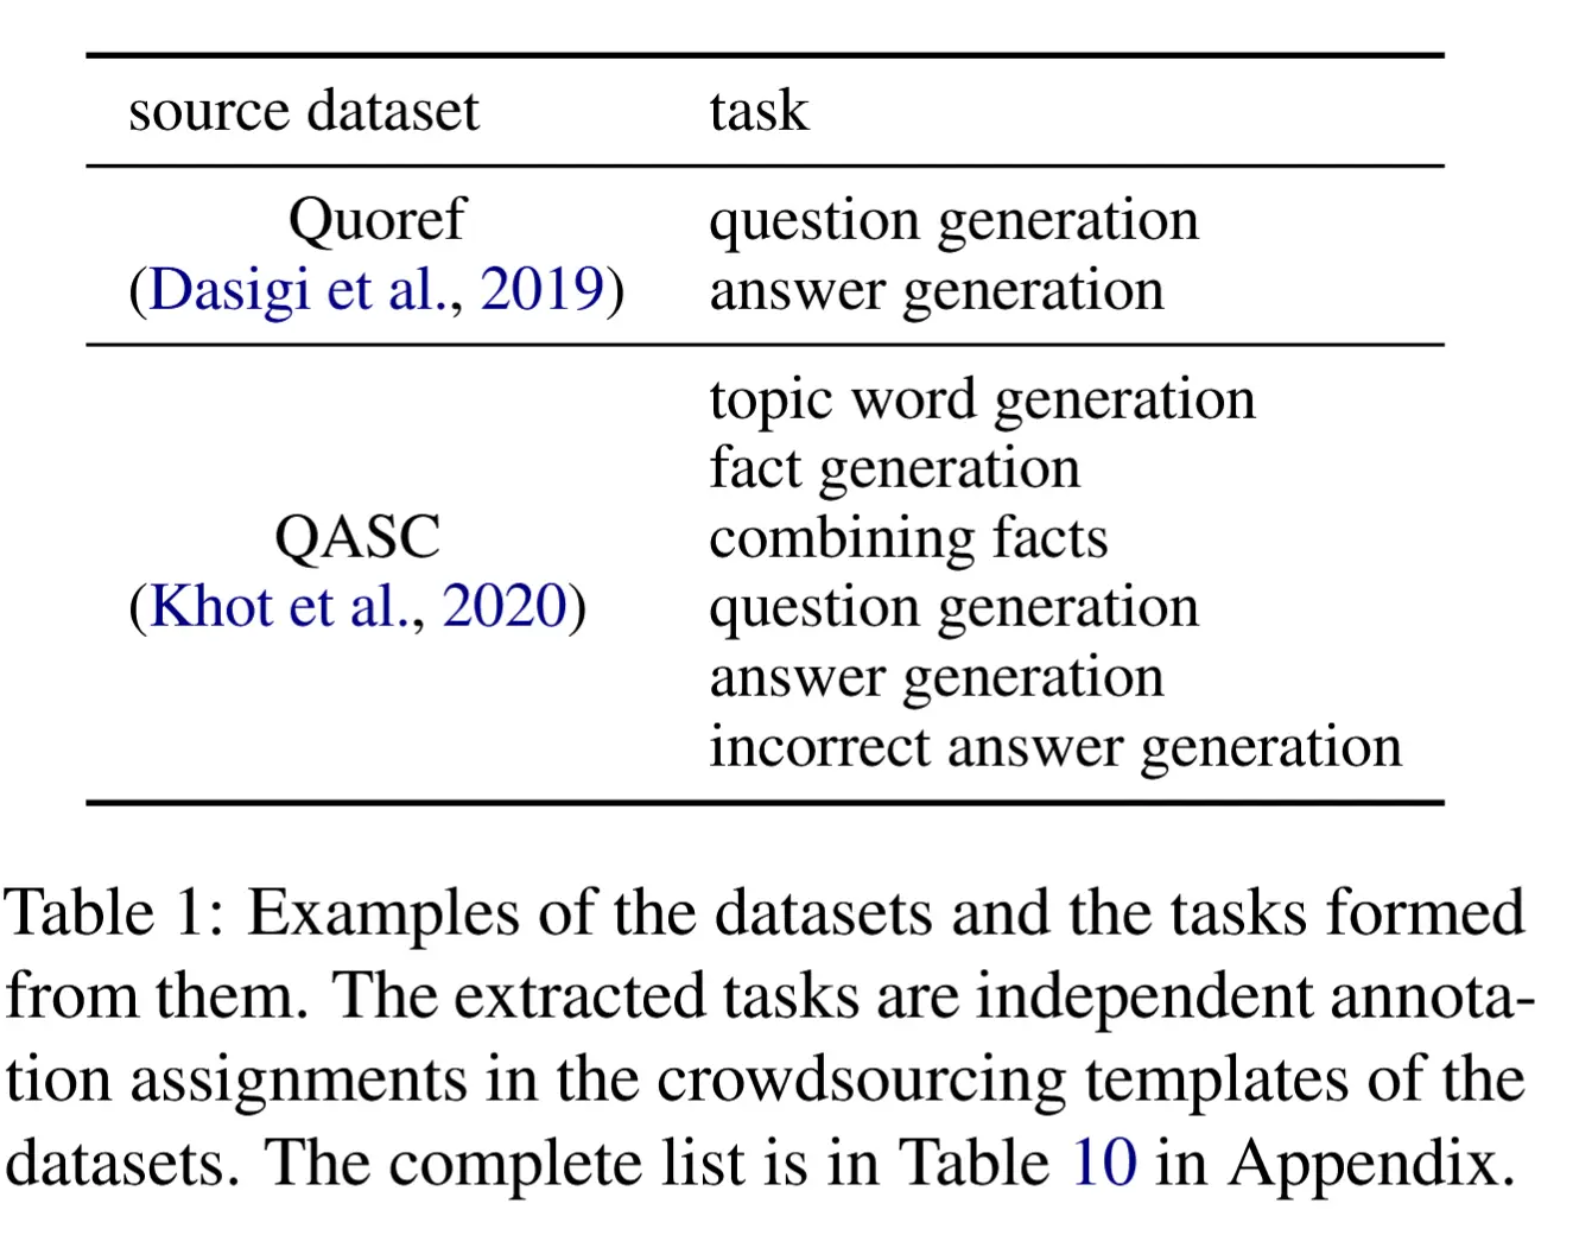
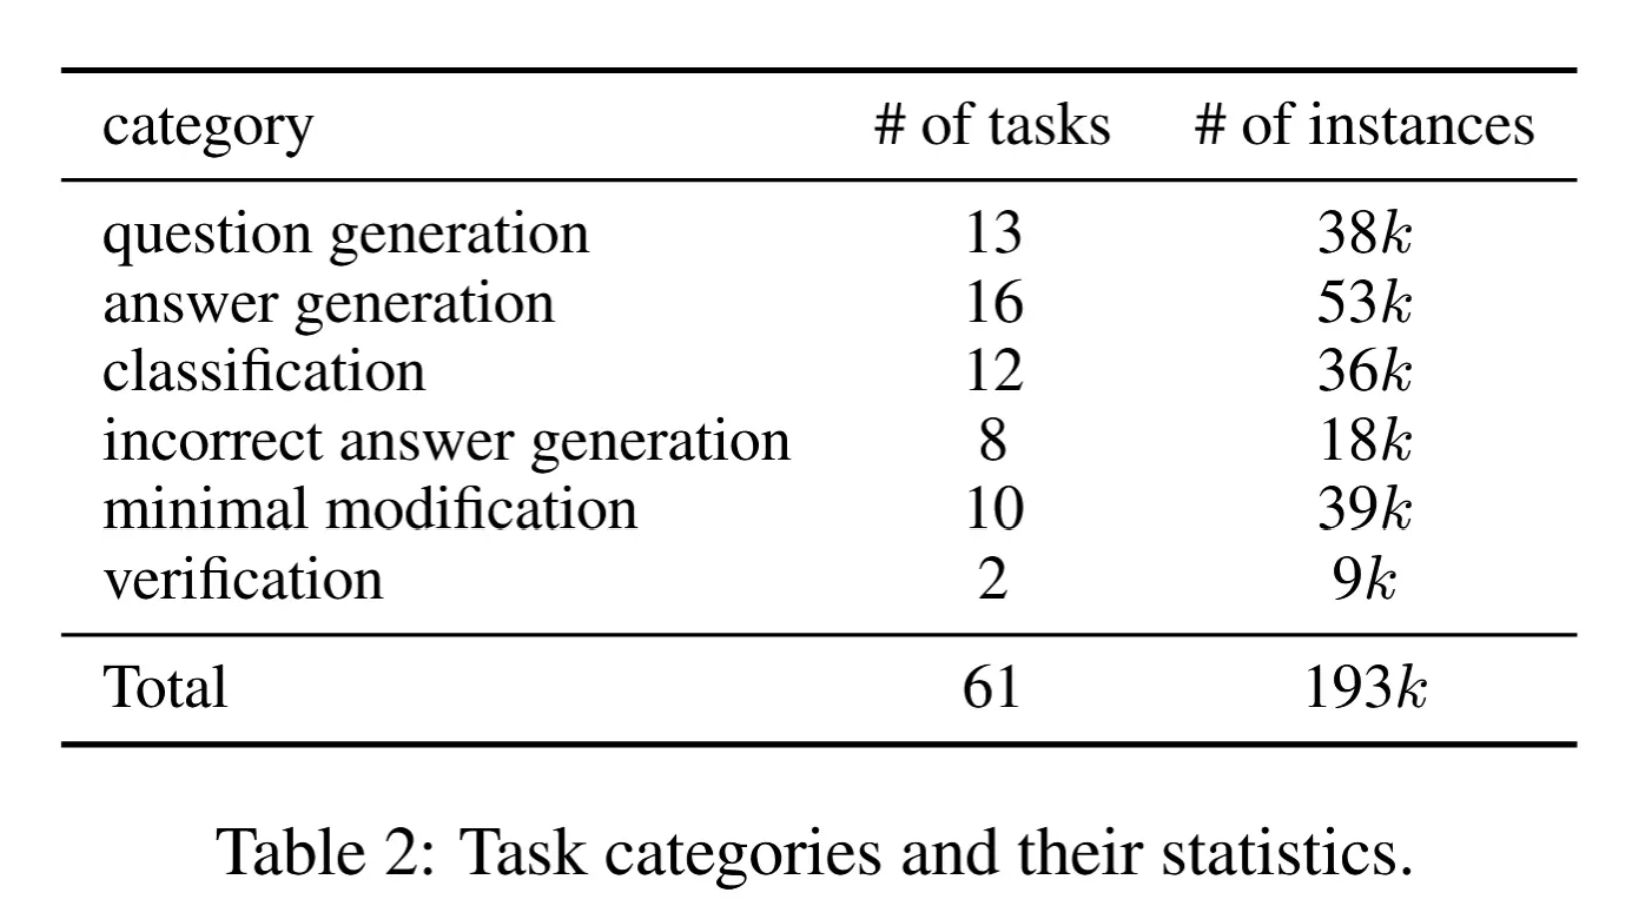
将众包指令拆分为最小任务。几乎所有众包工作说明都包含一系列步骤,以指导众包工作者创建任务实例。例如,QASC 和 MCTACO 在数据创建过程中分别包含 7 个和 19 个步骤。我们划分将众包指令分解为其底层步骤,并生成多个最小且独立的子任务。3 表1显示了为 Quoref 和 QASC 提取的子任务。例如,Quoref 中的主任务是给定一个上下文段落回答一个问题,但其众包模板由问题生成和答案生成两个子任务组成,并具有各自独立的指令。这一过程产生了更一致的任务定义,使得能够成功地将指令映射到我们的模式中,这与 Efrat 和 Levy (2020) 按原样使用众包指令的工作形成对比。总共有61个任务,分为6个语义类别(表2)。我们将这些宽泛类别分配给任务,以理解它们在实验中的整体行为。值得注意的是,尽管同一类别中包含的任务表面上相似,任意两个任务都是不同的。例如,虽然问题生成是 Quoref、CosmosQA 和 QASC 的一部分,但每个都有其各自独立的问题生成任务变体(见附录图10)。
4.2.2 将原始指令映射到模式
我们手动用众包指令的内容填充指令模式的各个字段。3我们剔除涉及模型在环(model-in-the-loop)的任务。例如,原始指令中为强调而高亮的部分,被纳入我们的强调/警示字段。此步骤建议的修改由一位作者实施,并由另一位作者验证。4
提升描述质量与一致性。我们编辑原始指令以确保其质量。特别地,我们修复写作问题(拼写错误、歧义等)并删除重复内容。尽管重复通常有助于增强人类理解,但由于计算机注意力跨度有限,简短明了的指令往往对计算机更有效(Beltagy et al., 2020)。
扩充示例与理由。原始指令中提供的示例数量存在很大差异。指令通常包含更多正例,或者有些指令不包含任何负例(例如,QASC)。只要可能,我们就添加负例,使每个任务至少有两个负例。此外,并非所有原始指令都为其每个示例包含 REASONS 或 SUGGESTIONS。例如,正例通常不附带解释,且大多数数据集不包含建议。在指令中缺少此类信息的地方,我们会添加它们。
为子任务收集输入/输出实例。我们的多数任务是众包过程中的中间步骤。因此,为了为每个任务提取输入/输出实例,我们需要解析每一步众包工作者的原始标注。由于每个数据集存储其标注的格式略有不同,提取并统一此类中间标注可能并非易事。
验证。一位标注者与数据集作者协商,验证了所得数据的质量。该标注者根据作者反馈进行迭代(平均 3 轮),直到他们满意。
质量评估。我们要求独立的人类标注者回答 240 个随机实例(来自 12 个随机任务的 20 个实例,稍后用于我们的评估 §5.1)。随后对人类生成回答的评估得出超过 96% 的准确率,这表明人类可以轻松理解并执行我们的指令。
4.2.3 NATURAL INSTRUCTIONS 统计
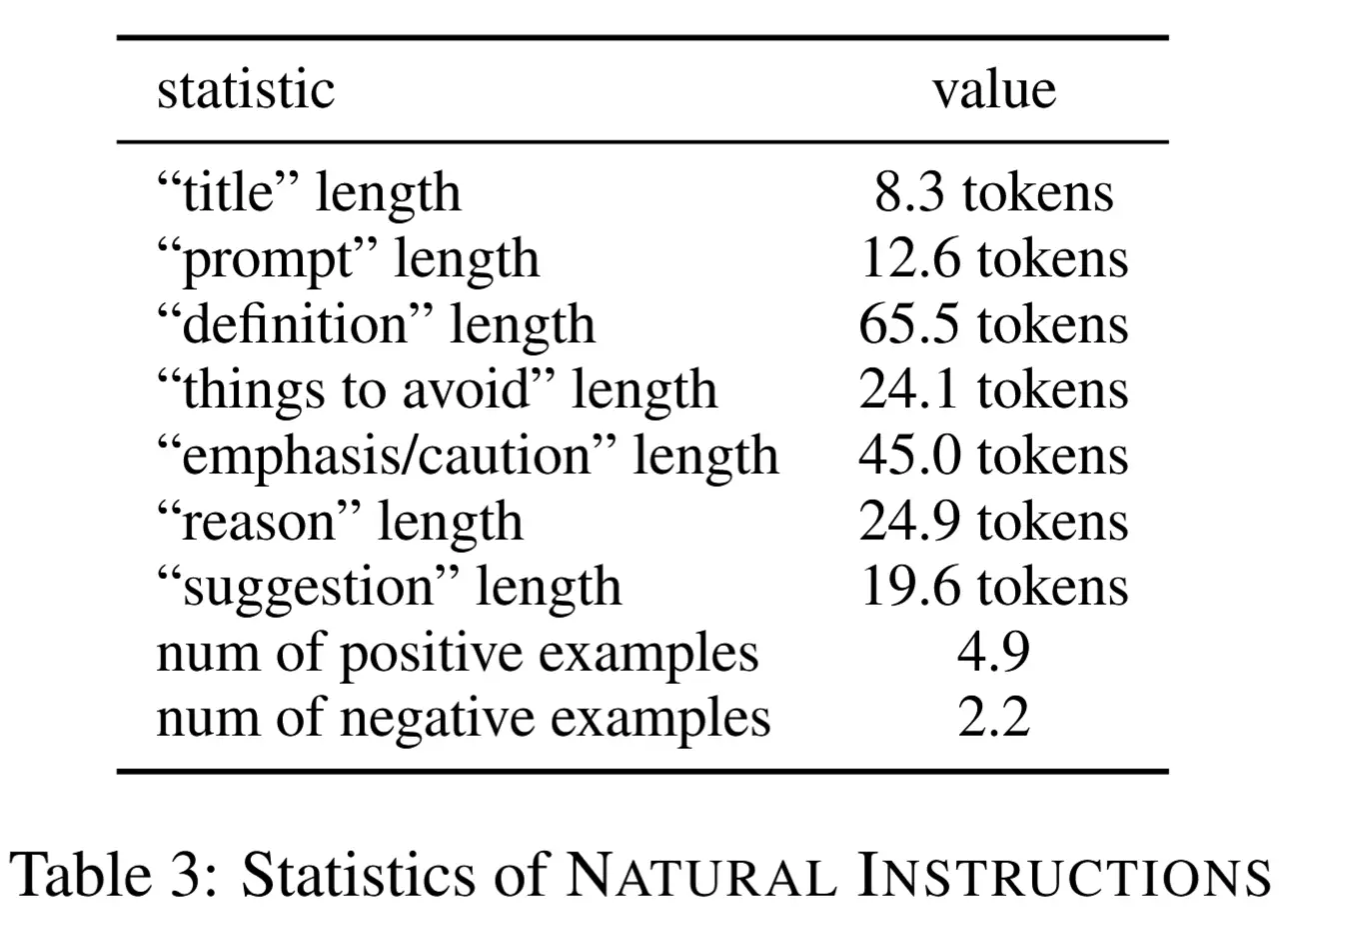
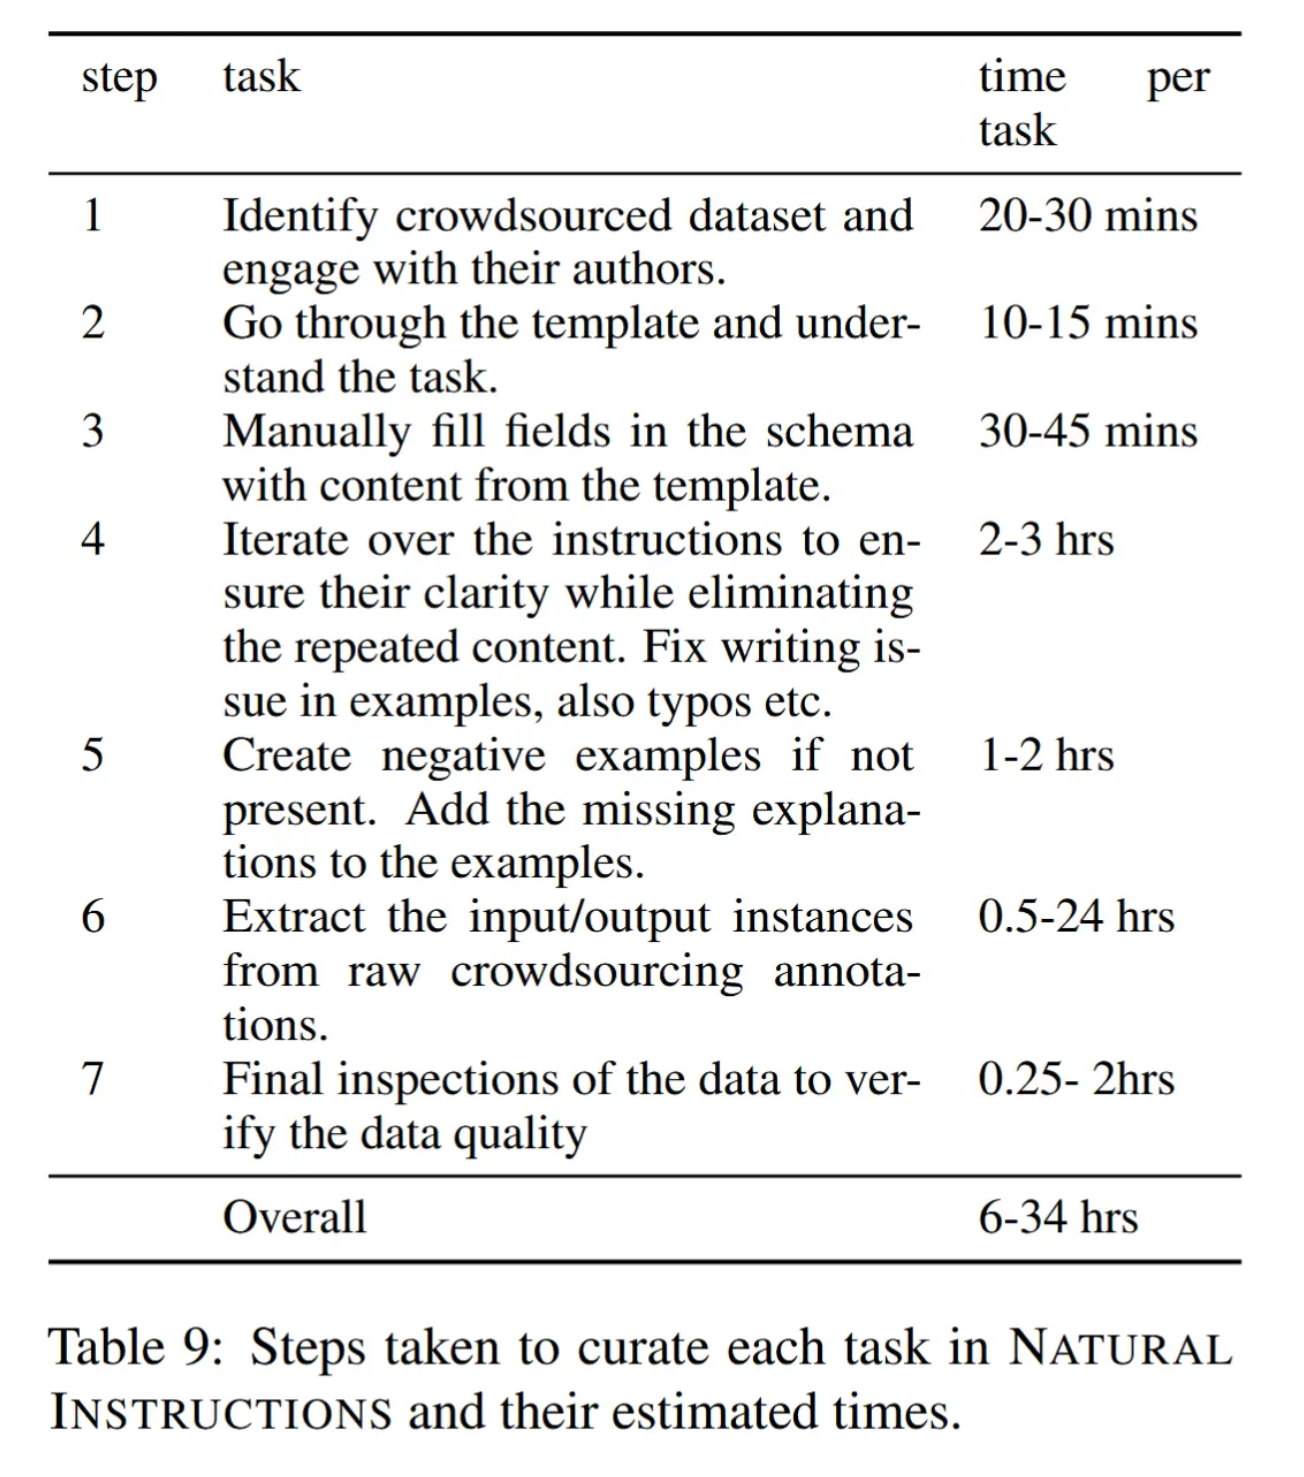
综上所述,NATURAL INSTRUCTIONS 由若干子任务组成,每个子任务包含一组指令以及输入/输出实例(图 3 和图 4)。⁴ 平均而言,每个任务的数据整理过程大约需要 5 至 34 小时(详见附录;表 9)。完整的指令列表包含在附录中。该数据集总共包含 61 个任务和 19.3 万个实例。表 2 展示了每个任务类别的数据统计。⁵ 平均而言,指令包含 4.9 个正例和 2.2 个负例。指令中最长的元素通常是 DEFINITIONS,包含 65.5 个词元,最短的是 TITLE,包含 8.3 个词元(更多统计信息见表 3)。
5 问题设定与模型
这里我们定义不同的跨任务泛化设定(§5.1)以及模型(§5.2)。
5.1 任务划分与泛化类型
随机划分。该设置遵循使用随机数据划分对 NLP 模型进行基准测试的常见做法。在此,从 NATURAL INSTRUCTIONS 中每个任务类别(表 2)随机选择两个任务用于评估,其余任务用于训练。这使得 T unseen T_{\text{unseen}} Tunseen 中有 12 个任务, T seen T_{\text{seen}} Tseen 中有 49 个任务。^6
留一法泛化。为了更好地理解跨任务泛化的本质,我们研究更严格的训练任务与评估任务划分设置。
留一类别:评估模型在基于其他类别训练时对某一任务类别的泛化程度—— T seen T_{\text{seen}} Tseen 中不包含该类别中的任何任务。
留一数据集:评估模型在基于所有其他任务训练时,对特定数据集中所有任务的泛化能力—— T seen T_{\text{seen}} Tseen 中不包含该数据集中的任何任务。这种划分可防止属于同一源数据集的任务之间的任何泄漏。
留一任务:通过在其余所有任务上进行训练,评估模型学习单个任务的效果。
5 我们将每个任务中的实例数限制为 6.5k,以避免严重的实例不平衡。
6 那些无法进行相对可靠的自动评估的任务被排除在 T unseen T_{\text{unseen}} Tunseen 之外。
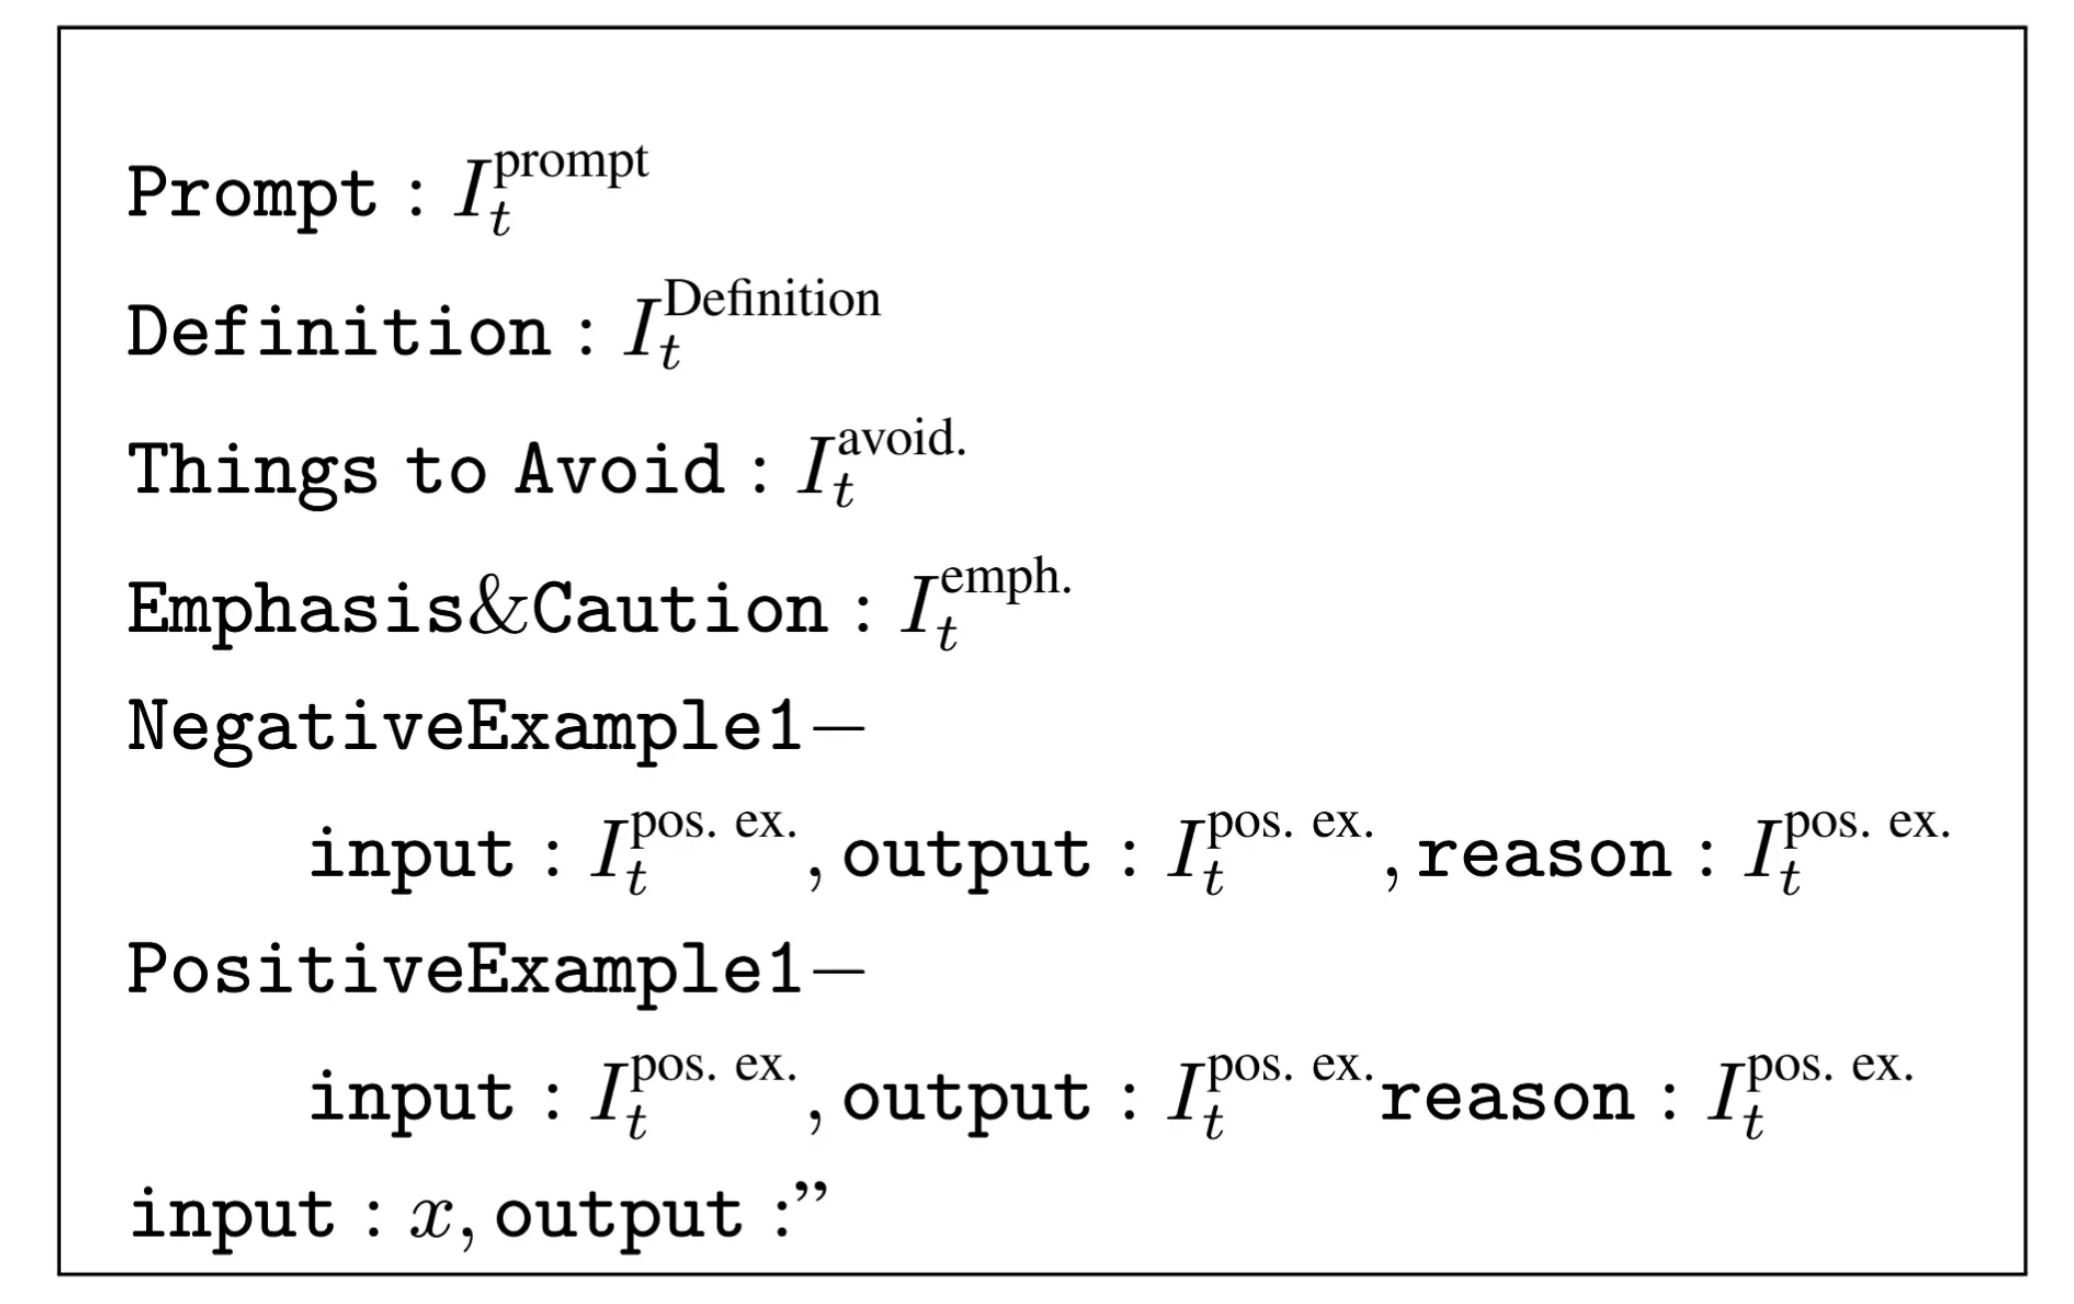
图5:编码指令
I
t
I_t
It,其中
I
t
c
I_{tc}
Itc 指指令模式中组件
c
c
c 的文本。
5.2 模型
我们使用预训练语言模型构建模型,其中 BART(Lewis et al., 2019)采用编码器-解码器架构并用于微调,GPT3(Brown et al., 2020)用于少样本实验。
编码指令与实例。对于每个问题设置,我们将给定的指令 I t I_t It 和输入实例 x x x 映射为文本格式,并解码输出 y y y,得到 e n c ( I t , x ) \mathrm{enc}(I_t, x) enc(It,x)。然后,该编码函数被输入编码器-解码器模型以预测 y y y: M : e n c ( I t , x ) → y M: \mathrm{enc}(I_t, x) \rightarrow y M:enc(It,x)→y。
编码实例遵循将输入实例映射为文本的标准 NLP 范式。如我们的指令模式(§4.1)所述,每个指令 I t I_t It 由多个元素组成。在这里,我们将指令的每个元素映射为文本格式,并将其附加在输入实例之前。图 5 展示了我们如何编码完整指令。
为了研究每个指令元素对跨任务泛化的影响,我们比较这些编码:(1)PROMPT,(2)POS. EXAMPLES,(3)PROMPT + DEFINITION,(4)PROMPT + THINGS TO AVOID,(5)PROMPT + EMPHASIS,(6)PROMPT + POS. EXAMPLES,(7)PROMPT + + DEFINITION + POS. EXAMPLES,以及(8)FULL INSTRUCTION。其中每一种(例如 PROMPT 和 POS. EXAMPLES)都对应于近期文献中的提示设置(Le Scao and Rush, 2021;Lu et al., 2021)。
BART。我们使用 BART (base)(Lewis et al., 2019),它允许我们微调其模型参数。这是一个具有 1.4 亿参数的编码器-解码器架构。对于每个设置,输入被编码使用不同的指令元素,在所有 T seen T_{\text{seen}} Tseen 任务上进行训练,并在 T unseen T_{\text{unseen}} Tunseen(§5.1)上进行评估。GPT3。作为对比,我们评估 GPT3(Brown et al., 2020),它是一个 175B 参数的自回归语言模型($\sim$1.2k 倍于 BART),并且在模仿其提示中提供的演示方面已展现出有前景的结果。我们无法微调这个庞大模型的参数,而是按照其默认设置,使用前面引入的编码,在 T unseen T_{\text{unseen}} Tunseen(§5.1)中的评估任务上原样使用它。
6 实验
评估指标。我们将所有任务视为文本生成问题,并使用文本生成的自动评估指标进行评估。特别地,我们使用 ROUGE-L(Lin, 2004)自动评估生成的输出。7 实现细节。对于 BART,我们的模型在给定的训练划分和输入编码下训练 3 个 epoch,学习率为 5 e − 5 5e-5 5e−5。对于 GPT3,我们使用 davinci-instruct 引擎,并通过贪婪解码生成输出,最多生成 16 个标记(默认值)。我们使用默认停止条件,即 2 个换行标记。8
6.1 不同任务划分下的泛化
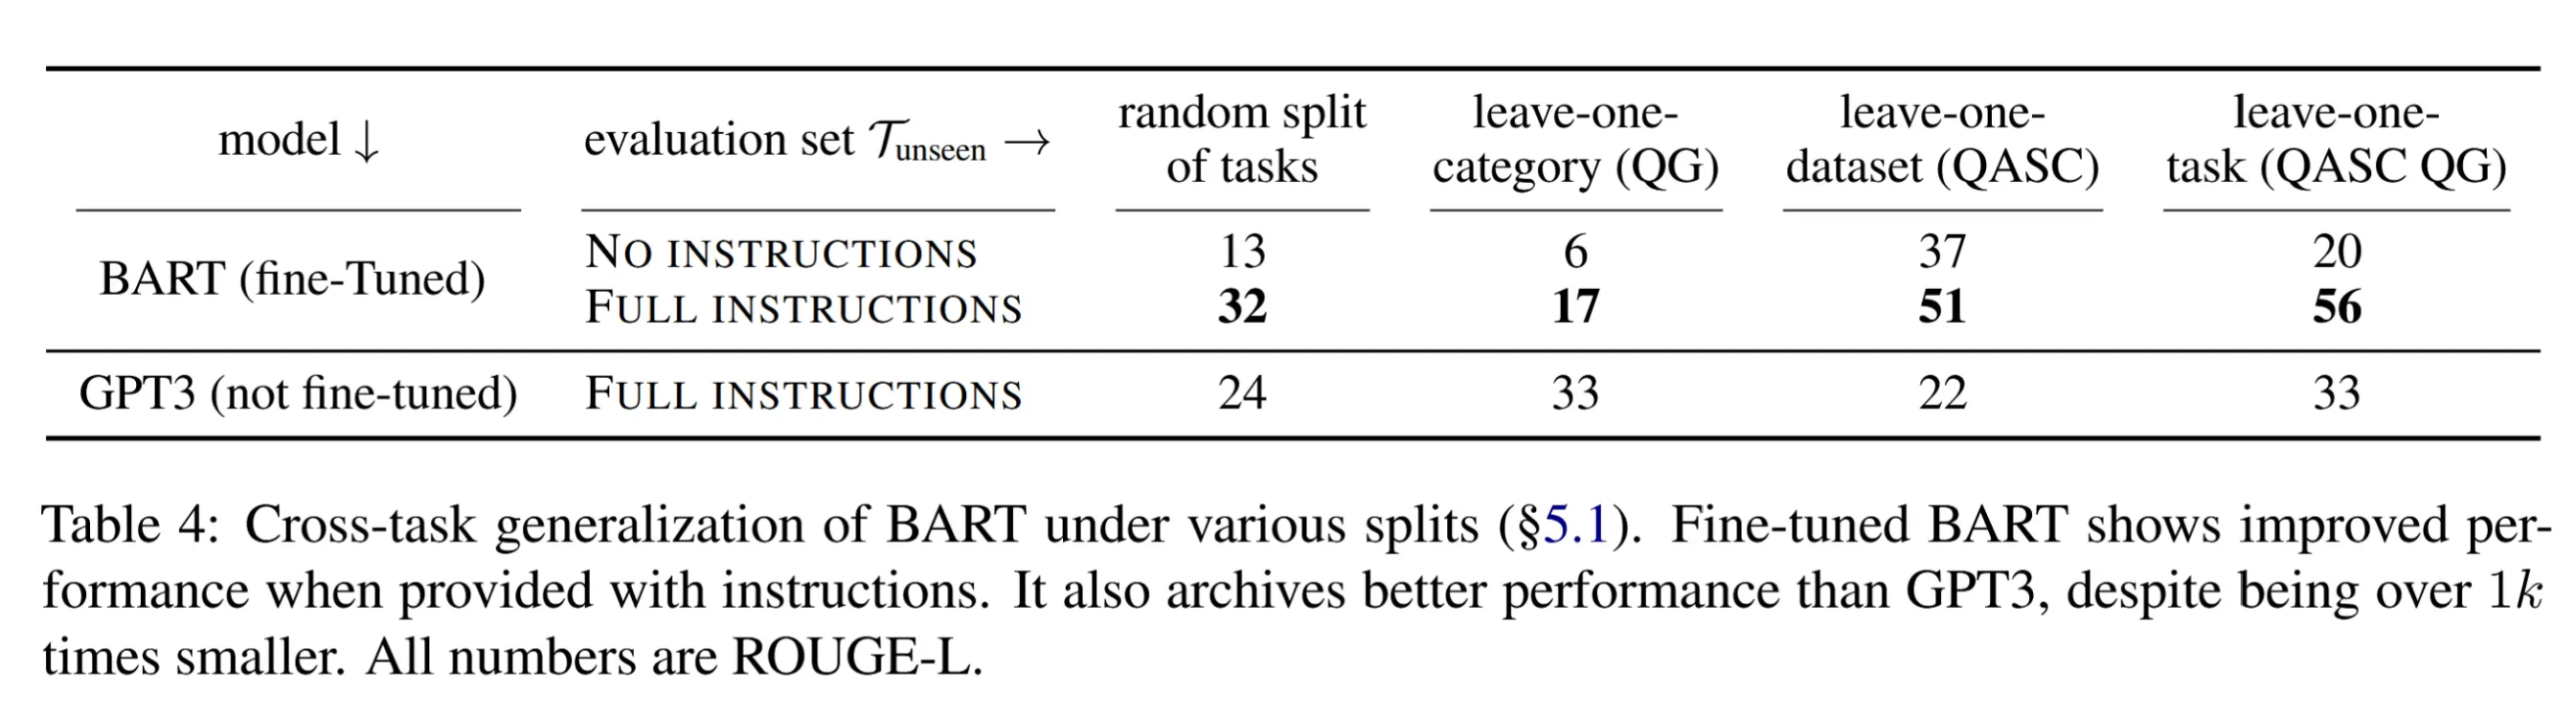
表 4 报告了 BART 模型在不同任务划分(§5.1)下训练和评估的结果。作为比较,我们评估 GPT3,它不使用微调,而 BART 则使用 T seen T_{\text{seen}} Tseen 任务进行微调。第一列对应任务的随机划分,而其余列报告了 BART 模型在留一- x x x 划分(§5.1)下的跨任务泛化结果。对于 x x x“类别”,问题生成类别中的任务在训练期间被留出。对于第 x x x 个数据集,从 QASC 数据集中提取的任务被排除在训练之外。对于第 x x x 个任务,我们在所有任务上训练模型,但用于评估的 QASC 问题生成任务除外。指令有助于跨任务泛化。结果表明,无论任务如何划分,BART 都能从指令中受益,从而泛化到新任务。例如,在随机划分下,使用完整指令的模型相比不使用指令的模型获得 + 19 % +19\% +19% 的提升。这对于留一类别划分尤其有趣,因为训练后的模型无需接触某一特定语义类别,就能泛化到该类别任务。与 GPT3 相比,利用指令的微调 BART 模型尽管比 GPT3 小约 1 k 1k 1k,却取得了更强的性能。例如,在任务随机划分下,使用完整指令的 BART 模型比 GPT3 的性能高 8 % 8\% 8%。注意,与例如随机划分设置相比,留一类别设置中的绝对数值较低,因为该设置难度更大。尽管所有设置都涉及在训练期间未见过的任务上进行评估,但留一类别设置使得训练任务与评估任务之间具有更大的差异性。
6.2 指令编码与任务类别下的泛化
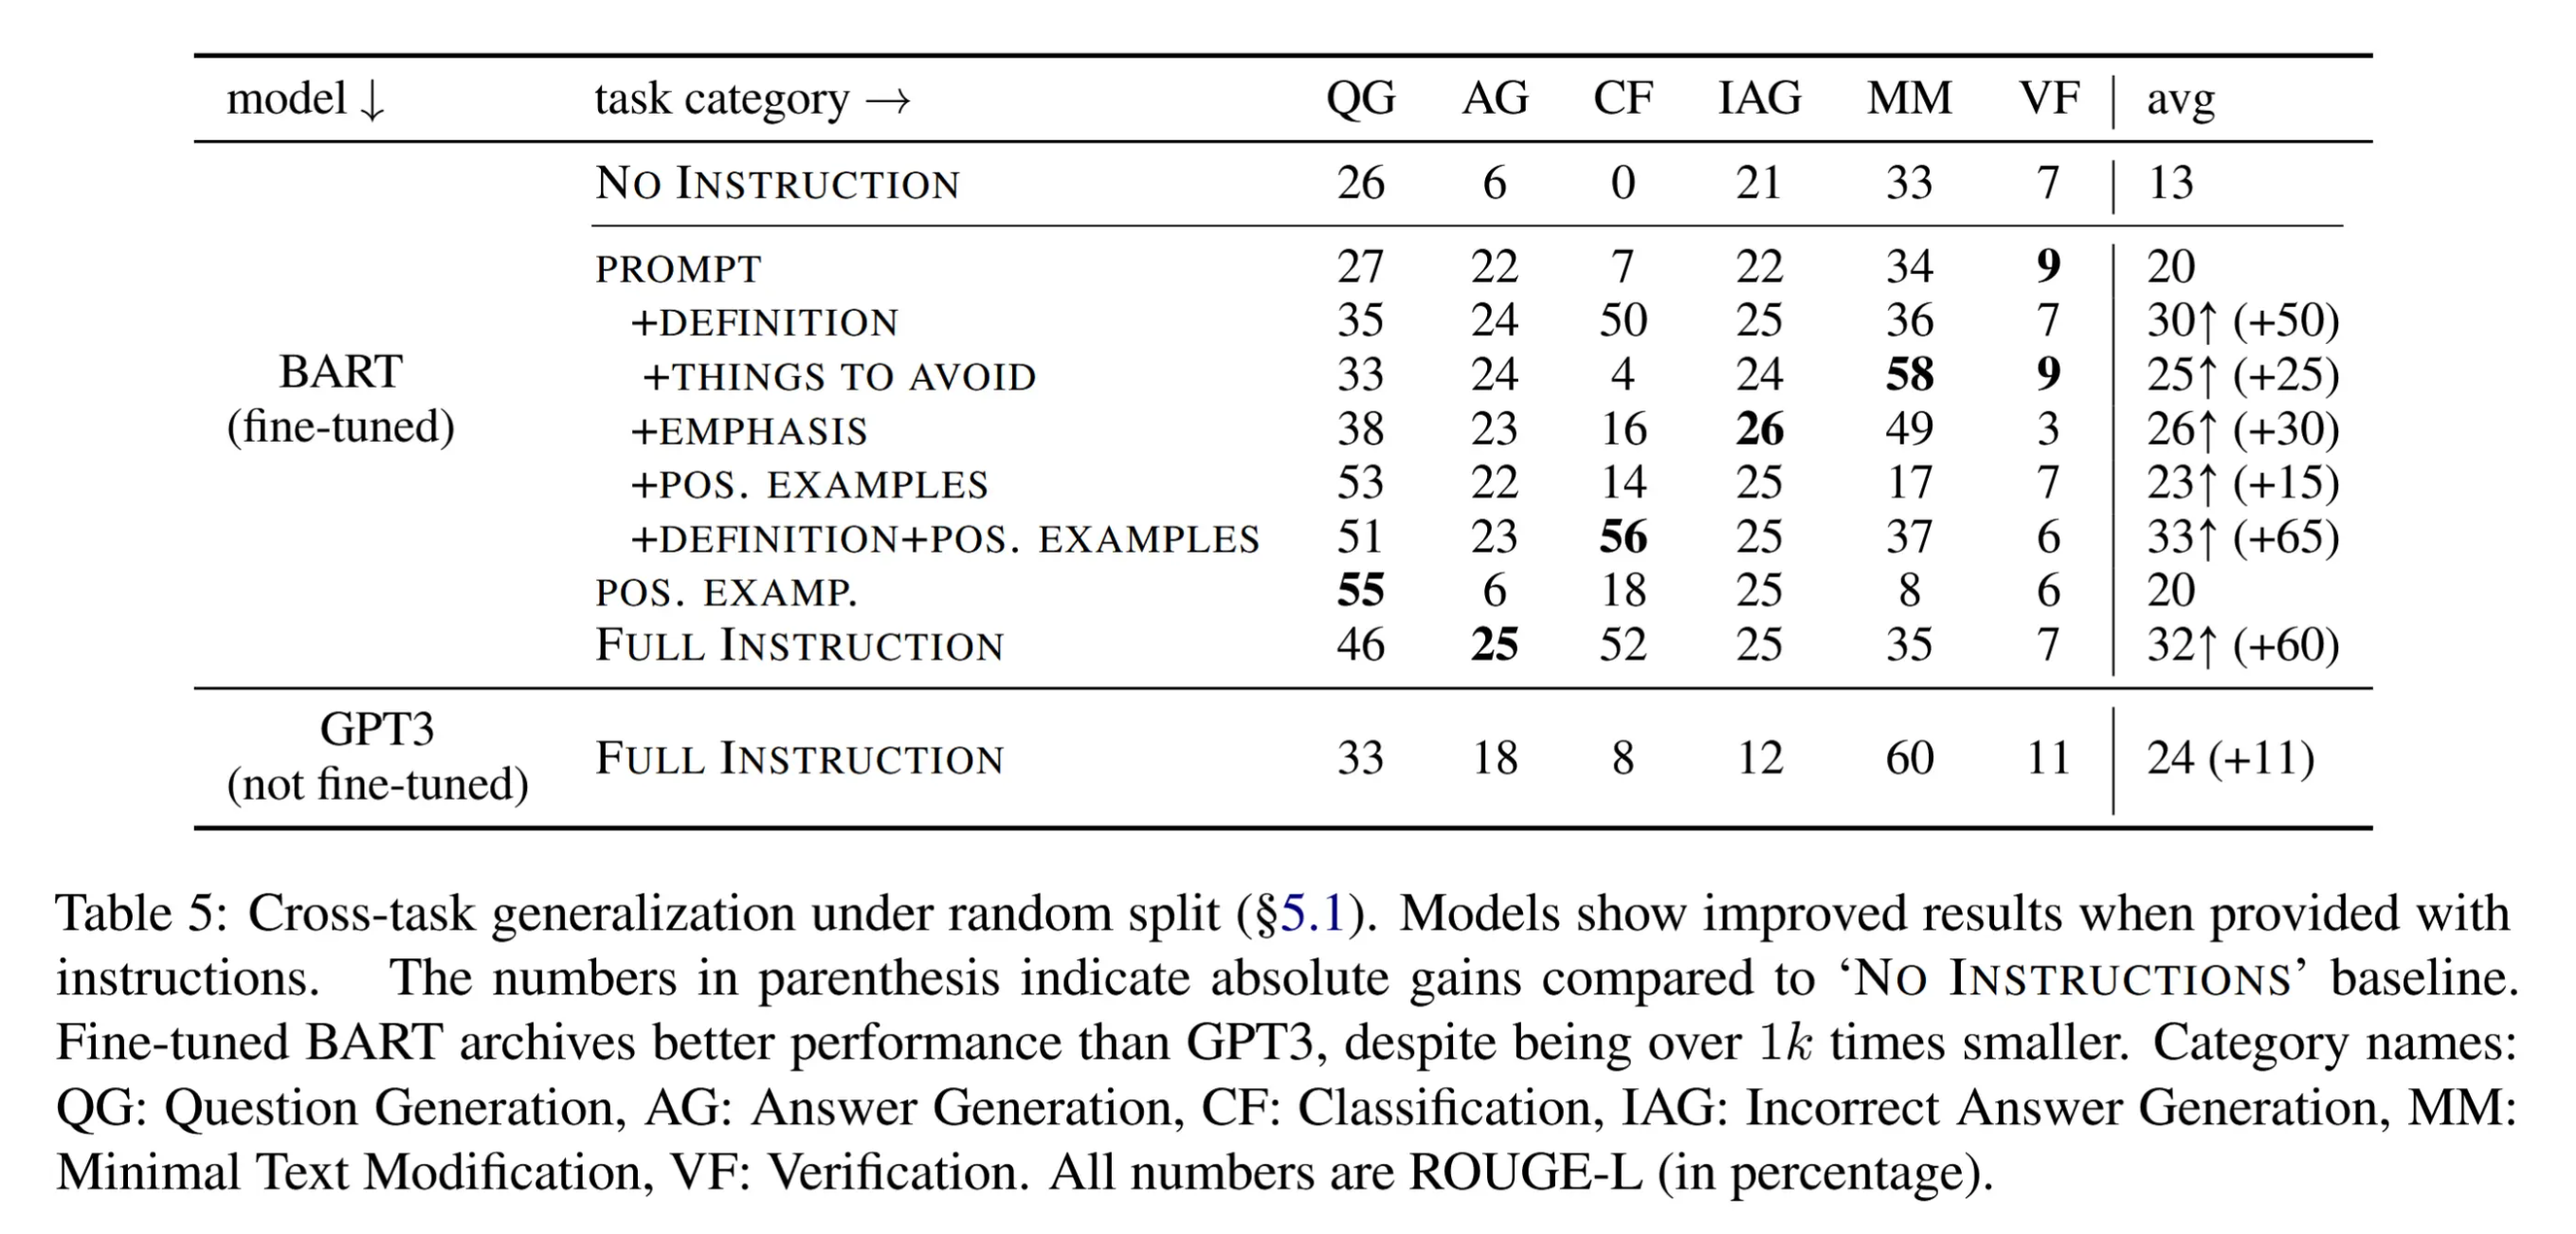
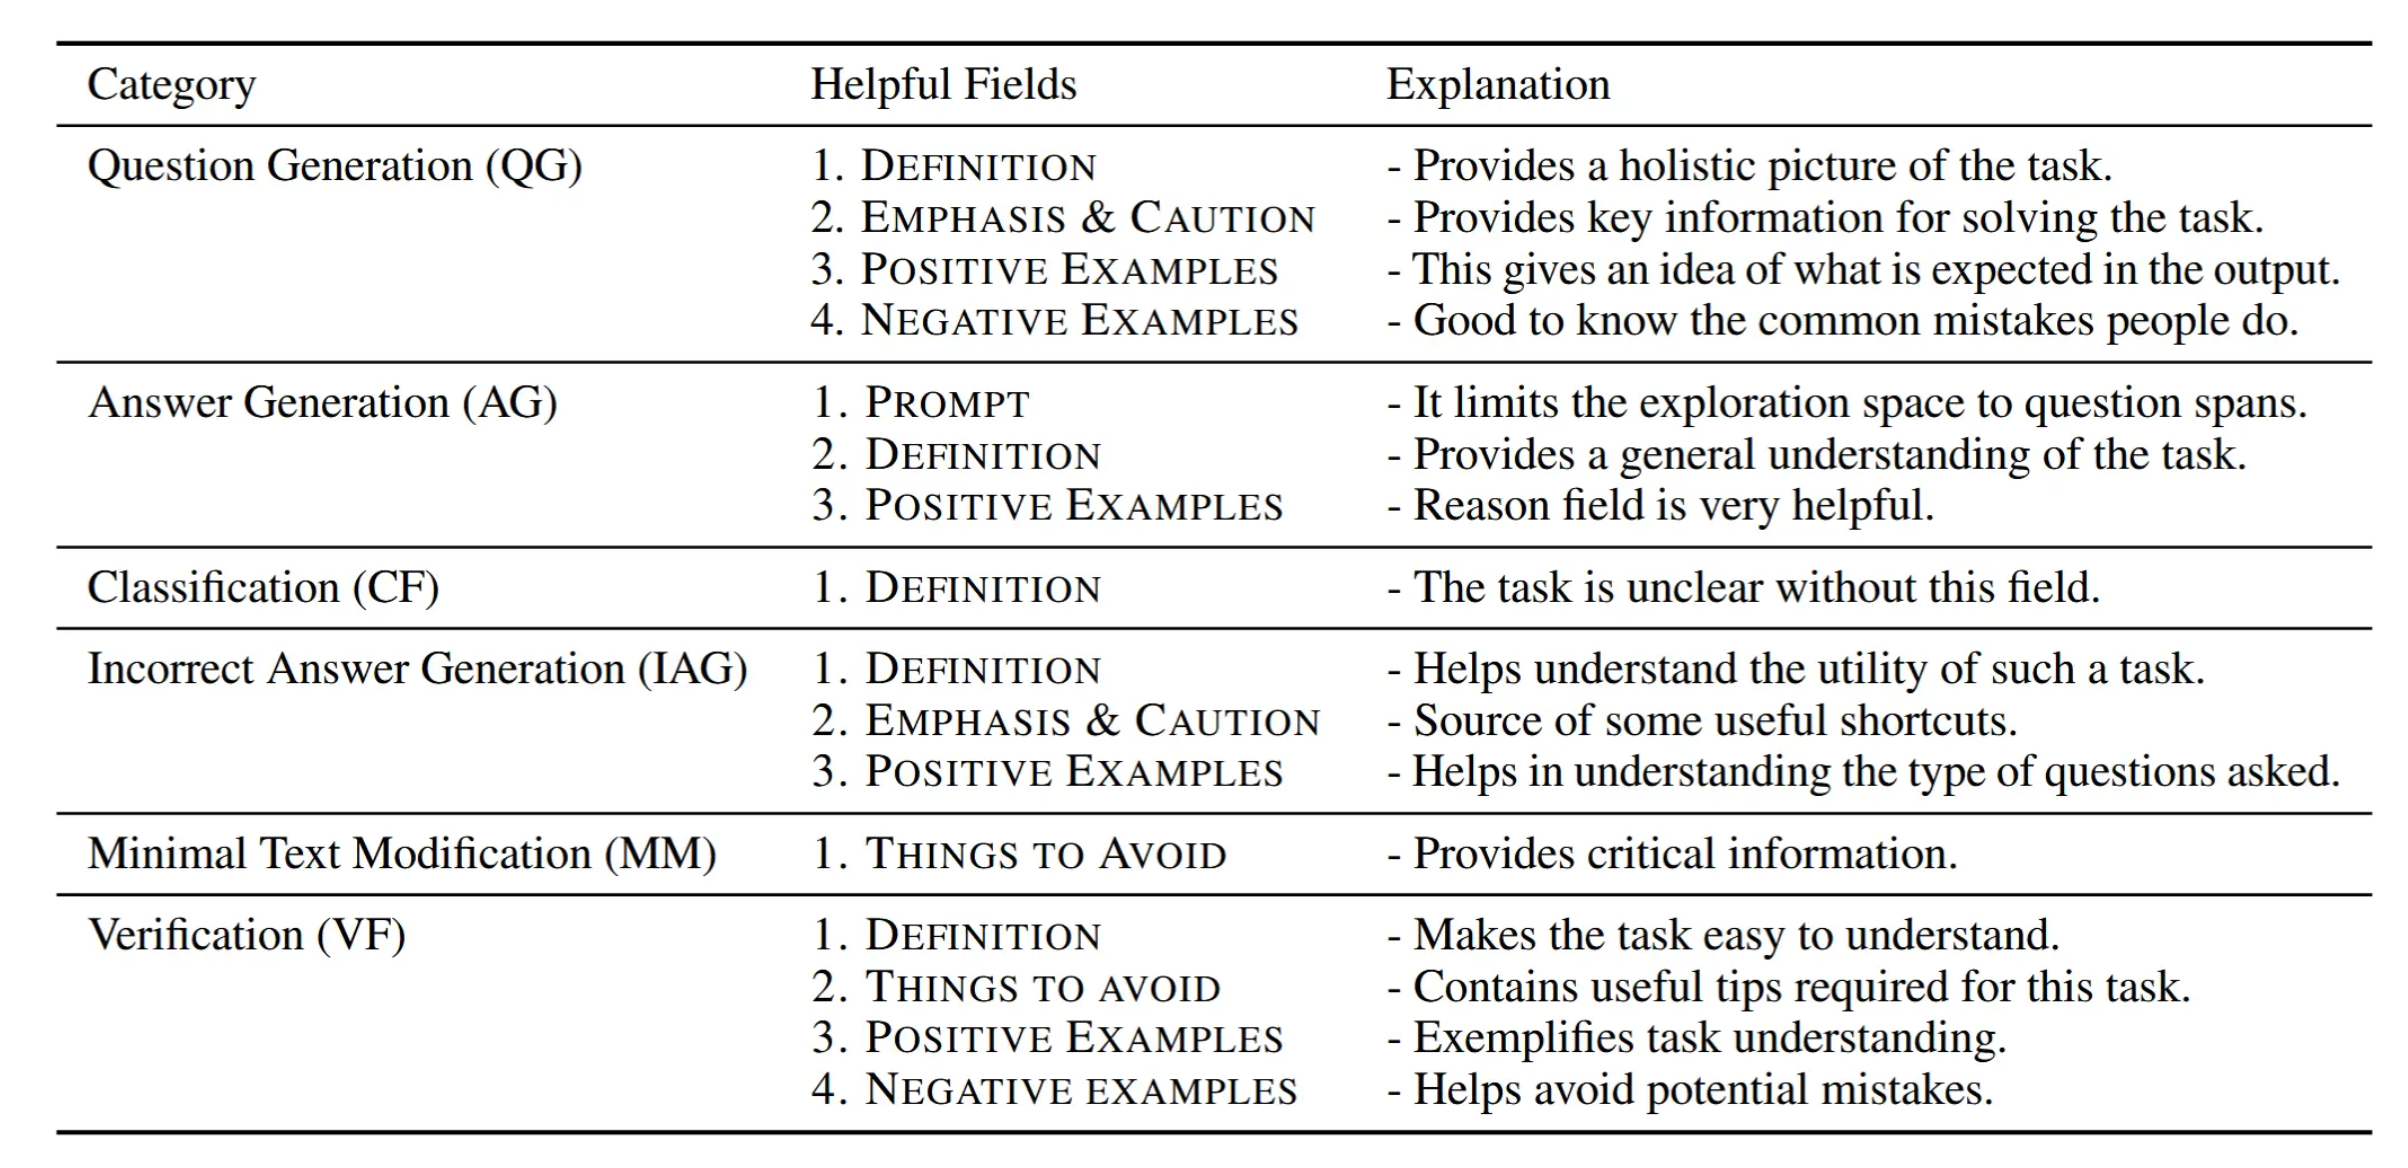
表5报告了BART模型在不同指令元素编码(§5.2)下以及不同任务类别上的结果。该表显示,与仅使用 PROMPT 或 POSITIVE EXAMPLES 相比,编码更多指令元素通常能取得更好的结果。它还表明,指令元素的收益似乎取决于目标任务类别。我们观察到,问题生成(QG)任务从 POSITIVE EXAMPLES 中获益最大,而在分类(CF)中,POSITIVE EXAMPLES 具有帮助甚微。我们假设这是因为基于少量示例模仿问题生成更容易,而通过少量示例定义类别则很困难,此时 DEFINITION 可能更有帮助。模型在验证(VF)上提升甚微。我们假设这些任务本质上更难,部分原因在于它们与数据集中其余任务存在差异。我们希望这一方向的未来工作能够研究更广泛的任务,并增进我们对这类失败案例的理解。我们假设这是因为,基于少量示例模仿问题生成更为容易,而通过少量示例定义类别则较为困难,此时 DEFINITION 可能更有帮助。模型在验证(VF)方面几乎没有提升。我们假设这些任务本质上更为困难,部分原因在于它们与数据集中其余任务存在明显差异。我们希望这一方向的未来工作能够研究更广泛的任务,并增进我们对这类失败案例的理解。
6.3 泛化与已见任务数量
图 2b 比较了已见任务数量对跨任务泛化的影响。在监督设置下,我们随机采样少量任务作为 T seen T_{\text{seen}} Tseen,并在 6 个任务(每个类别一个)上进行评估。(图中的每个点都是在 5 个随机子样本上取平均。)结果表明,使用 NOINSTRUCTION 编码时,观察更多任务没有实质性价值。相比之下,编码指令的模型其泛化能力会随着观察更多任务而提升。这是一个令人振奋的观察,因为它表明将我们的数据集扩展到更多任务可能会带来更强的指令遵循系统。
6.4 分析
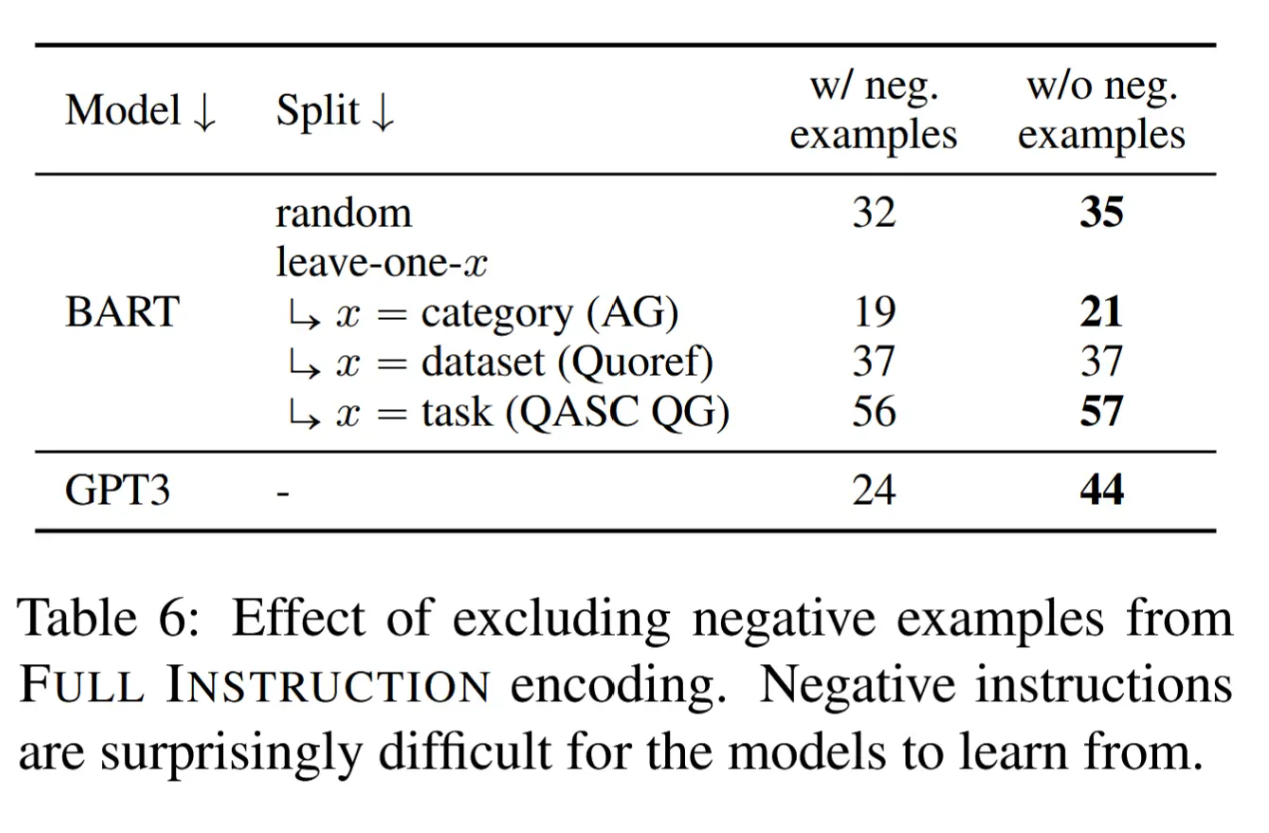
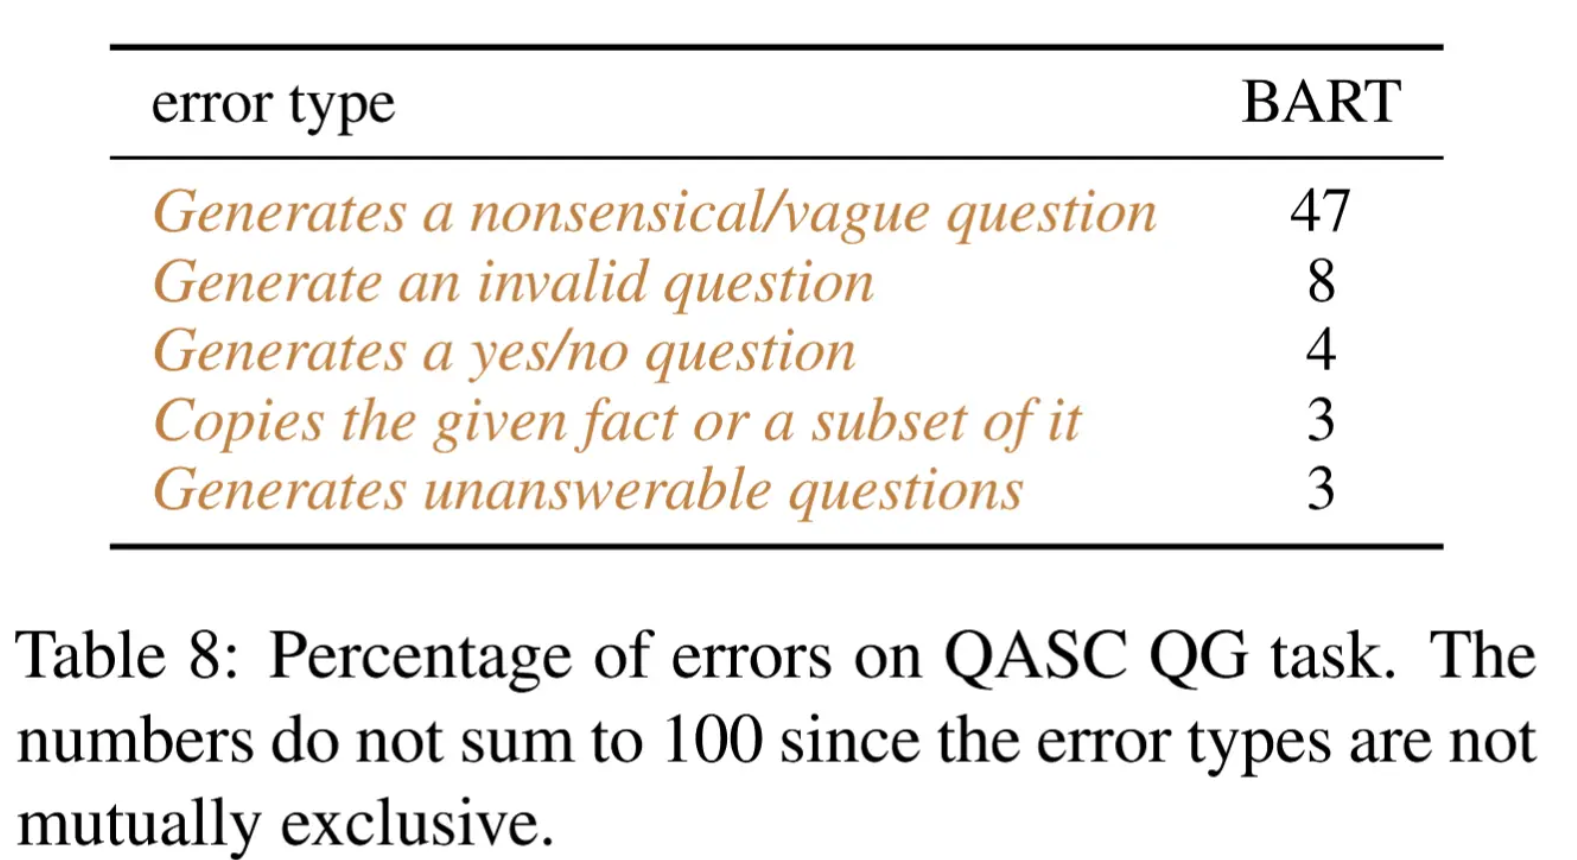
上界:任务特定模型。对于每个任务,我们通过在每个任务的标注训练数据上分别训练 BART 来获得一个任务特定模型(§ 3)。我们评估这些任务特定模型,以获得每个任务上界的粗略估计。平均而言,任务特定模型的得分为 66 % 66\% 66%,这大大高于我们模型的最佳泛化( 32 % 32\% 32%;表4)。这表明,对于基于泛化且使用指令的模型,仍有相当大的改进空间。 负例的影响。众包指令通常包含负例,以例示不期望的响应。我们研究指令中的负例如何影响跨任务泛化。我们的案例研究(表6)表明,模型在不使用(w/o)负例时表现更好,这与先前观察到的其他指令元素(例如,定义、正例)的益处相反。这与先前研究(Xuan et al., 2020;Lin et al., 2003)一致,这些研究讨论了从负例中学习的挑战。有趣的是,GPT3 的下降( 44 44 44 vs 24 24 24)比 BART( 35 35 35 vs 32 32 32)更显著,表明 BART 可以通过训练步骤部分恢复。 错误分析。我们随机抽取微调后的 BART 在 3 3 3 个不同任务上的 30 30 30 个错误预测(Winogrande 答案生成;QASC问题生成;MC-TACO 错误答案生成)。我们将错误归类为常见模式(表 8)。
7 结论
在本文中,我们研究了通过编码和理解众包指令来构建能够泛化到新任务的模型这一目标。我们介绍了 NATURAL INSTRUCTIONS,它基于现有的众包数据集构建,使得能够构建此类模型并对其进行系统评估。据我们所知,这是首个表明指令有助于改进跨任务泛化的工作。此外,我们观察到,我们提出的任务仍有很大的改进空间,我们相信这将使更多注意力转向构建能够泛化到更广泛任务的更强模型。
补充材料
A 数据集及其模板
A.1 将众包指令划分为最小任务
图 9 展示了针对 MC-TACO 数据集如何将一个任务划分为多个子任务的示例。MC-TACO 包含五个类别(事件持续时间、事件频率等)。每个类别贡献 2 个子任务,一个用于问题生成,一个用于答案生成。
每个数据集中的任务数量。图 6 展示了数据创建过程中的步骤数量在 6 个数据集之间如何变化。与 DROP、Quoref、CosmosQA 和 Winogrande 相比,QASC 和 MC-TACO 在数据创建过程中包含相对更多的步骤。
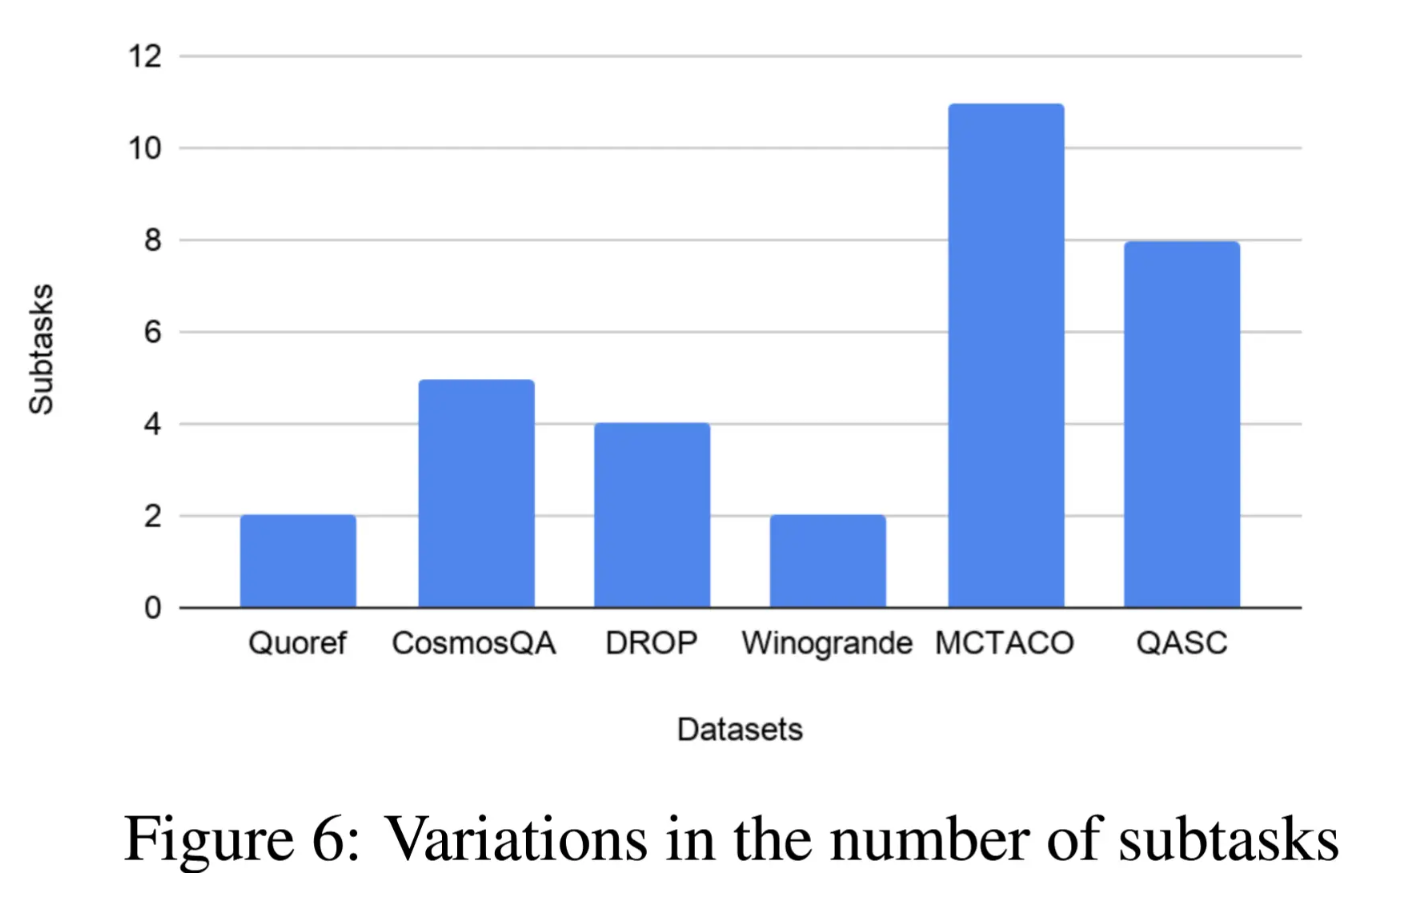
图 6:子任务数量的变化
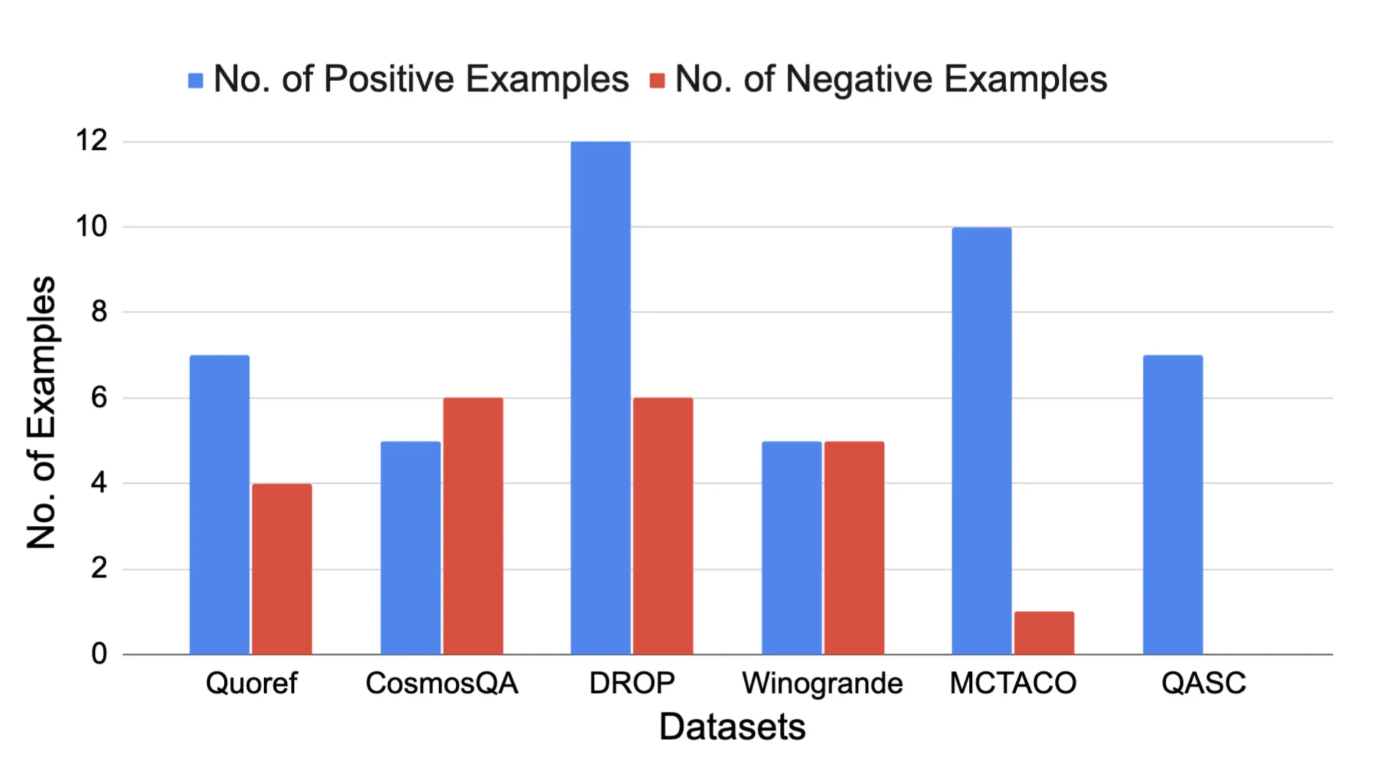
图7:正例和负例数量的变化
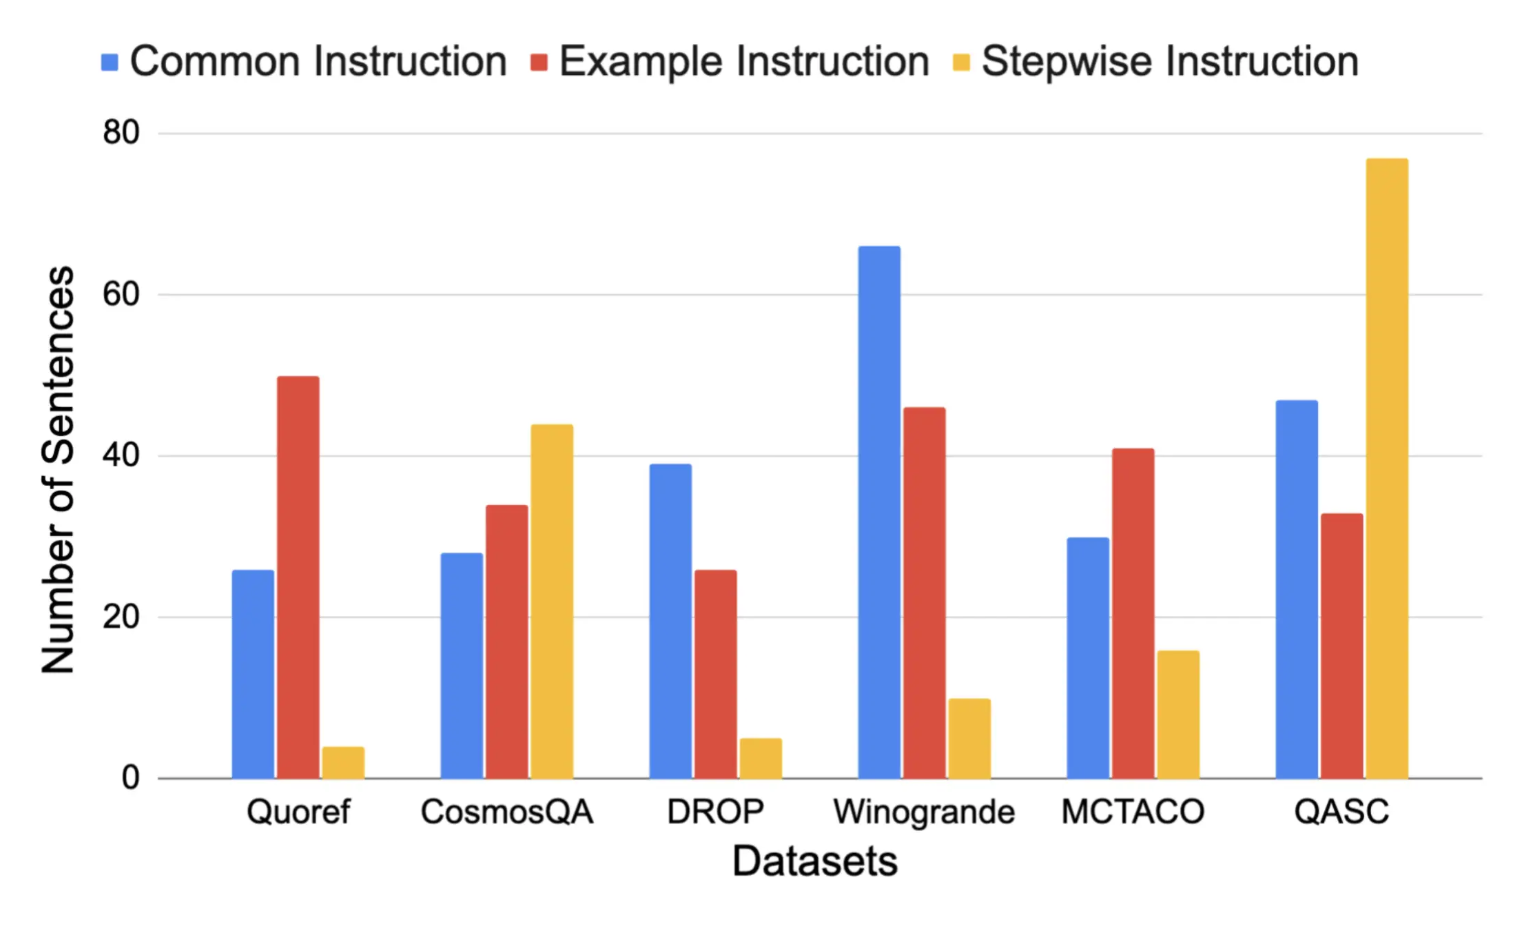
图 8:不同数据集的众包指令中句子数量的变化
A.2 众包模板分析
我们分析了 6 个数据集的众包模板:CosmosQA(Huang 等,2019)、DROP(Dua 等,2019)、MC-TACO(Zhou 等,2019)、QASC(Khot 等,2020)、Quoref(Dasigi 等,2019)和 Winogrande(Sakaguchi 等,2020)。我们进行分析的目的是识别各模板之间的相似性和差异,并据此决定是否收集更多模板。
说明的规模。我们观察到 6 个数据集之间存在显著差异(图 8)。在 QASC 的情况下,数据创建过程每一步相关说明的规模非常高,而对于 Winogrande,情况正好相反——数据创建过程每一步相关说明的规模非常低。相反,Winogrande 中通用说明(即数据创建过程第一步之前的说明)的规模很高;DROP 中也是如此。说明的主要模式因数据集而异。与数据创建每一步相关的示例和说明分别在 Quoref 和 CosmosQA 中占据大部分篇幅。MC-TACO 依靠示例来解释众包任务,而 Winogrande 和 QASC 则分别主要依靠通用说明和与数据创建过程每一步相关的说明来向众包工作者解释任务。
正例/负例的数量。图 7 展示了各数据集中正例和负例出现情况的变化。只有 Winogrande 提供了数量相等的正例和负例。QASC 的说明不包含任何负例。总体而言,DROP 的说明包含的示例数量相对多于其他数据集。
示例中理由/建议的存在。除 QASC 外,所有数据集均同时包含正例和负例。然而,Quoref 是唯一为所有正例和负例提供理由的数据集。每个负例都关联有解释,但解释的存在与正例相关的部分因数据集而异。最后,Quoref 是唯一一个提供建议以及负例相关原因的数据集。
A.3 定性分析
写作风格。数据集之间的写作风格存在显著差异,即使是在那些具有共同目标(例如 DROP、Quoref 和 QASC)的数据集之间也是如此。DROP 的指令说:“后台有一个 AI 在运行,它也会尝试回答该问题。如果该 AI 给出相同回答,你将无法提交该问题。”然而,Quoref 的写作风格不同:“我们还希望你避免提出那些实际上并不理解段落的人也能正确回答的问题。……”
信息。我们观察到,数据集的指令有时包含与若干其他数据集相关的信息,而这些其他数据集并不包含类似的指令信息。例如,Quoref、DROP 和 CosmosQA 都是基于阅读理解任务的数据集。CosmosQA 的数据创建过程中包含一个步骤,要求用户跳过包含不适当或冒犯性内容的段落。这一信息也与 Quoref 和 DROP 相关,但未在它们各自的指令中提及。
难度。在典型的众包任务中,某些任务可能比其他任务更难,通常这些是核心任务,例如:问题生成、对抗性数据创建等。补充信息,尤其是以提示形式给出的信息,总是有助于解决这些困难任务。图 10 表明,问题生成任务在 Quoref、CosmosQA 和 QASC 中的表述方式不同。QASC 提到了一种简单而详细的问题创建方式,而 CosmosQA 则提到了高质量问题的若干不同属性。了解 CosmosQA 和 QASC 的问题生成过程可能有助于为 Quoref 和其他此类问题生成任务,其中关于问题创建所提供的附加信息较少。
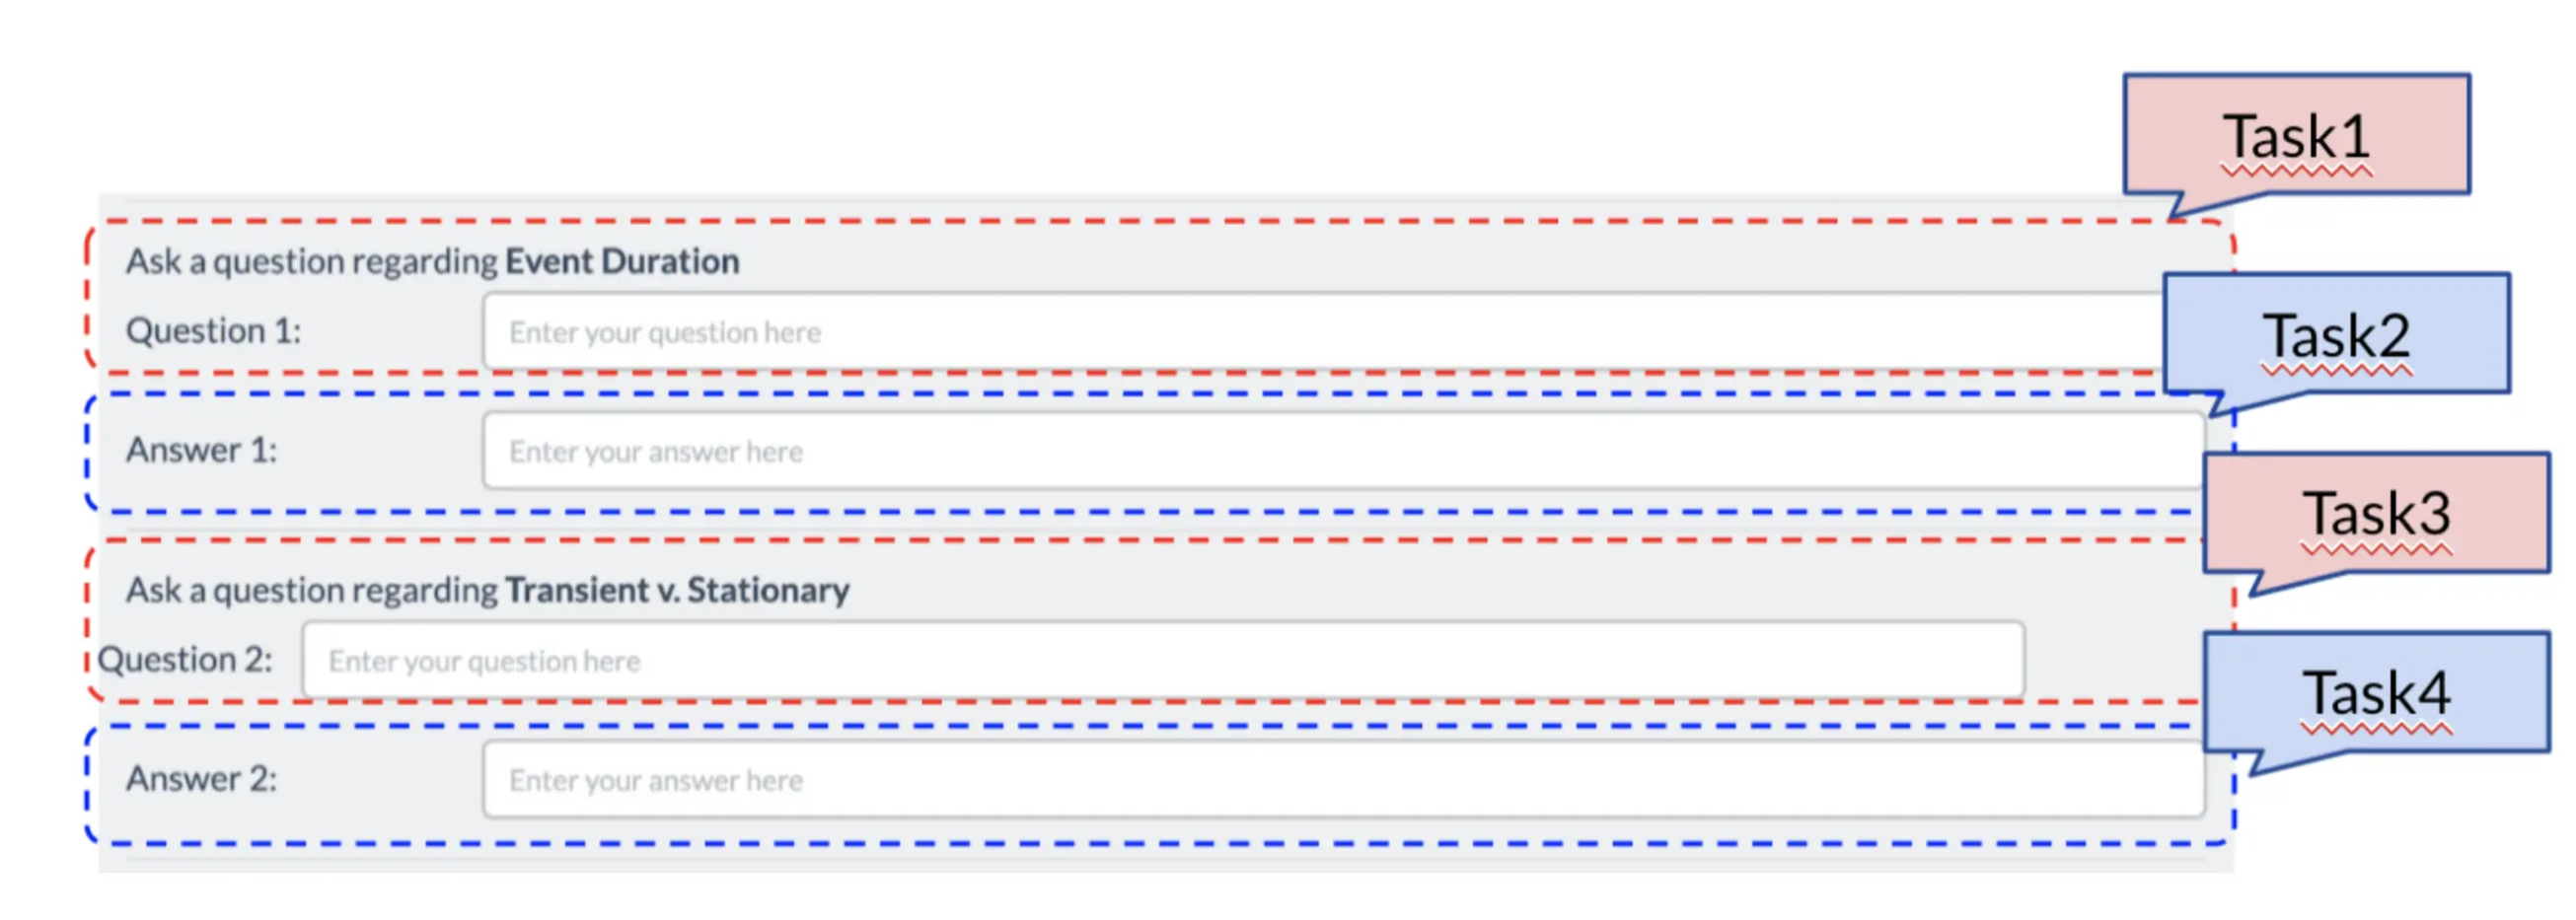
图 9:将数据创建任务划分为 MC-TACO 数据集的多个子任务。
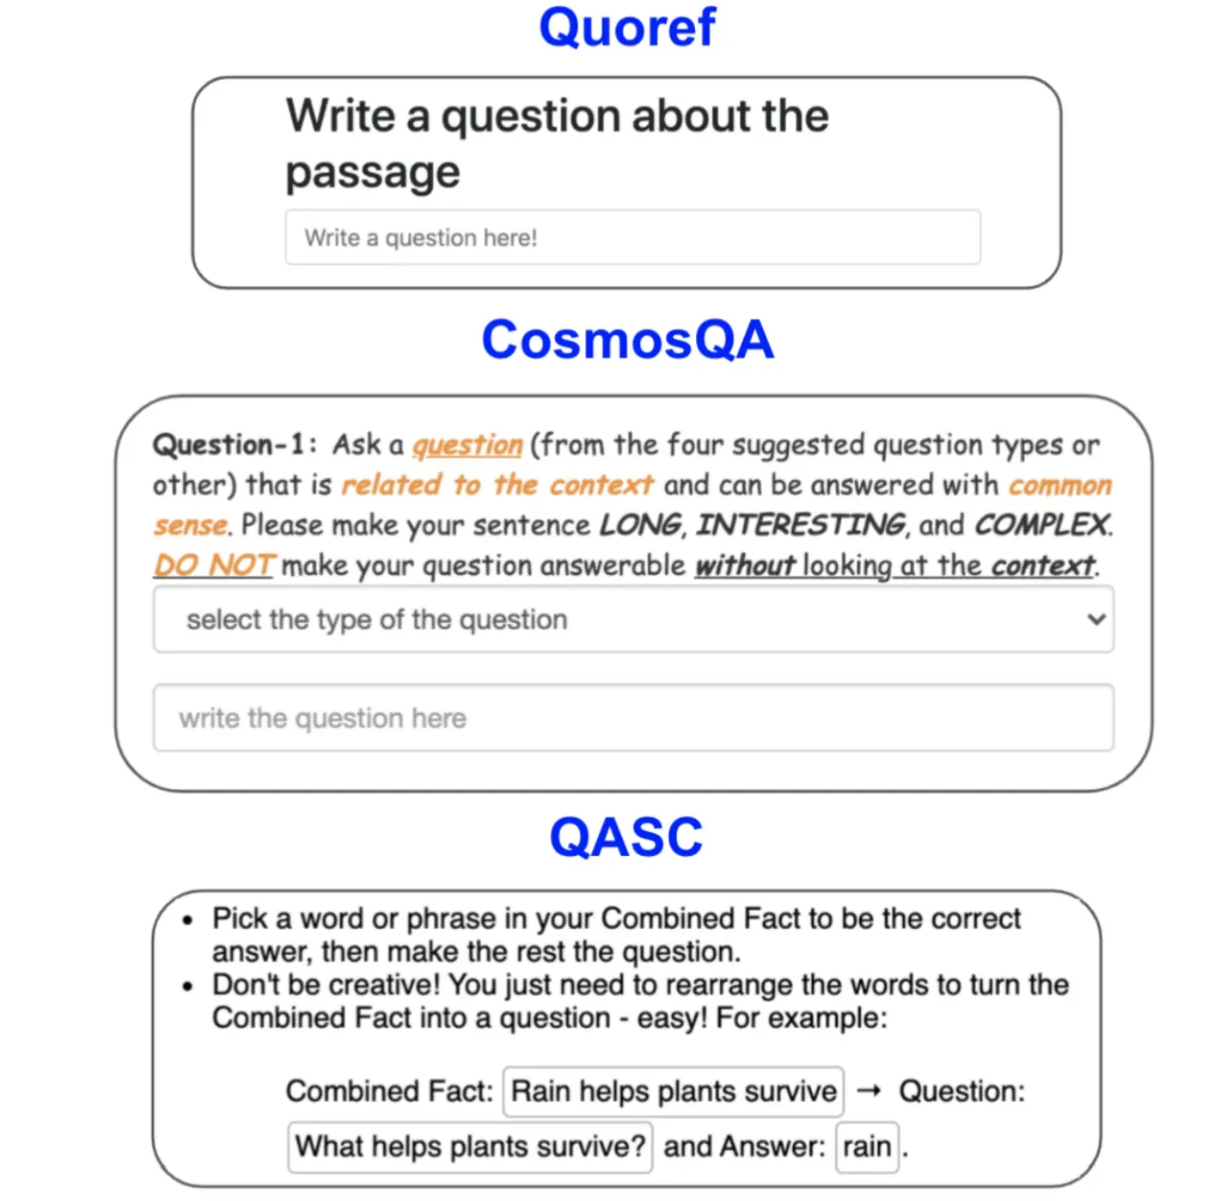
图10:任务说明的变化:Quoref 包含单行指令,而 CosomosQA 包含详细指令。另一方面,QASC 包含示例及指令。
A.4 数据整理工作量
表 9 展示了 NATURAL INSTRUCTIONS 数据整理过程中的工作量分布。涉及解析实例的第 8 步是数据整理过程中的主要瓶颈。表 10 展示了 NATURAL INSTRUCTIONS 中任务的详细结构。图 11 展示了 NATURAL INSTRUCTIONS 中四个不同任务的示例。
问题生成(来自 MC-TACO) - 标题:编写涉及对“事件持续时间”的常识理解的问题。 - 定义:在此任务中,我们要求你根据给定句子编写一个涉及“事件持续时间”的问题。这里,事件持续时间被定义为对事件通常持续多久的理解。例如,“刷牙”通常需要几分钟。 - 强调与注意事项:所编写的问题不要求具有唯一正确答案。 - 应避免的事项:不要创建在文本中明确提及答案的问题。相反,答案必须从给定内容中隐含推出。换句话说,我们希望你们运用“直觉”或“常识”。 -输入:句子:Jack放学后打篮球,之后他非常累。 - 输出:Jack打篮球打了多久? - 理由:该问题询问一个事件的持续时间;因此它是一个时间性事件持续时间问题。 正例 -输入:句子:他花了两个小时做作业。 - 输出:他做作业做了多久? - 理由:我们不想要这个问题,因为答案已在文本中直接提及。 - 建议:负例 - 提示:根据提供的句子提出一个关于“事件持续时间”的问题。 -输入:句子:尽管如此,Preetam发誓,如果Nandini再次见到他,他就娶她。 -预期输出:他们彼此认识多久了?
分类(来自 DROP) - 标题:寻找推理问题的答案类型 - 定义:该任务涉及为给定问题标注答案类型,这些问题涉及某种复杂推理(包括数值推理)。注意,这些问题需要查看篇章中不止一个部分才能回答。有 3 种可能的答案类型:(i)文本片段(span),(ii)数字(number),(iii)日期(date)。如果答案可以在篇章中找到,则将其标注为“span”。如果答案是数字,则标注为“number”。类似地,如果你认为给定问题的答案是日期,则标注为“date”。 - 重点与注意事项: - 应避免的事项: -输入:篇章:1756 年欧洲七年战争的爆发导致英法军队在印度重新爆发冲突。第三次卡纳提克战争蔓延到印度南部以外并进入孟加拉,英国军队于 1757 年占领了法国定居点 Chandernagore。然而,战争在南部决出胜负,英国成功保卫了 Madras,而 Eyre Coote 爵士于 1760 年在 Wandiwash 战役中决定性地击败了由 Comte de Lally 指挥的法国人。Wandiwash 之后,法国首府 Pondicherry 于 1761 年落入英国人之手。战争以 1763 年签署《巴黎条约》而结束,该条约将 Chandernagore 归还 […]。问题:英国最先占领的是哪个法国定居点,Chandernagore 还是 Pondicherry? - 输出:Span - 原因:答案“Chandernagore”是篇章中的一个词。因此,答案类型是“span”。 正例 负例 - 提示:与给定问题对应的答案类型是什么?Number、Date 还是 Span? -输入:篇章:为了从输给 Patriots 的失利中反弹,Raiders 留在主场,与 Houston Texans 进行第 16 周的对决。Oakland 在第一节早早取得领先,四分卫 JaMarcus Russell 向新秀外接手 Chaz Schilens 完成了一次 20 码的达阵传球。Texans 随即由全卫 Vonta Leach 完成 1 码冲球达阵作出回应,但 Raiders 又由踢球手 Sebastian Janikowski 踢进 33 码和 30 码射门得分予以回应。Houston 在第二节由踢球手 Kris Brown 踢进 53 码和 24 码射门得分,将比分扳平。Oakland 在第三节取得领先 […]。问题:Kris Brown 踢进了多少个射门得分? - 预期输出:Number
答案生成(来自 Winogrande) - 标题:回答关于物品的填空题 - 定义:你需要回答一个包含空白 (_) 的给定问题。你的答案必须是问题中提到的两个物品之一,例如“奖杯”和“手提箱”。 - 强调与注意: - 应避免的事项:你的答案不得包含问题中不存在的词。 -输入:上下文词:适合。问题:奖杯放不进棕色手提箱,因为 _ 太大。 -输出:奖杯 -原因:答案是该问题中的物品之一(“奖杯”和“手提箱”)。由于空白处是一个“大”的物品,无法放入“手提箱”,所以答案必须是“奖杯”。 正例 -输入:上下文词:适合。问题:奖杯放不进棕色手提箱,因为 _ 太大。 -输出:瓶子 -原因:问题在于,答案不是问题中存在的物品之一,即“奖杯”和“手提箱”。注意,有效答案必须是问题中存在的物品之一。 - 建议:负例 - 提示:回答一个基于所提供上下文词的填空题。 -输入:上下文词:故事。问题:看完电影后,凯莉开始撰写自己的故事。这个 _ 是为了她的研究。 -期望输出:电影
最小文本修改(来自 Winogrande)——标题:修改关于人物的填空题——定义:给定一个答案为人 PersonX 的填空题。你需要对给定问题进行最小修改,使答案翻转为 PersonY。该任务通常涉及将一个词(即“触发词”)替换为其反义词(例如,从“sympathetic”改为“stern”)。——重点与注意:1. 你的问题必须包含至少 15 个且至多 30 个单词。2. 你的问题必须与给定问题至少有 70% 的重叠词。3. 你的问题必须仅包含一个空。4. 确保 PersonX 和 PersonY 性别相同。6. 在你的问题中,PersonX 和 PersonY 只能各使用一次,且 PersonX 应早于 PersonY 出现。[…]——应避免的事项:1. 除了一两个词(即触发词/短语)之外,你不应更改给定问题中的任何内容。[…]——输入:上下文词:upset。问题:PersonX 对 PersonY 大喊,因为 _ 对这则新闻感到非常沮丧。答案:PersonX。——输出:PersonX 安慰了 PersonY,因为 _ 对这则新闻感到非常沮丧。——原因:将触发词“yelled”替换为其反义词“comforted”后,答案翻转为 PersonY,这符合给定指令。因此,这是一个有效问题。正例——提示:与给定问题对应的答案类型是什么?数字、日期还是跨度?——输入:上下文词:day。问题:PersonX 从 PersonY 那里学到了新的组织技能,因为 _ 的日间日程非常混乱。答案:PersonX——预期输出:PersonX 从 PersonY 那里学到了新的组织技能,因为 _ 的日间日程非常高效。
图 11:NATURAL INSTRUCTIONS 中的示例。每个任务均遵循图 4 中提供的模式。
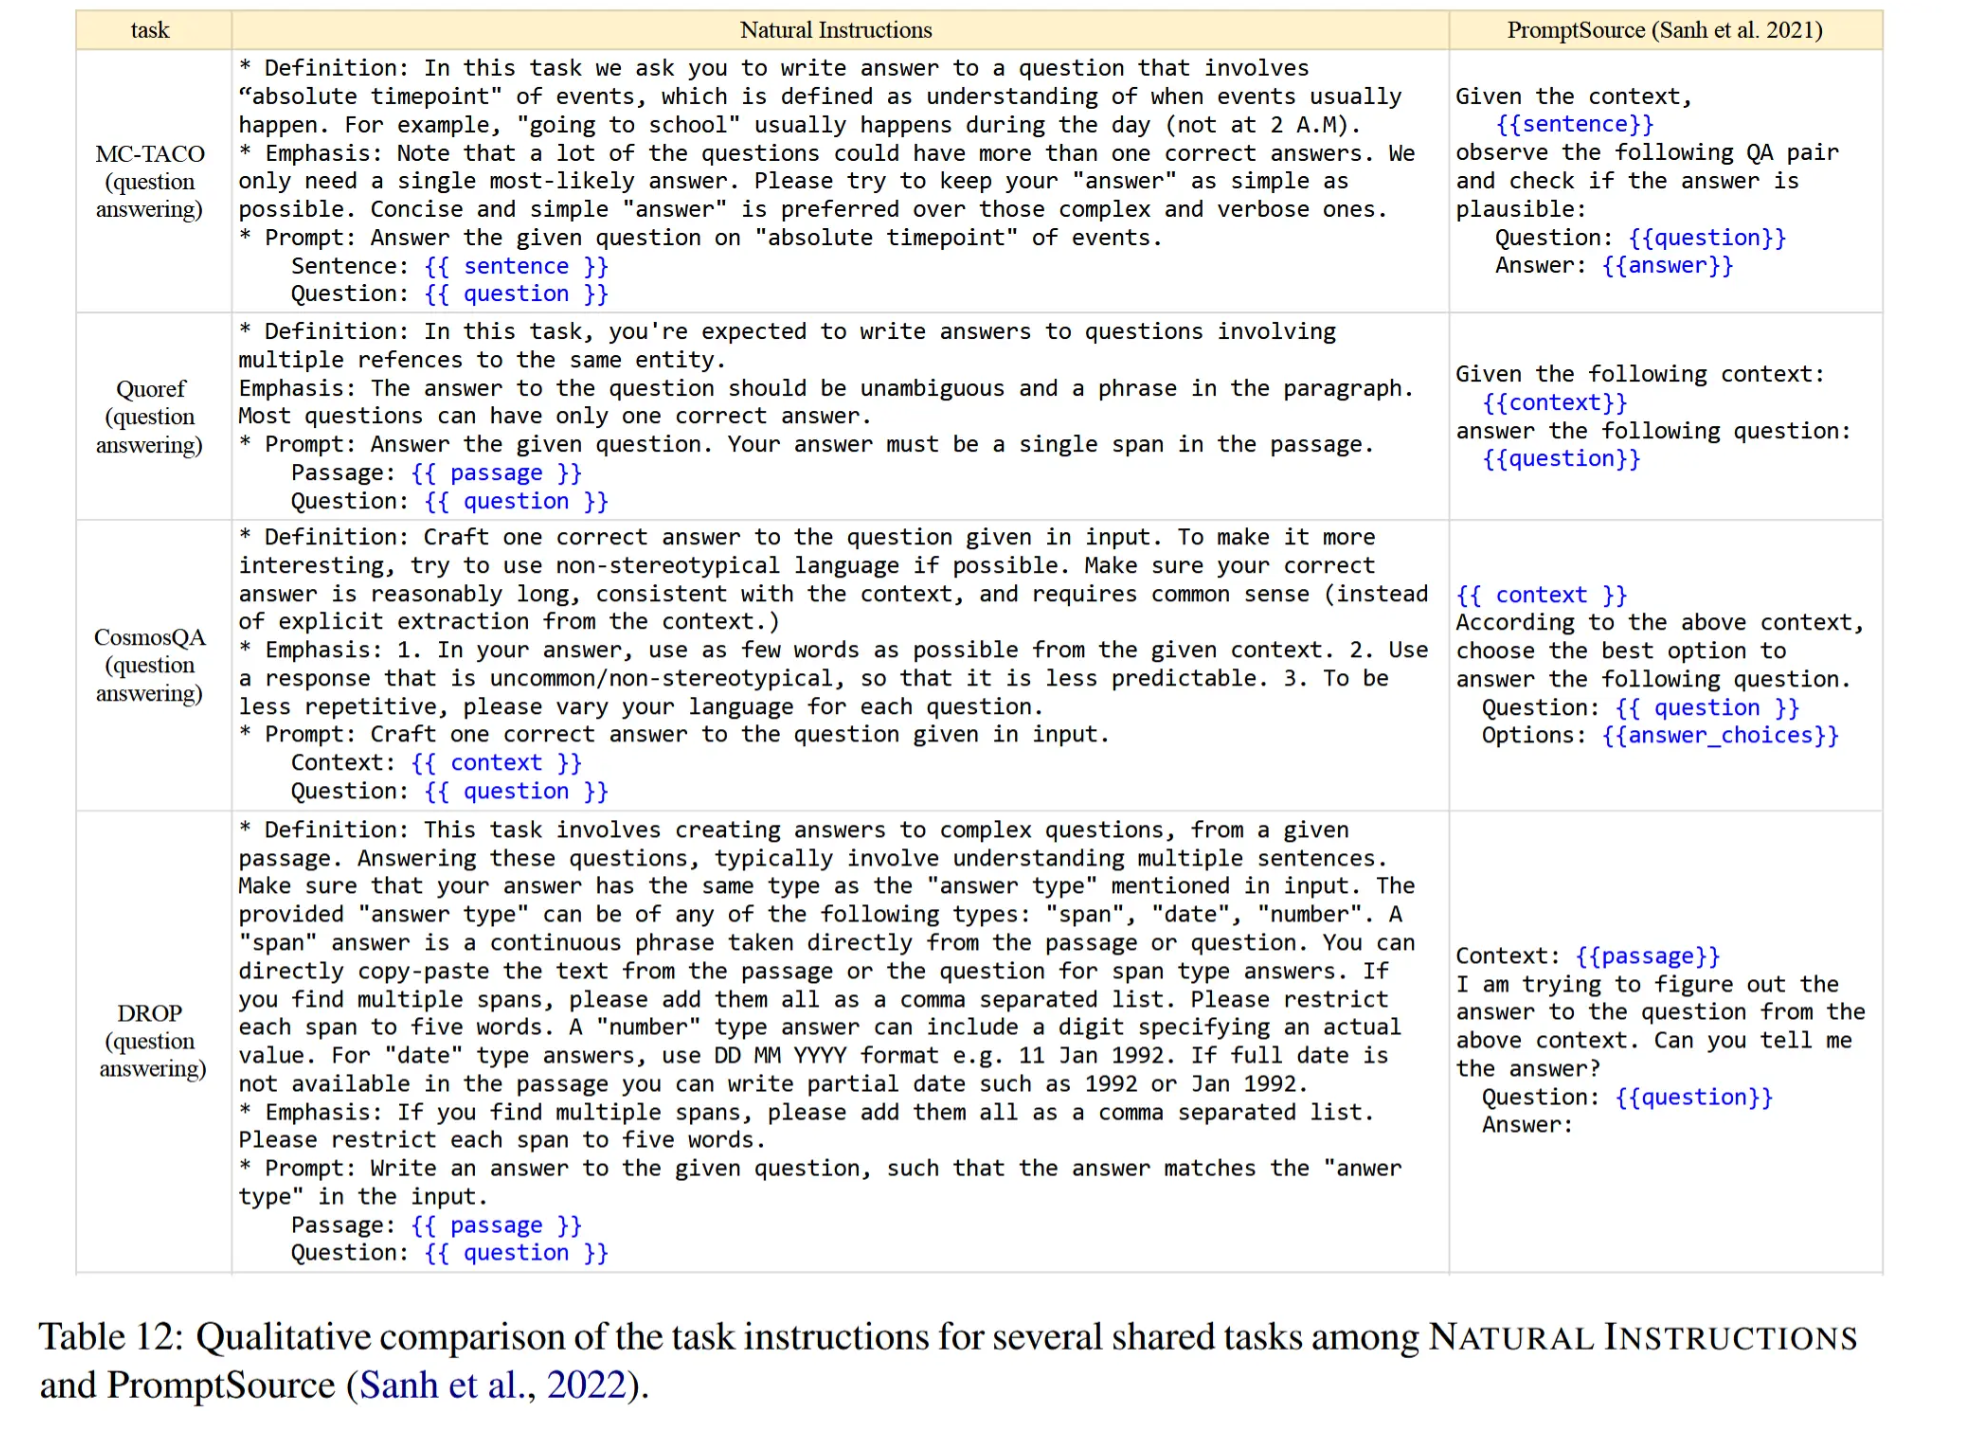
A.5 与 PromptSource 的定性比较
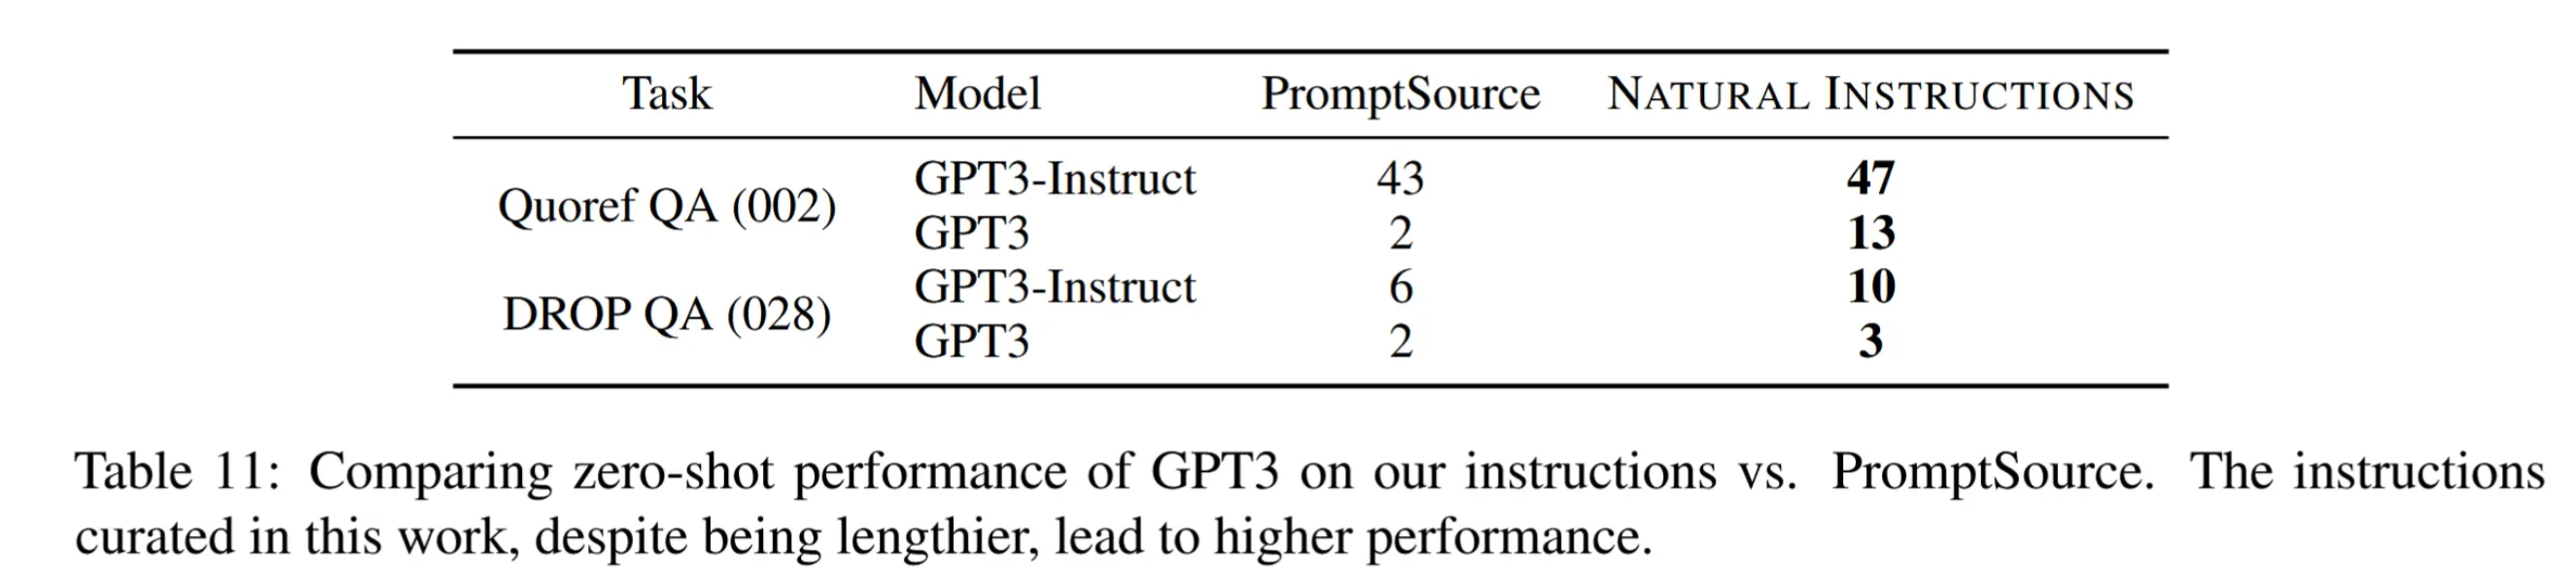
我们提供了所提出数据集与 PromptSource(Sanh 等,2022)之间的比较。PromptSource 任务主要关注常见的 NLP 下游任务(如问答、共指、NLI 等)。然而,由于我们是从数据创建过程中的各个步骤(包括中间步骤)创建任务的,因此我们的指令包含更为广泛多样的任务。例如,用于串联事实的任务(任务 38;表 10)、问题类型判定(任务 27;表 10)或检测不当内容(任务 22;表 10)是 NATURAL INSTRUCTIONS 中独有的新增任务。此外,由于我们的指令最初是由多位研究人员为众包工作者编写的,因此它们详尽细致,并包含每个任务的完整定义。这一点从 GPT3 在我们的指令上取得更高性能这一观察中有所体现(表 11)。最后但同样重要的是,由于我们以结构化格式表示指令,我们能够消融指令的各个元素(定义、负例/正例等),并实证量化它们的贡献(§6)。
B 为 NATURAL INSTRUCTIONS 构建基线
在本节中,我们提供关于我们工作中所包含基线的若干细节。
B.1 指令的编码
根据我们的模式(§4.1),第
t
t
t 个任务的每条指令
I
t
I_t
It 是一个包含以下字段的集合:
I
t
=
{
I
title
t
,
I
def.
t
,
I
avoid
t
,
I
emph.
t
,
I
prompt
t
,
I
pos. ex.
t
,
I
neg. ex.
t
}
I_t = \{ I_{\text{title}}^t, I_{\text{def.}}^t, I_{\text{avoid}}^t, I_{\text{emph.}}^t, I_{\text{prompt}}^t, I_{\text{pos. ex.}}^t, I_{\text{neg. ex.}}^t \}
It={Ititlet,Idef.t,Iavoidt,Iemph.t,Ipromptt,Ipos. ex.t,Ineg. ex.t}
为了将实例输入到语言模型(LMs),我们首先将它们编码为纯文本。令
e
n
c
(
I
,
x
)
\mathrm{enc}(I, x)
enc(I,x) 定义一个函数,该函数将给定指令
I
I
I 和输入实例
x
x
x 映射为纯文本。显然,该函数有许多选择。在我们的研究中,我们考虑以下编码:
无指令编码。这种编码是不存在指令的传统范式:
e
n
c
(
I
t
,
x
)
:
=
输入:
x
输出:
(1)
\mathrm{enc}(I_t, x) := \text{输入:} x \quad \text{输出:} \tag{1}
enc(It,x):=输入:x输出:(1)
提示编码。在这种编码中,我们将提示消息附加在输入之前:
e
n
c
(
I
t
,
x
)
:
=
提示:
I
prompt
t
输入:
x
输出:
(2)
\mathrm{enc}(I_t, x) := \text{提示:} I_{\text{prompt}}^t \quad \text{输入:} x \quad \text{输出:} \tag{2}
enc(It,x):=提示:Ipromptt输入:x输出:(2)
提示 + 定义编码。在这种编码中,提示消息和任务定义出现在输入之前:
e
n
c
(
I
t
,
x
)
:
=
定义:
I
def.
t
提示:
I
prompt
t
输入:
x
输出:
(3)
\mathrm{enc}(I_t, x) := \text{定义:} I_{\text{def.}}^t \quad \text{提示:} I_{\text{prompt}}^t \quad \text{输入:} x \quad \text{输出:} \tag{3}
enc(It,x):=定义:Idef.t提示:Ipromptt输入:x输出:(3)
直观上,这种编码比“提示”编码包含更多信息,也更复杂。
完整指令编码。这种编码包含所有指令内容:
e
n
c
(
I
t
,
x
)
:
=
定义:
I
def.
t
提示:
I
prompt
t
需避免的事项:
I
avoid
t
强调与注意:
I
emph.
t
负例1:
输入:
I
pos. ex.
t
(
输入
)
输出:
I
pos. ex.
t
(
输出
)
理由:
I
pos. ex.
t
(
理由
)
负例2:
…
正例1:
输入:
I
pos. ex.
t
(
输入
)
输出:
I
pos. ex.
t
(
输出
)
理由:
I
pos. ex.
t
(
理由
)
正例2:
…
输入:
x
输出:
(4)
\begin{aligned} \mathrm{enc}(I_t, x) := & \text{定义:} I_{\text{def.}}^t \\ & \text{提示:} I_{\text{prompt}}^t \\ & \text{需避免的事项:} I_{\text{avoid}}^t \\ & \text{强调与注意:} I_{\text{emph.}}^t \\ & \text{负例1:} \\ & \quad \text{输入:} I_{\text{pos. ex.}}^t(\text{输入}) \\ & \quad \text{输出:} I_{\text{pos. ex.}}^t(\text{输出}) \\ & \quad \text{理由:} I_{\text{pos. ex.}}^t(\text{理由}) \\ & \text{负例2:} \ldots \\ & \text{正例1:} \\ & \quad \text{输入:} I_{\text{pos. ex.}}^t(\text{输入}) \\ & \quad \text{输出:} I_{\text{pos. ex.}}^t(\text{输出}) \\ & \quad \text{理由:} I_{\text{pos. ex.}}^t(\text{理由}) \\ & \text{正例2:} \ldots \\ & \text{输入:} x \quad \text{输出:} \end{aligned} \tag{4}
enc(It,x):=定义:Idef.t提示:Ipromptt需避免的事项:Iavoidt强调与注意:Iemph.t负例1:输入:Ipos. ex.t(输入)输出:Ipos. ex.t(输出)理由:Ipos. ex.t(理由)负例2:…正例1:输入:Ipos. ex.t(输入)输出:Ipos. ex.t(输出)理由:Ipos. ex.t(理由)正例2:…输入:x输出:(4)
其中
e
n
c
exp
(
I
t
)
\mathrm{enc}_{\text{exp}}(I_t)
encexp(It) 是一种交替编码正例和负例的编码。在超出输入限制之前,我们尽可能多地包含示例。
正例编码。这种编码仅包含子任务的正例(不含任务描述等)。
e
n
c
(
I
t
,
x
)
:
=
输入:
I
pos. ex.
t
(
输入
)
输出:
I
pos. ex.
t
(
输出
)
…
输入:
x
输出:
(5)
\mathrm{enc}(I_t, x) := \text{输入:} I_{\text{pos. ex.}}^t(\text{输入}) \quad \text{输出:} I_{\text{pos. ex.}}^t(\text{输出}) \quad \ldots \quad \text{输入:} x \quad \text{输出:} \tag{5}
enc(It,x):=输入:Ipos. ex.t(输入)输出:Ipos. ex.t(输出)…输入:x输出:(5)
这种仅使用示例的编码已被该领域若干近期研究使用(Zhao 等,2021)。
C 基线结果分析
C.1 与原始指令的比较
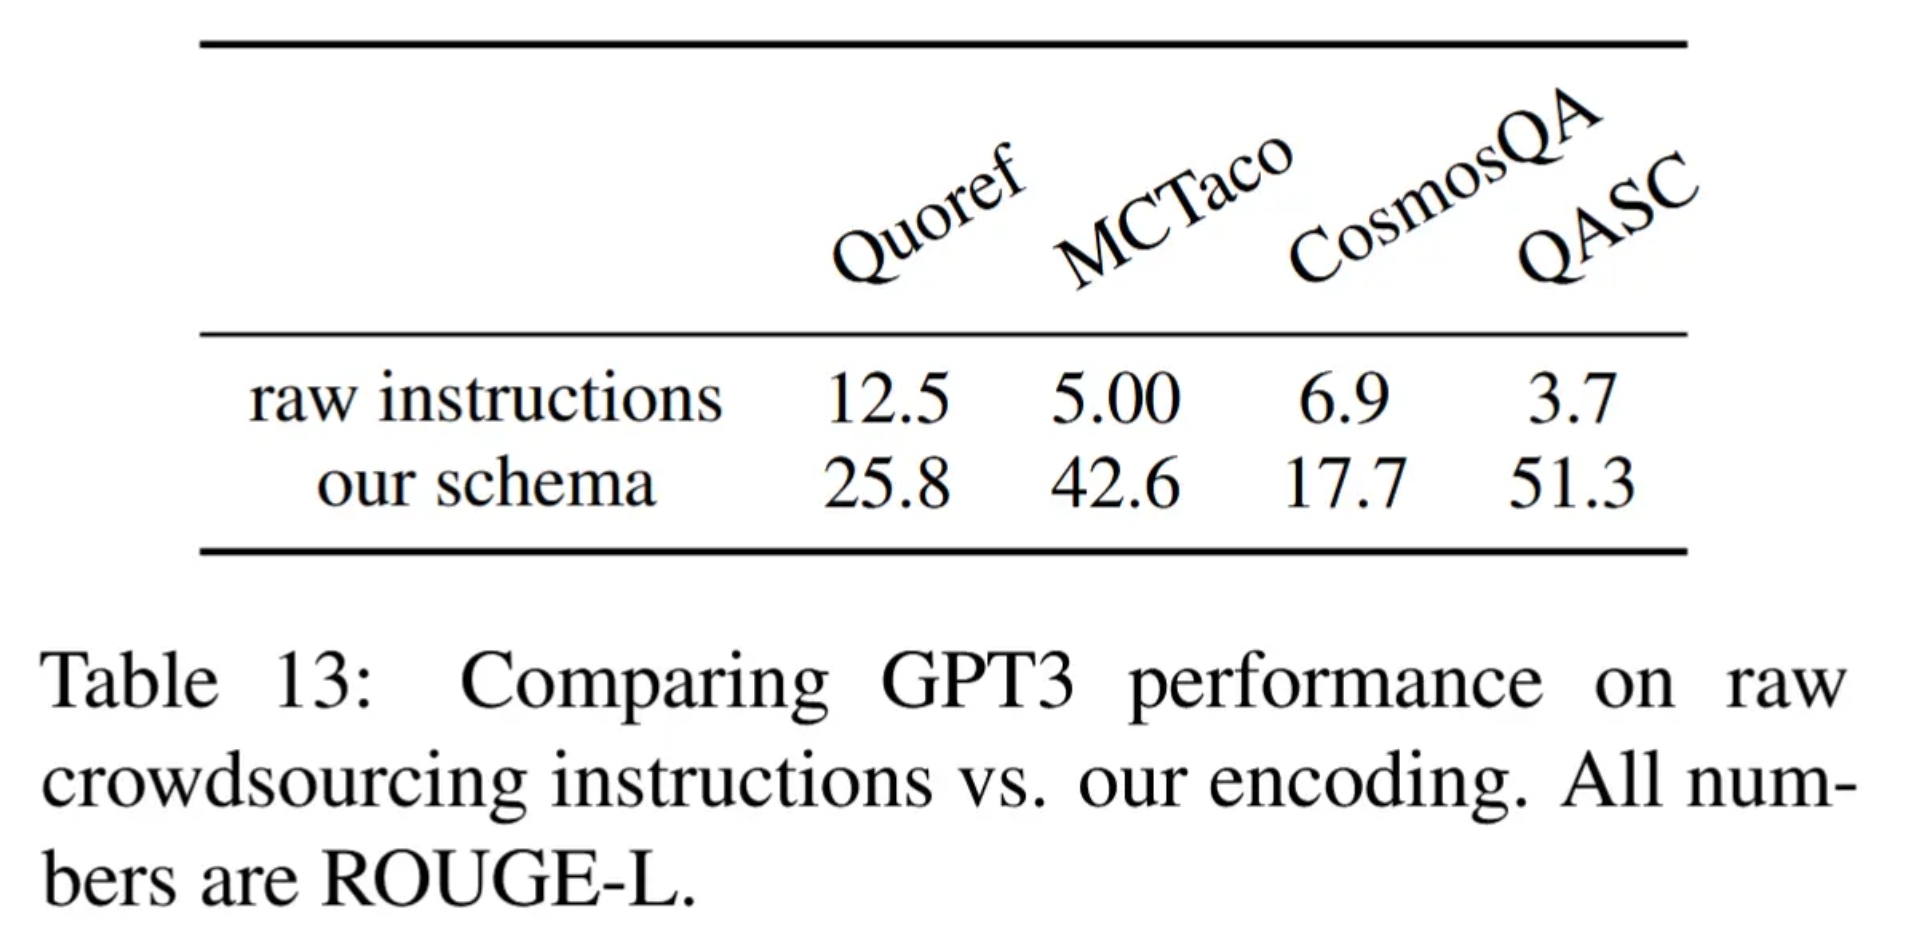
我们试图理解将任务分解为子任务,并将其映射到我们提出的模式(§4.2)中的价值。我们按照 (Efrat and Levy, 2020) 设置的方式,计算原始指令(四个数据集的第一个子任务)的性能。我们将其与我们的 FULL INSTRUCTION - NEG EXAMPLES 编码进行比较。表13中的结果表明,与原始指令(第一行)相比,GPT3 在我们的编码(第二行)下取得了更高的性能。语言模型(LMs)在原始指令上的较弱性能与 (Efrat and Levy, 2020) 的发现一致,即“语言模型表现不佳”。
引用文献
Armen Aghajanyan, Anchit Gupta, Akshat Shrivastava, Xilun Chen, Luke Zettlemoyer, and Sonal Gupta. 2021. Muppet: Massive multi-task representations with pre-finetuning. In Proceedings of EMNLP, pages 5799–5811.
Ali M Ali. 1981. The use of positive and negative examples during instruction. Journal of instructional development, 5(1):2–7.
Iz Beltagy, Matthew E Peters, and Arman Cohan. 2020. Longformer: The long-document transformer. arXiv preprint arXiv:2004.05150.
Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, Sandhini Agarwal, Ariel HerbertVoss, Gretchen Krueger, Tom Henighan, Rewon Child, Aditya Ramesh, Daniel Ziegler, Jeffrey Wu, Clemens Winter, Chris Hesse, Mark Chen, Eric Sigler, Mateusz Litwin, Scott Gray, Benjamin Chess, Jack Clark, Christopher Berner, Sam McCandlish, Alec Radford, Ilya Sutskever, and Dario Amodei. 2020. Language models are few-shot learners. In NeurIPS, volume 33, pages 1877–1901. Curran Associates, Inc.
Rich Caruana. 1997. Multitask learning. Machine learning, 28(1):41–75.
Pradeep Dasigi, Nelson F Liu, Ana Marasovic, Noah A Smith, and Matt Gardner. 2019. Quoref: A reading comprehension dataset with questions requiring coreferential reasoning. In Proceedings of EMNLP-IJCNLP, pages 5927–5934.
Dheeru Dua, Yizhong Wang, Pradeep Dasigi, Gabriel Stanovsky, Sameer Singh, and Matt Gardner. 2019. Drop: A reading comprehension benchmark requiring discrete reasoning over paragraphs. In Proceedings of NAACL, pages 2368–2378.
Avia Efrat and Omer Levy. 2020. The turking test: Can language models understand instructions? arXiv preprint arXiv:2010.11982.
Tanmay Gupta, A. Kamath, Aniruddha Kembhavi, and Derek Hoiem. 2021. Towards general purpose vision systems. ArXiv, abs/2104.00743.
Peter Hase and Mohit Bansal. 2021. When can models learn from explanations? a formal framework for understanding the roles of explanation data. arXiv preprint arXiv:2102.02201.
Lifu Huang, Ronan Le Bras, Chandra Bhagavatula, and Yejin Choi. 2019. Cosmos qa: Machine reading comprehension with contextual commonsense reasoning. In Proceedings of EMNLP-IJCNLP, pages 2391–2401.
Daniel Khashabi, Snigdha Chaturvedi, Michael Roth, Shyam Upadhyay, and Dan Roth. 2018. Looking beyond the surface: A challenge set for reading comprehension over multiple sentences. In Proceedings of NAACL, pages 252–262.
Daniel Khashabi, Tushar Khot, Ashish Sabharwal, and Dan Roth. 2017. Learning what is essential in questions. In Proceedings of CoNLL, pages 80–89.
Daniel Khashabi, Sewon Min, Tushar Khot, Ashish Sabharwal, Oyvind Tafjord, Peter Clark, and Hannaneh Hajishirzi. 2020. UnifiedQA: crossing format boundaries with a single qa system. In Proceedings of EMNLP: Findings, pages 1896–1907.
Tushar Khot, Peter Clark, Michal Guerquin, Peter Jansen, and Ashish Sabharwal. 2020. QASC: A dataset for question answering via sentence composition. In Proceedings of AAAI.
Teven Le Scao and Alexander M Rush. 2021. How many data points is a prompt worth? In Proceedings of NAACL-HLT, pages 2627–2636.
Mike Lewis, Yinhan Liu, Naman Goyal, Marjan Ghazvininejad, Abdelrahman Mohamed, Omer Levy, Ves Stoyanov, and Luke Zettlemoyer. 2019. BART: Denoising sequence-to-sequence pretraining for natural language generation, translation, and comprehension. In Proceedings of ACL.
Chin-Yew Lin. 2004. Rouge: A package for automatic evaluation of summaries. In Text summarization branches out, pages 74–81.
Kevin Lin, Oyvind Tafjord, Peter Clark, and Matt Gardner. 2019. Reasoning over paragraph effects in situations. In Proceedings of the 2nd Workshop on Machine Reading for Question Answering, pages 58–62.
Winston Lin, Roman Yangarber, and Ralph Grishman. 2003. Bootstrapped learning of semantic classes from positive and negative examples. In Proceedings of ICML Workshop on The Continuum from Labeled to Unlabeled Data, volume 1, page 21.
Pengfei Liu, Weizhe Yuan, Jinlan Fu, Zhengbao Jiang, Hiroaki Hayashi, and Graham Neubig. 2021. Pretrain, prompt, and predict: A systematic survey of prompting methods in natural language processing. arXiv preprint arXiv:2107.13586.
Yao Lu, Max Bartolo, Alastair Moore, Sebastian Riedel, and Pontus Stenetorp. 2021. Fantastically ordered prompts and where to find them: Overcoming few-shot prompt order sensitivity. arXiv preprint arXiv:2104.08786.
Bryan McCann, Nitish Shirish Keskar, Caiming Xiong, and Richard Socher. 2018. The natural language decathlon: Multitask learning as question answering.
Swaroop Mishra, Arindam Mitra, Neeraj Varshney, Bhavdeep Sachdeva, and Chitta Baral. 2020. Towards question format independent numerical reasoning: A set of prerequisite tasks. arXiv preprint arXiv:2005.08516.
Matthew E Peters, Mark Neumann, Mohit Iyyer, Matt Gardner, Christopher Clark, Kenton Lee, and Luke Zettlemoyer. 2018. Deep contextualized word representations. In Proceedings of NAACL-HLT, pages 2227–2237.
Colin Raffel, Noam Shazeer, Adam Roberts, Katherine Lee, Sharan Narang, Michael Matena, Yanqi Zhou, Wei Li, and Peter J Liu. 2020. Exploring the limits of transfer learning with a unified text-to-text transformer. Journal of Machine Learning Research, 21(140):1–67.
Laria Reynolds and Kyle McDonell. 2021. Prompt programming for large language models: Beyond the few-shot paradigm. In Extended Abstracts of the 2021 CHI Conference on Human Factors in Computing Systems, pages 1–7.
Keisuke Sakaguchi, Ronan Le Bras, Chandra Bhagavatula, and Yejin Choi. 2020. Winogrande: An adversarial winograd schema challenge at scale. In Proceedings of the AAAI.
Victor Sanh, Albert Webson, Colin Raffel, Stephen Bach, Lintang Sutawika, Zaid Alyafeai, Antoine Chaffin, Arnaud Stiegler, Arun Raja, Manan Dey, M Saiful Bari, Canwen Xu, Urmish Thakker, Shanya Sharma Sharma, Eliza Szczechla, Taewoon Kim, Gunjan Chhablani, Nihal Nayak, Debajyoti Datta, Jonathan Chang, Mike Tian-Jian Jiang, Han Wang, Matteo Manica, Sheng Shen, Zheng Xin Yong, Harshit Pandey, Rachel Bawden, Thomas Wang, Trishala Neeraj, Jos Rozen, Abheesht Sharma, Andrea Santilli, Thibault Fevry, Jason Alan Fries, Ryan Teehan, Teven Le Scao, Stella Biderman, Leo Gao, Thomas Wolf, and Alexander M Rush. 2022. Multitask prompted training enables zero-shot task generalization. In Proceedings of ICLR.
Timo Schick and Hinrich Schütze. 2021. Few-shot text generation with natural language instructions. In Proceedings of EMNLP.
Thibault Sellam, Dipanjan Das, and Ankur Parikh. 2020. Bleurt: Learning robust metrics for text generation. In Proceedings of ACL, pages 7881–7892.
Jason Wei, Maarten Bosma, Vincent Zhao, Kelvin Guu, Adams Wei Yu, Brian Lester, Nan Du, Andrew M. Dai, and Quoc V Le. 2022. Finetuned language models are zero-shot learners. In Proceedings of ICLR.
Orion Weller, Nicholas Lourie, Matt Gardner, and Matthew Peters. 2020. Learning from task descriptions. In Proceedings of EMNLP, pages 1361–1375.
Hong Xuan, Abby Stylianou, Xiaotong Liu, and Robert Pless. 2020. Hard negative examples are hard, but useful. In Proceedings of ECCV, pages 126–142. Springer.
Qinyuan Ye, Bill Yuchen Lin, and Xiang Ren. 2021. Crossfit: A few-shot learning challenge for cross-task generalization in nlp. In Proceedings of EMNLP.
Qinyuan Ye and Xiang Ren. 2021. Zero-shot learning by generating task-specific adapters. arXiv preprint arXiv:2101.00420.
Zihao Zhao, Eric Wallace, Shi Feng, Dan Klein, and Sameer Singh. 2021. Calibrate before use: Improving few-shot performance of language models. In Proceedings of ICML, pages 12697–12706.
Ruiqi Zhong, Kristy Lee, Zheng Zhang, and Dan Klein. 2021. Adapting language models for zero-shot learning by meta-tuning on dataset and prompt collections. In Proceedings of EMNLP: Findings, pages 2856–2878.
Ben Zhou, Daniel Khashabi, Qiang Ning, and Dan Roth. 2019. “going on a vacation” takes longer than “going for a walk”: A study of temporal commonsense understanding. In Proceedings of EMNLP-IJCNLP, pages 3354–3360.
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/weixin_44184852/article/details/167127736