

视频怎么快速改成漫画图文?用 ClipSketch AI 做关键帧、角色融合和小红书文案
前言
我做视频转图文时,最烦的不是写几段说明,而是从十几分钟的视频里反复拖进度条、找画面、截图、再把这些图片重新组织成一套能看的内容。真正耗时间的往往不是“有没有 AI”,而是视频里哪些瞬间值得留下、这些关键帧怎么统一成一种画风、最后又怎么变成适合发布的图文。ClipSketch AI 吸引我的地方就在这里:它把关键帧选择、原视频文案分析、图片提示词、角色融合、分镜数量和文案生成放进了同一套页面流程里。这样至少不用在截图工具、绘图工具和文案工具之间反复来回搬素材。
这次我在 Windows 上直接通过 Docker 运行 tannic666/clipsketch-ai:latest,把本地 3000 端口映射出来,再导入视频实际走了一遍操作。和开头那种“自动截取精华”的想象不同,当前实操里关键帧仍然需要自己按 T 键选择;AI 真正接手的是后面的内容分析、画风生成、角色融合、分镜调整和文案生成。最后再安装 cpolar,把 3000 页面映射到公网,并直接配置固定二级子域名。整篇我会把“人工选内容”和“AI 负责生成”的边界写清楚,不把一套半自动工作流包装成全自动一键出片。
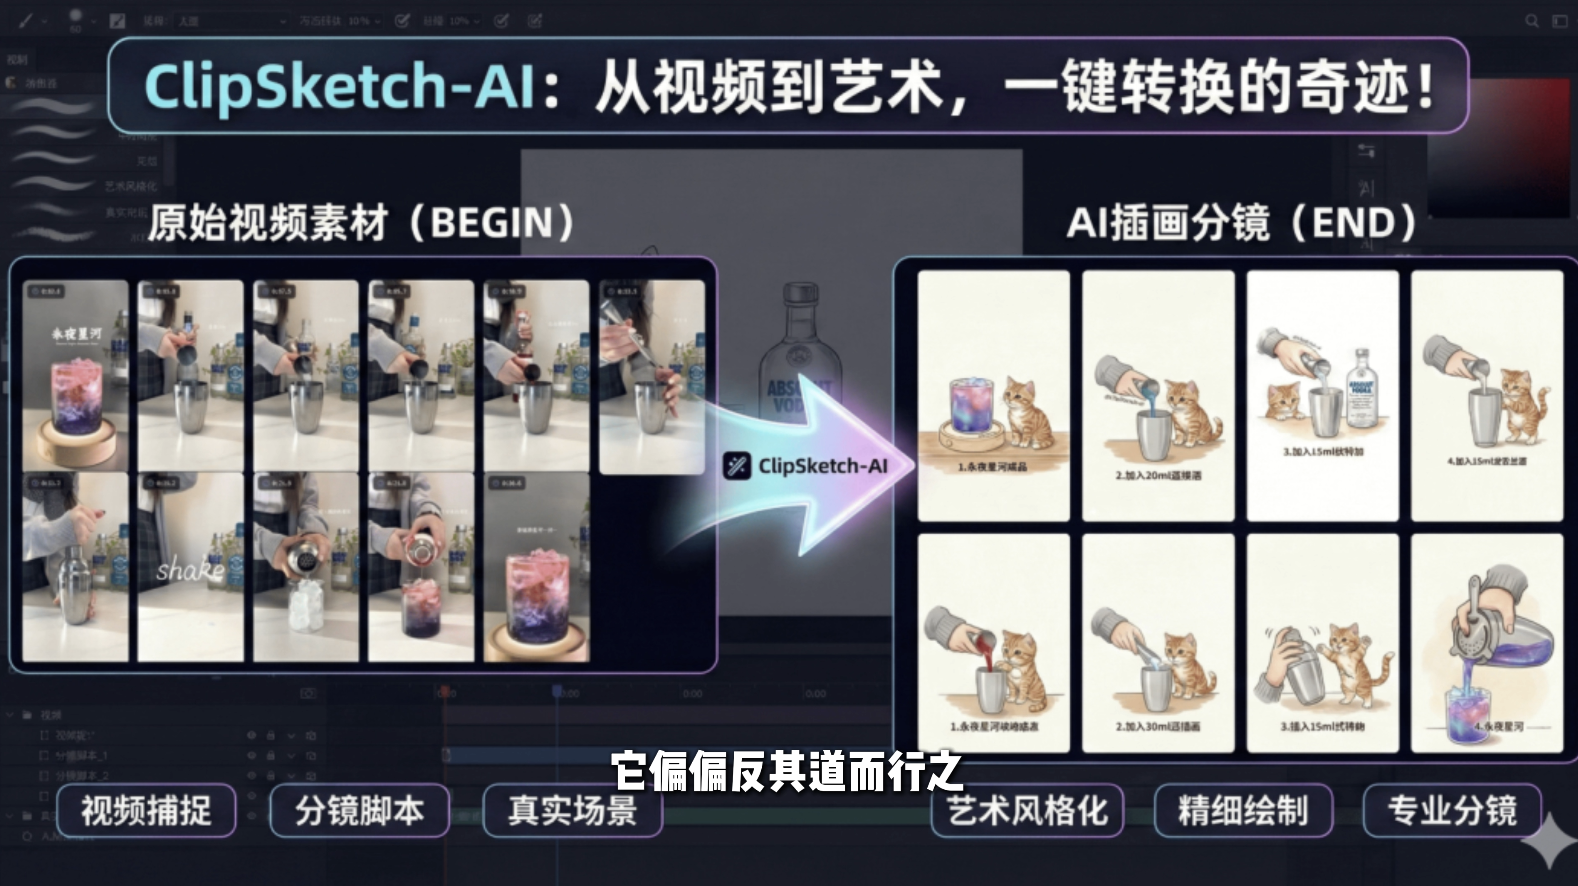
1. ClipSketch AI 真正省下来的,是“视频转图文”的后半程
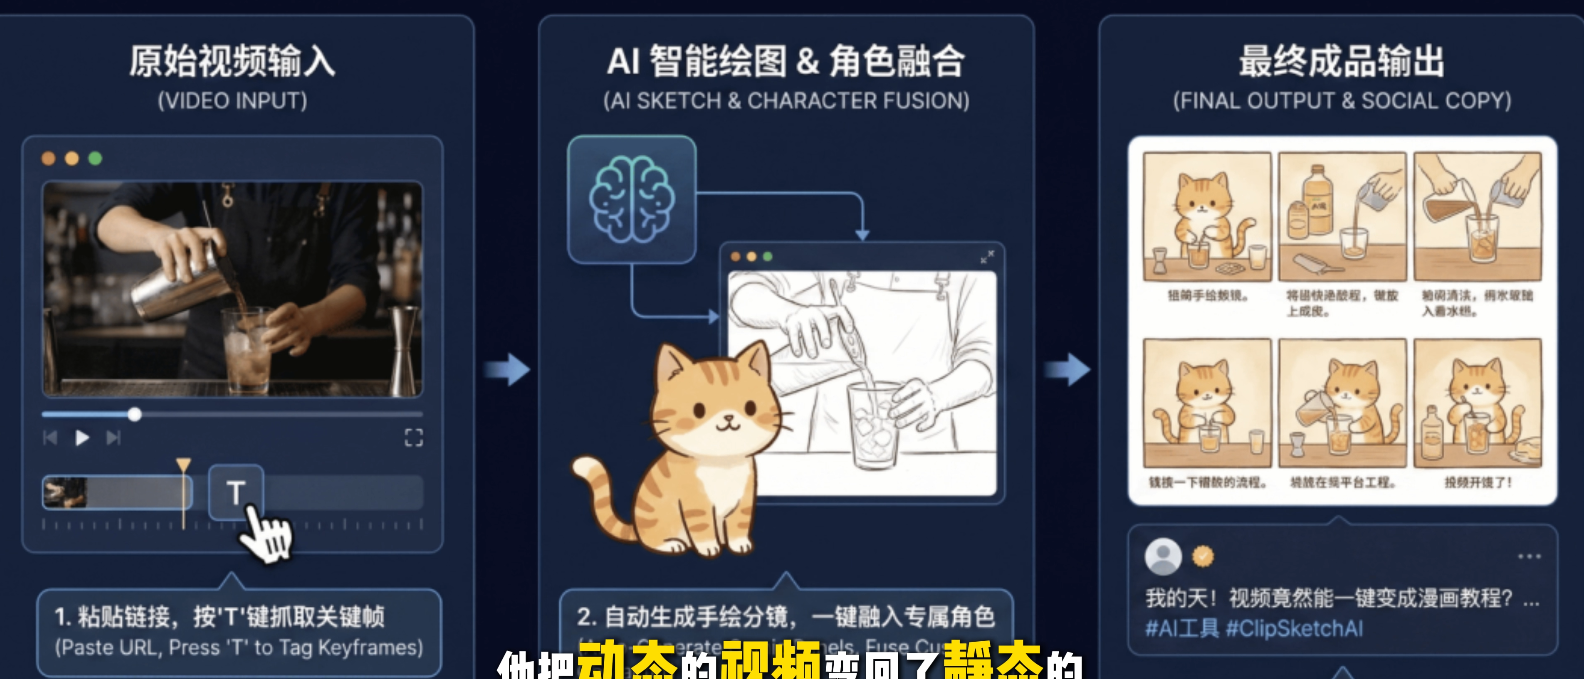
ClipSketch AI 可以把视频内容整理成手绘漫画式故事板。
当前页面流程大致包括:
- 导入视频;
- 手动选择关键帧;
- 分析原视频文案;
- 设置图片提示词和画面比例;
- 生成手绘风格图片;
- 可选角色融合;
- 根据数量调整分镜;
- 生成适合图文发布的文案。
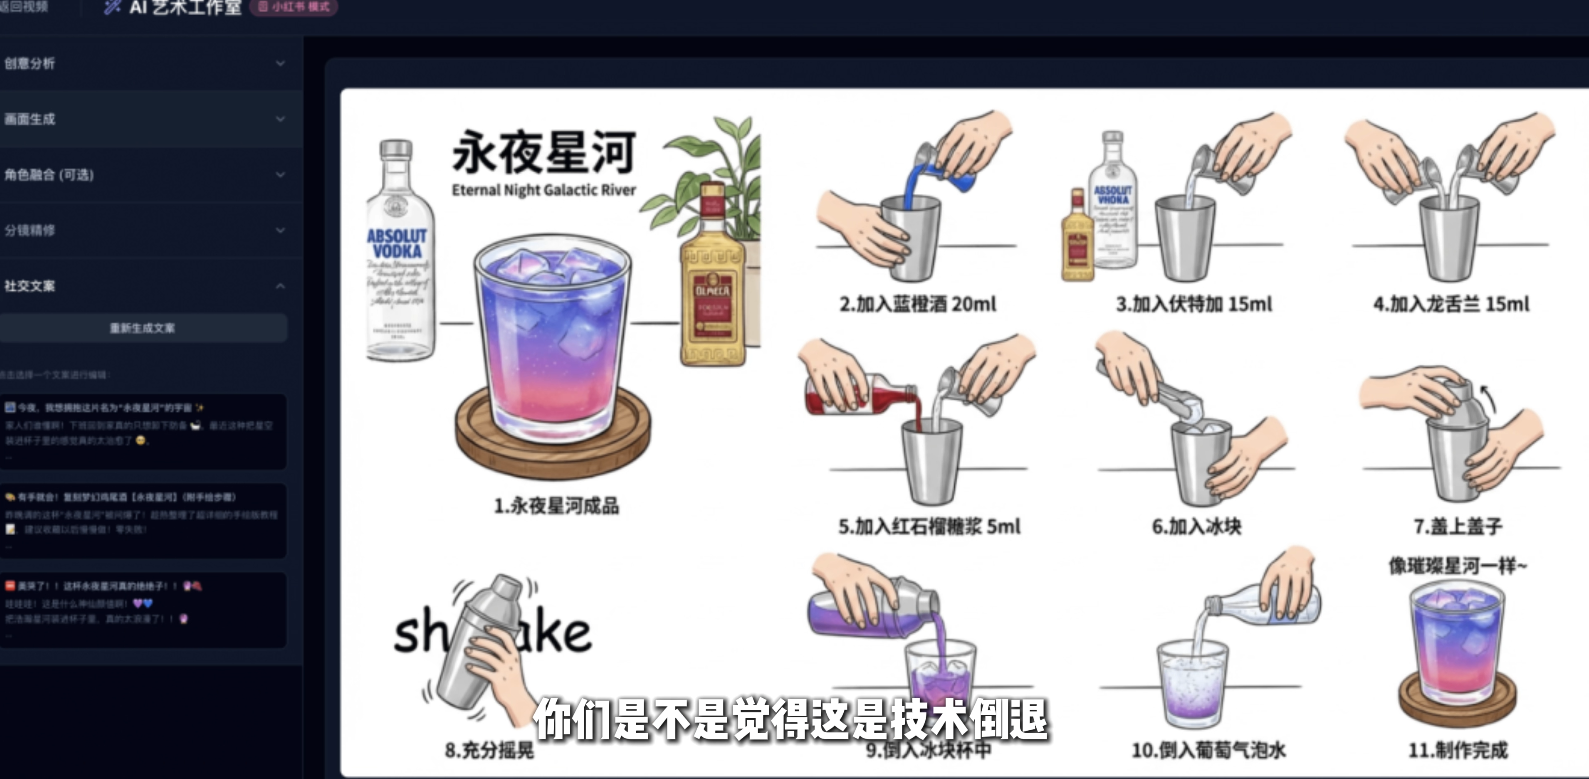
我更愿意把它理解成:
视频素材整理 + AI 图像生成 + 图文重组。
它不是“把十分钟视频完全自动变成一篇成品笔记”。
至少从当前操作来看,决定哪些画面值得留下这一步,还是由人来做。
2. 部署前先准备 Gemini API Key
进入 Gemini API Key 获取页面:
https://aistudio.google.com
创建并保存自己的 API Key。
原始材料里直接展示了一串真实格式的 API Key。出于凭据安全,改写文件不继续复制这串密钥,也不建议把自己的 Key 写进公开教程、截图或仓库。
后面真正需要做的是:
在 ClipSketch AI 页面里填入你自己创建的 Gemini API Key。
如果曾经把真实 Key 公开发布过,更适合先去对应平台重新生成并替换旧 Key。
3. Windows 上用 Docker 一条命令启动
打开终端执行:
docker run -d -p 3000:3000 --name clipsketch-ai tannic666/clipsketch-ai:latest
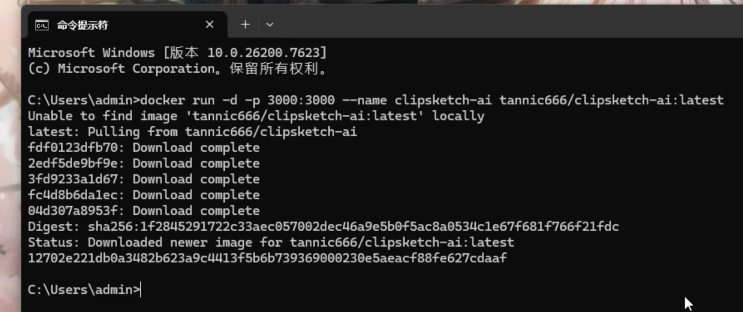
这里的关键参数很简单:
- 容器名:
clipsketch-ai - 镜像:
tannic666/clipsketch-ai:latest - 宿主机端口:
3000 - 容器端口:
3000
容器启动以后,浏览器访问:
localhost:3000
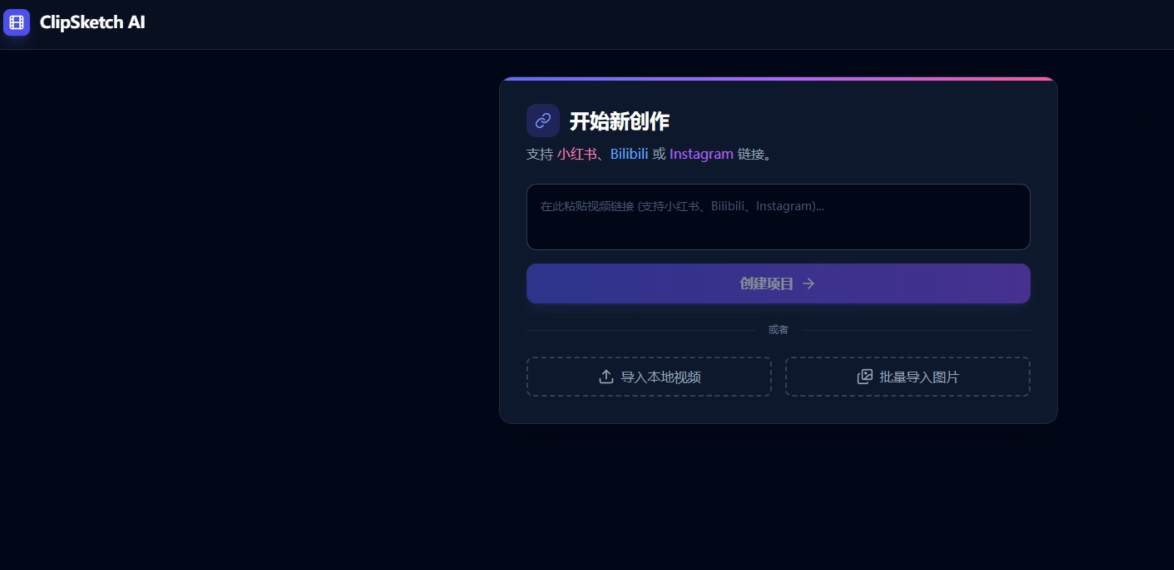
到这里先确认:
Windows Docker → ClipSketch AI → 3000:3000 → 本地浏览器
这一层已经正常。
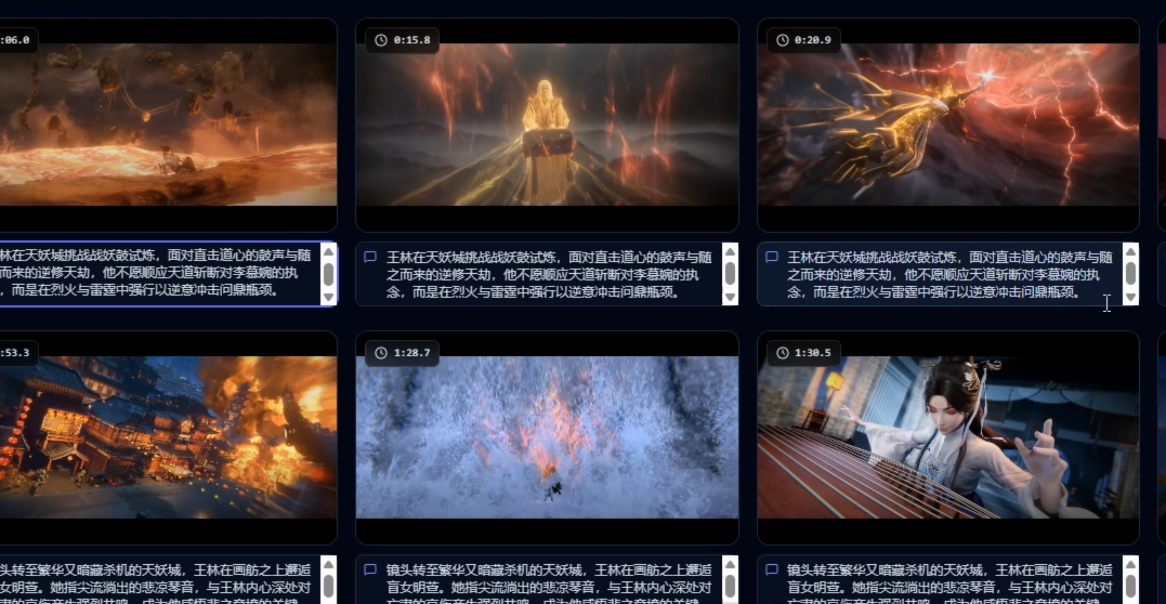
4. 导入视频后,关键帧并不是全自动选出来的
先导入一个视频。
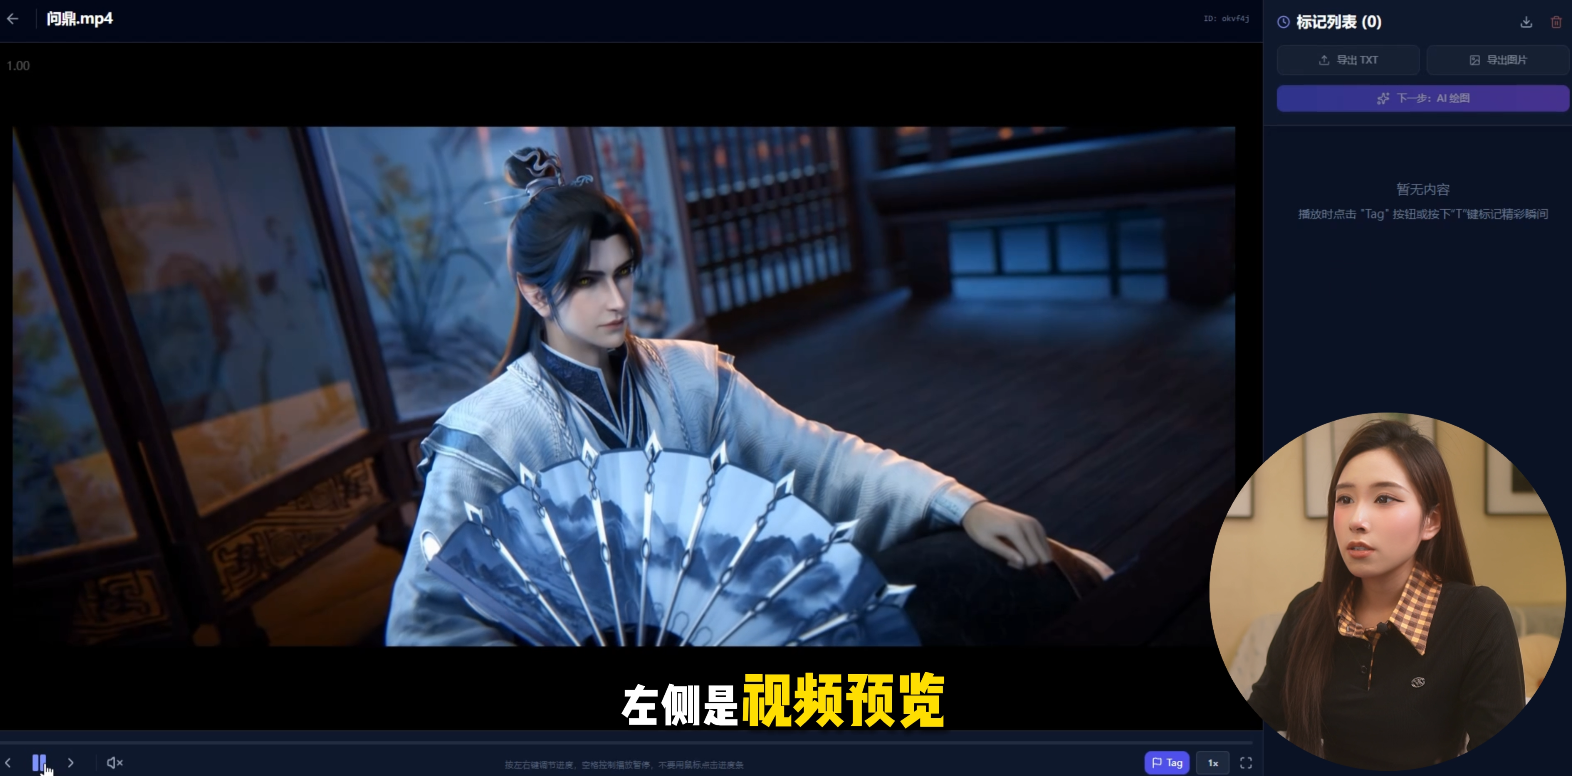
加载成功以后,左侧显示视频预览,右侧显示已经截取的关键帧。
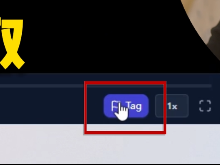
当前实操里,关键帧需要自己选择。
比如想保留当前这一帧,就按:
T
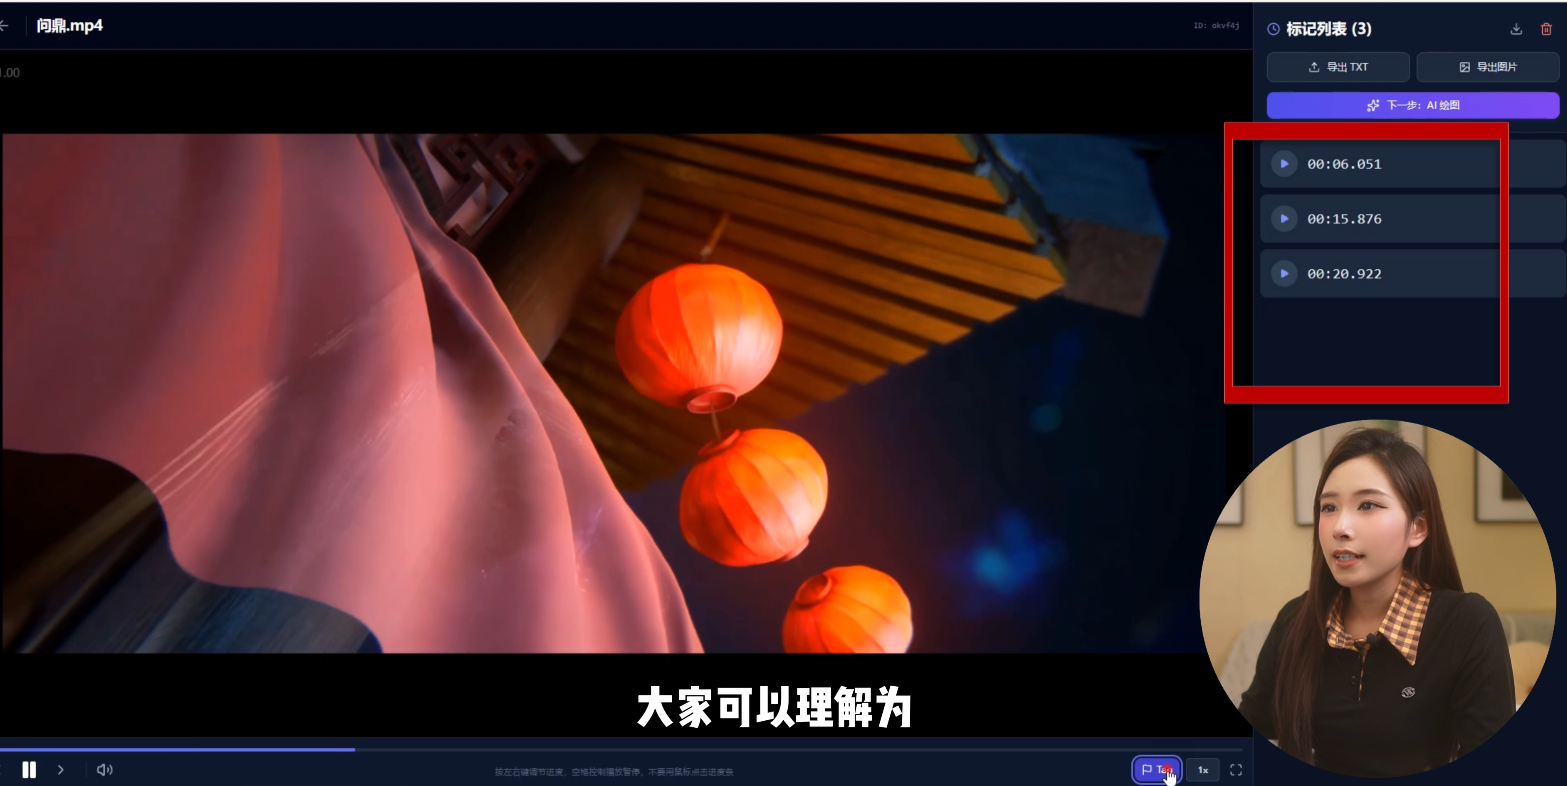
每一个被保留的关键帧,后面都会对应生成一张图片。
所以这一段真正需要自己判断的是:
哪些画面最能代表视频里的关键步骤。
这也是整套工具里我最不愿意完全交给 AI 的部分。
因为如果关键帧本身选错了,后面画得再漂亮,故事顺序也会偏。
5. 关键帧选完,再进入 AI 绘图
把需要的画面全部标记以后,点击右上角的 AI 绘图入口。
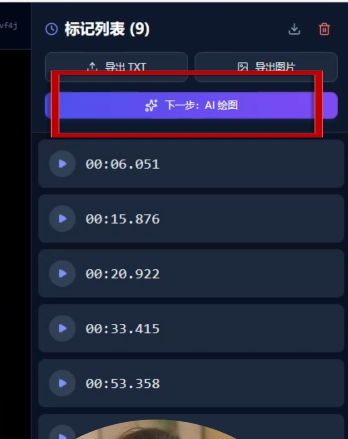
进入下一页以后,可以看到刚才选择的所有关键帧。
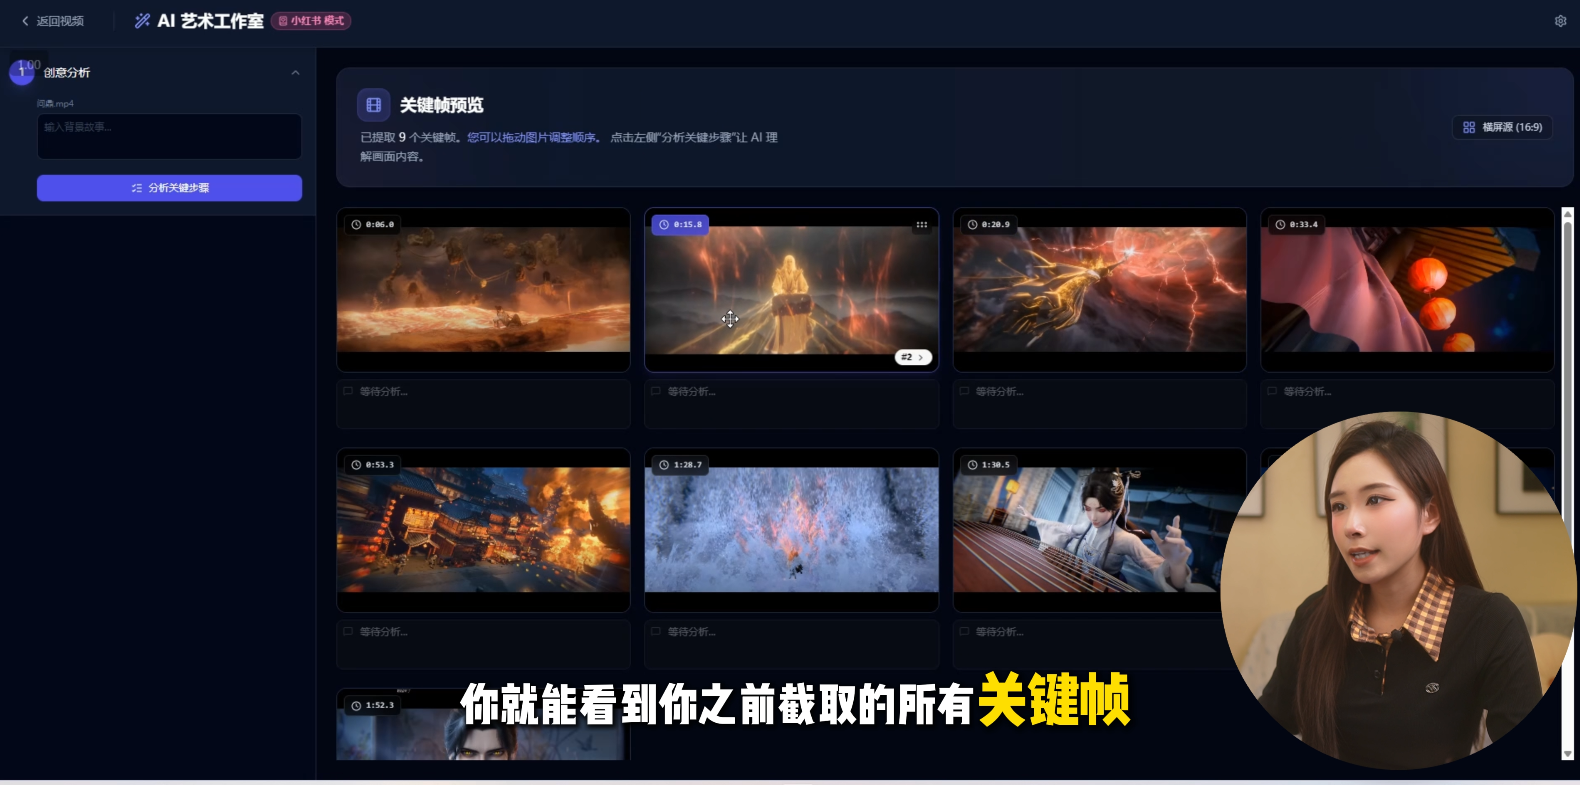
这一步开始,AI 的参与会明显变多。
6. 填入自己的 Gemini API Key
右上角填入前面准备好的 Gemini API Key。
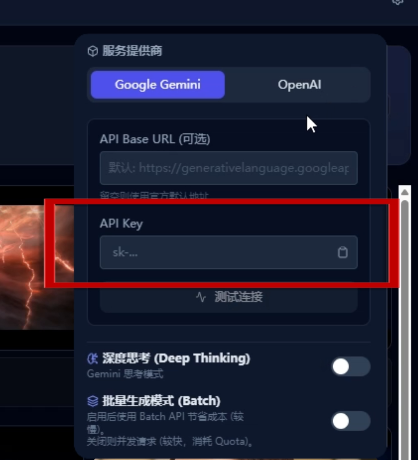
这里不要继续使用公开文章、截图或者别人分享出来的密钥。
API Key 本质上属于访问凭据。
真正长期使用时,更适合自己申请、自己保管,并在怀疑泄露时及时轮换。
7. 第一步:先让工具理解原视频内容
提交以后,工具会开始分析刚才选择的视频片段。
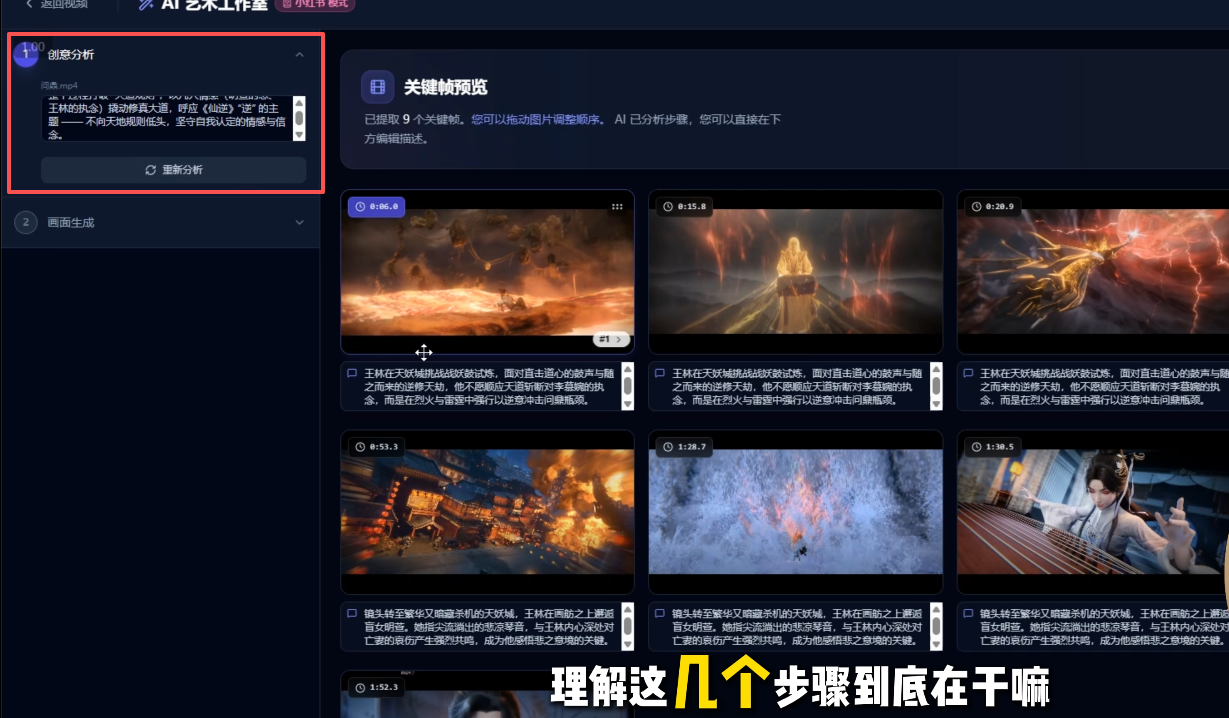
页面左侧首先处理原视频文案。
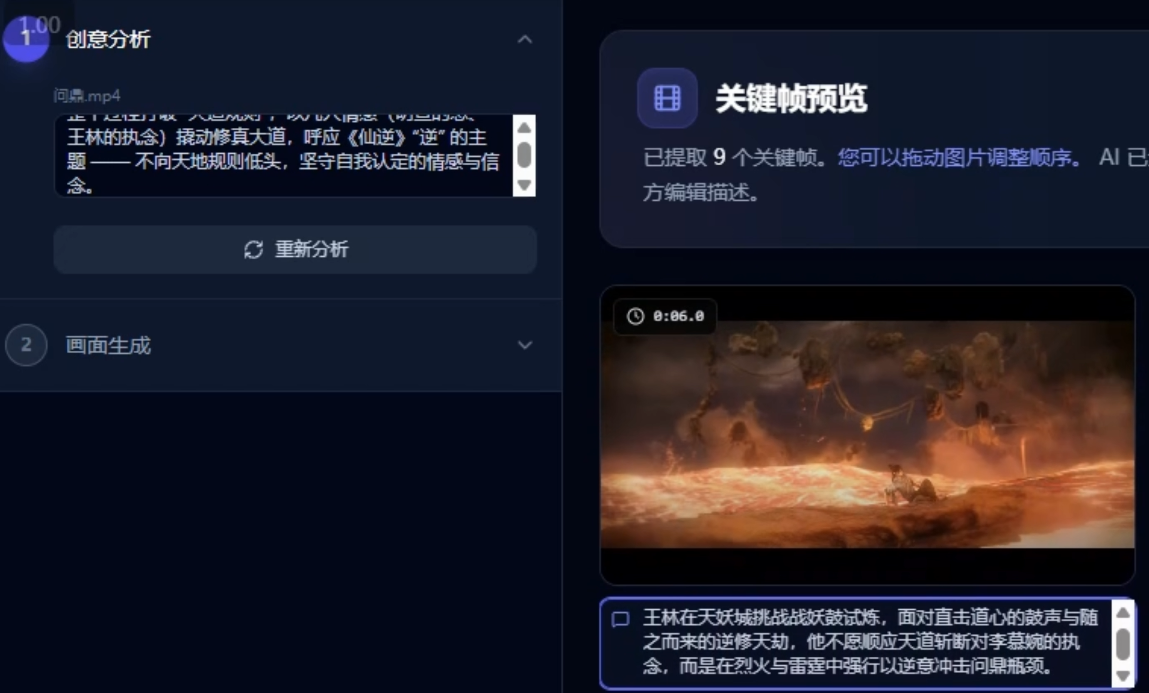
这段文案由工具从原视频中获取,用来帮助后续理解:
这段视频到底在讲什么。
如果自动获取出来的文本和实际内容有偏差,也可以自己修改。
我会把这一步当成后续图片生成的“语义底稿”。
关键帧决定画面里要出现什么,文案分析帮助 AI 理解这些画面之间是什么关系。
8. 第二步:用提示词决定最终画风
下一步是图片提示词。
关键帧解决的是:
画什么。
提示词解决的是:
怎么画。
当前工具已经提供了一套默认提示词。
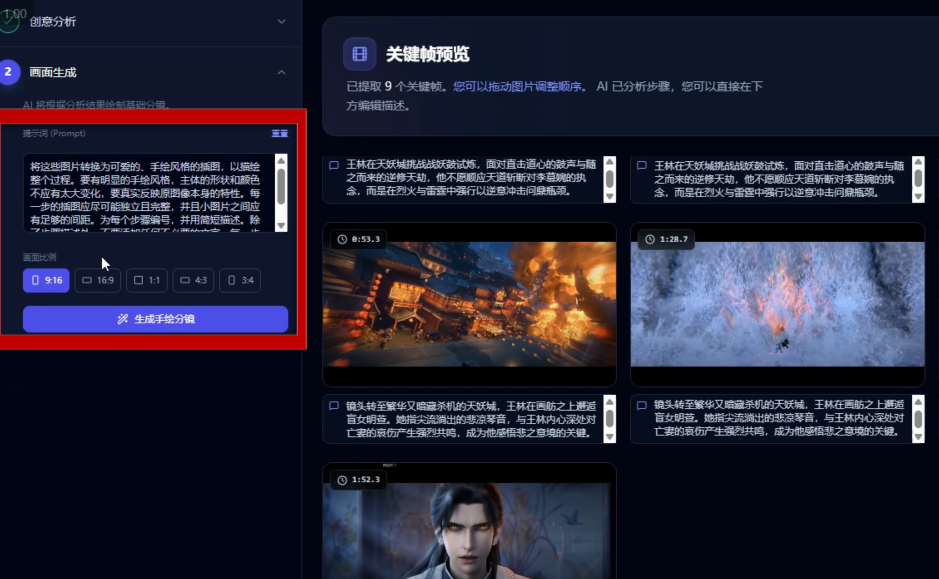
如果想换风格,也可以自己调整提示词,并选择画面比例。
点击生成以后,图片会显示在右侧。
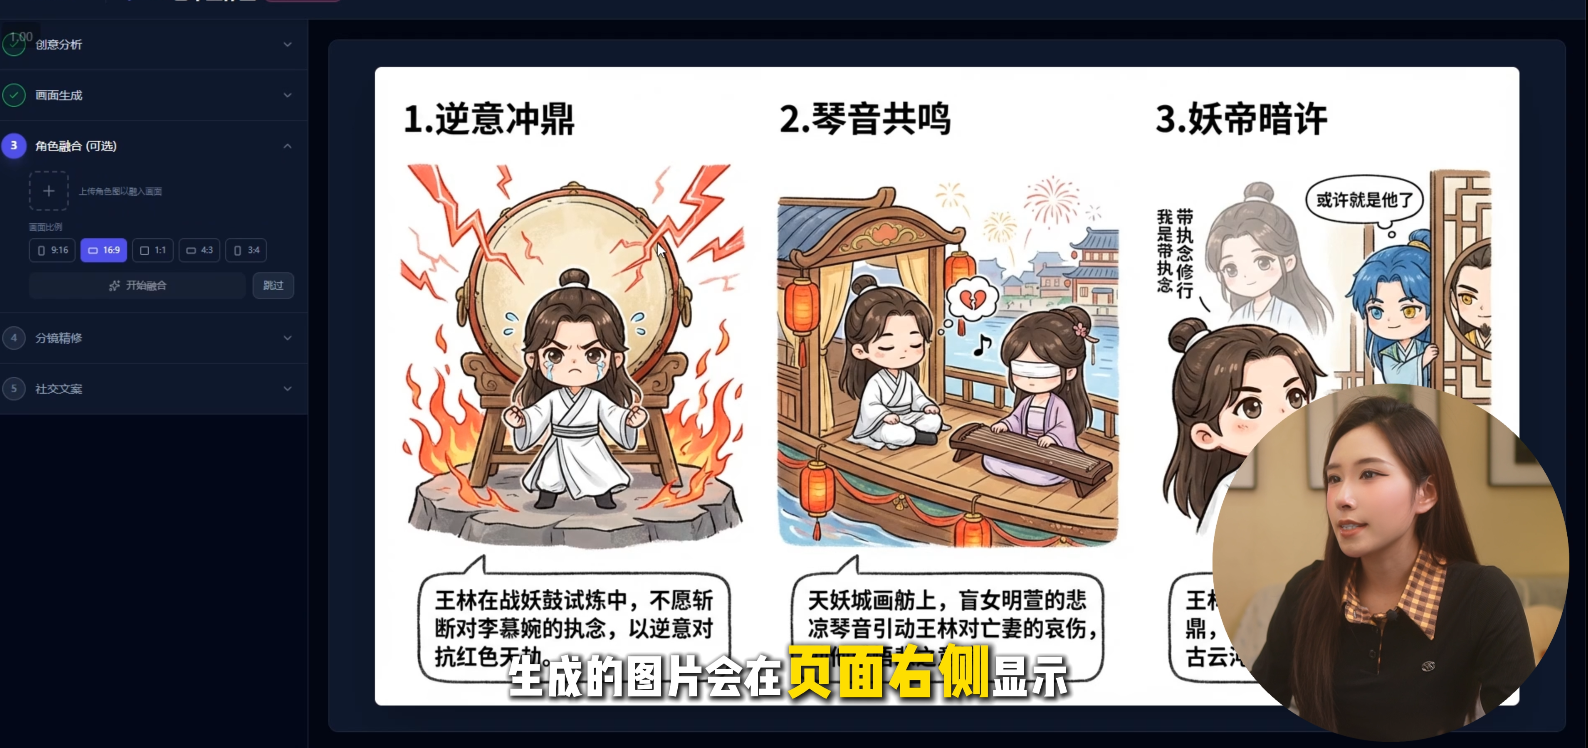
所以“手绘漫画”只是当前默认效果方向之一。
真正想做长期账号,更值得固定自己的画风,而不是每条视频都随机换一种视觉。
9. 第三步:需要固定 IP 形象时再做角色融合
页面还支持上传固定角色形象。
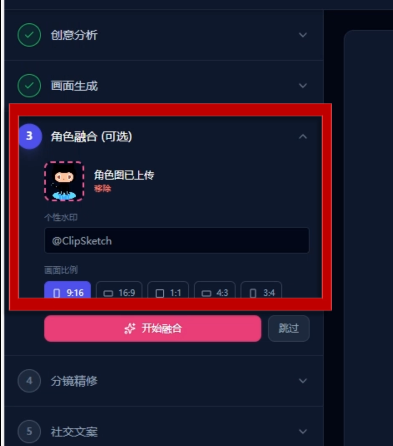
当前示例思路包括:
- 小猫;
- 虚拟形象;
- 真人形象;
- 其他品牌角色。
生成以后,AI 会尝试把角色融合到画面里,并根据场景调整动作和表情。
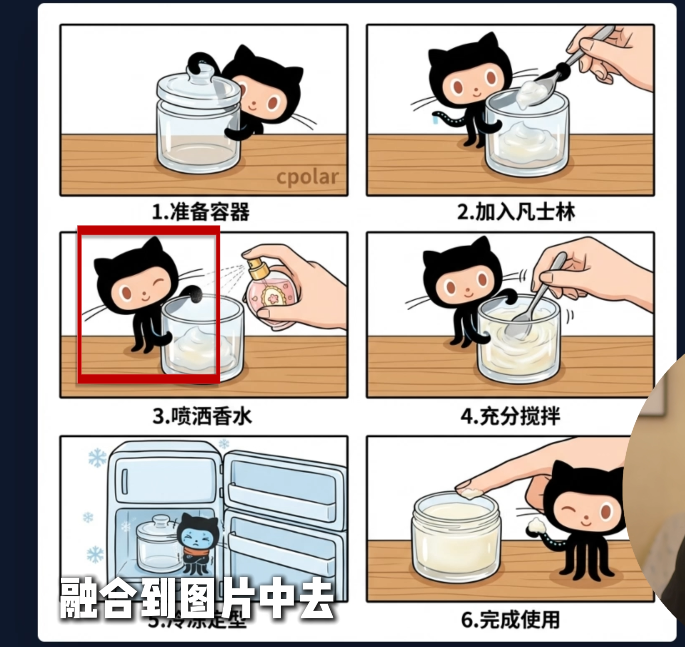
这一功能更适合长期做固定账号形象的人。
如果只是把教程视频整理成图文,不需要人物统一,可以直接跳过。
如果上传的是现实人物照片,也更适合使用本人或已经获得授权的素材。
10. 第四步:按最终需要调整分镜数量
接下来是分镜修饰。
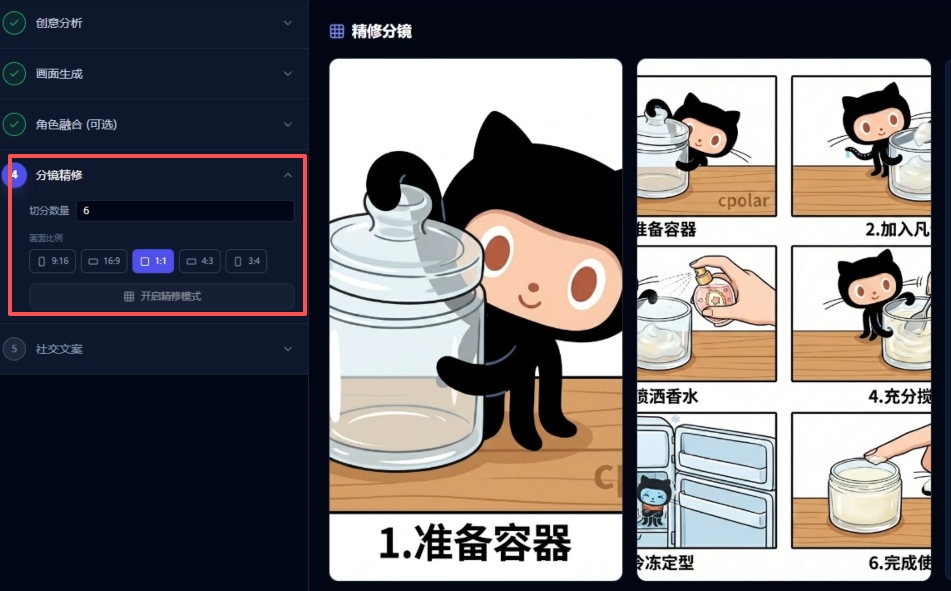
这里可以根据:
- 前面截取的关键帧数量;
- 最终想要的图片数量;
决定最后输出几张图。
系统会根据数量对步骤进行合并或扩展。
这一层很适合把原本零散的多个关键帧,重新整理成适合图文阅读的节奏。
但图片数量越少,步骤合并就越明显。
所以如果视频本身是强教程型内容,我不会只追求“图少看着干净”,还会确认关键步骤有没有因为合并而丢掉。
11. 最后一步:让 AI 生成图文文案
除了图片,页面还提供文案生成。
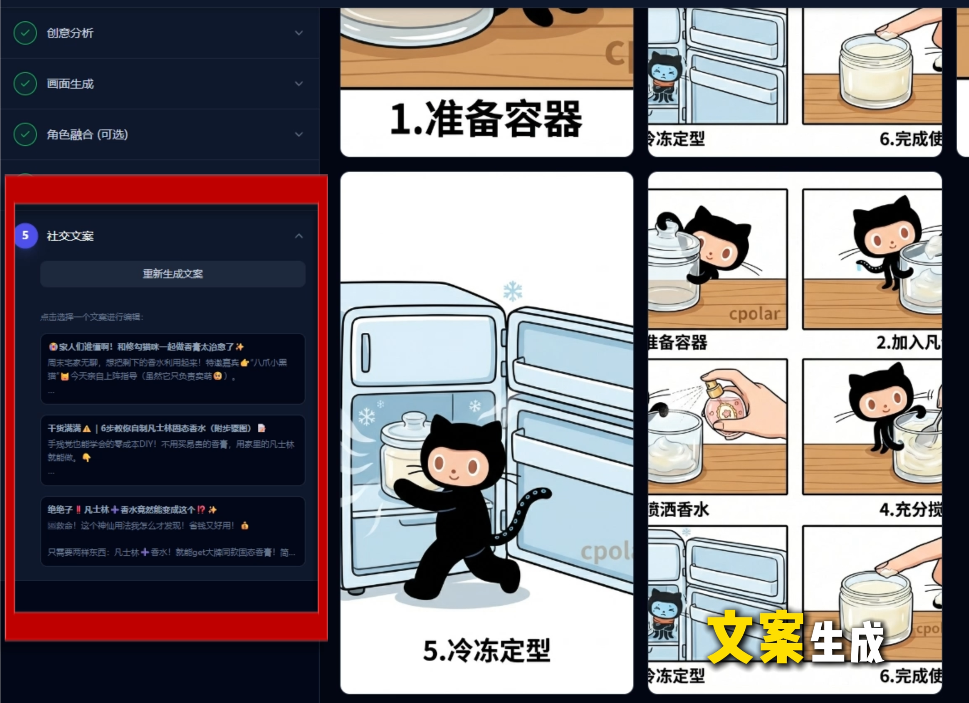
当前说明里会根据主题和小红书这类平台的内容风格生成不同方向的文案,例如:
- 详细攻略型;
- 偏情绪表达的短文案;
- 其他适合图文发布的表达方式。
我会把它当成第一稿,而不是直接复制发布。
尤其技术教程、产品参数、操作步骤这类内容,最终还是要自己核对一次事实和顺序。
12. 最终页面可以把图片整理成封面效果
生成完成以后,页面可以看到组合后的效果。
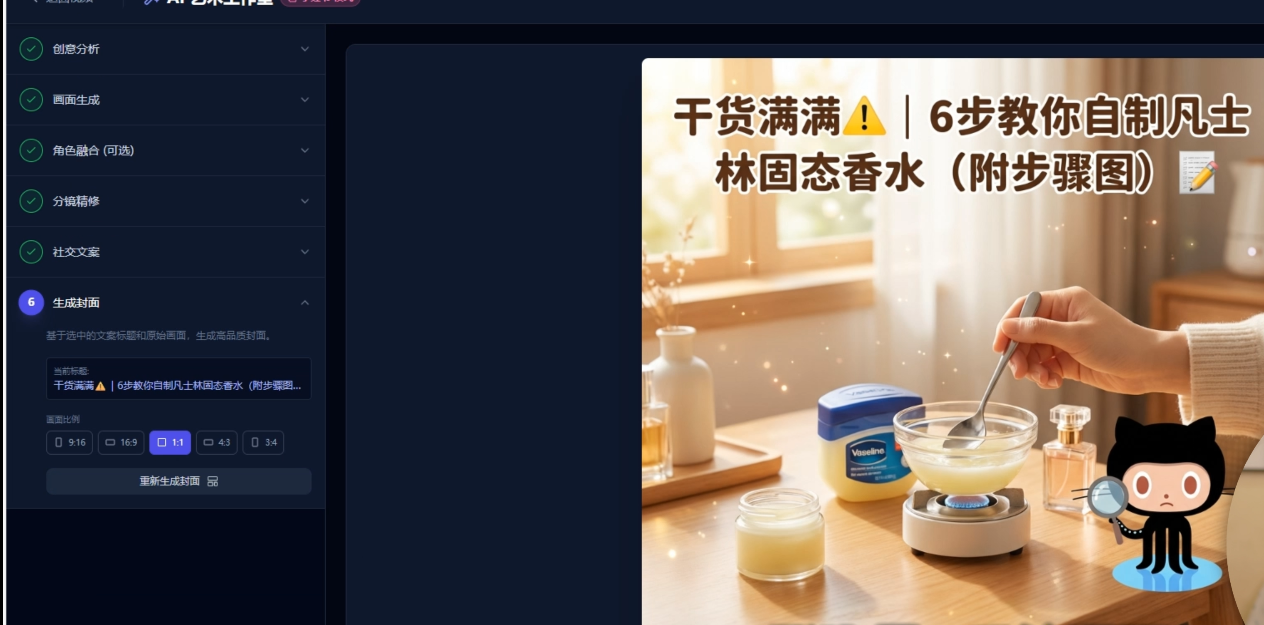
当前示例是手绘漫画式封面。
这一步真正让我觉得省时间的,不是“AI 替我做完了所有创作”,而是:
我只负责挑关键内容,后面的统一画风、角色处理、图片数量和文案初稿可以集中在一个流程里完成。
这比单独截图、单独跑绘图、再单独写文案更顺。
13. 本地能用以后,再解决外出怎么打开
当前 ClipSketch AI 运行在:
localhost:3000
本机使用没问题。
但人在外面时,这个地址不能直接打开。
这里再加入 cpolar。
cpolar 在这套方案里负责:
把已经运行在
3000的 ClipSketch AI Web 页面提供到公网。
它不负责关键帧选择、Gemini 分析、AI 绘图、角色融合或文案生成。
14. Windows 安装 cpolar
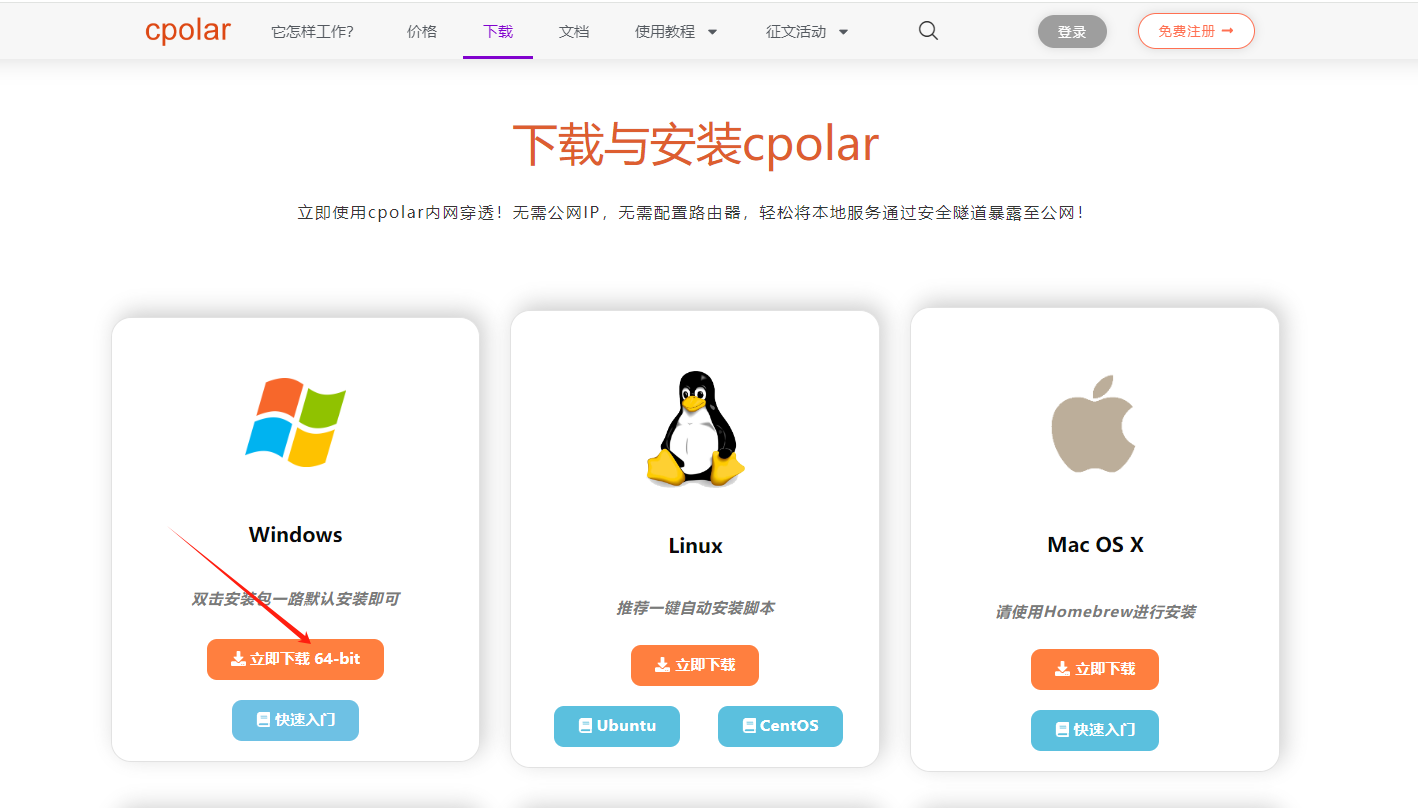
进入 cpolar 官网注册账号并下载 Windows 客户端。
安装时按当前流程使用 Windows 版本。
安装完成后,在浏览器访问:
http://localhost:9200
进入 cpolar Web 管理页面。
登录以后开始配置 ClipSketch AI 的公网入口。
15. 这次直接按长期使用配置二级子域名
进入:
隧道管理 → 创建隧道
当前参数为:
- 隧道名称:自定义
- 协议:
http - 本地地址:
3000 - 域名类型:二级子域名
- 地区:
China Top
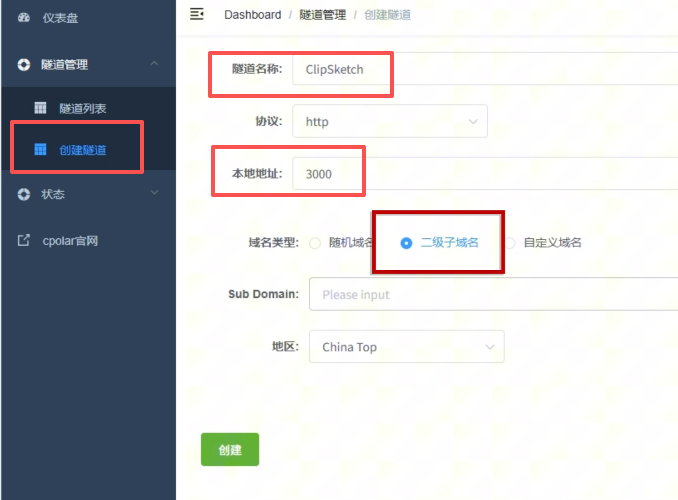
这次目标就是长期使用,所以没有先创建随机域名。
如果只是临时测试,也可以选择随机隧道。
16. 先预留二级子域名
登录 cpolar 官网,进入预留页面。
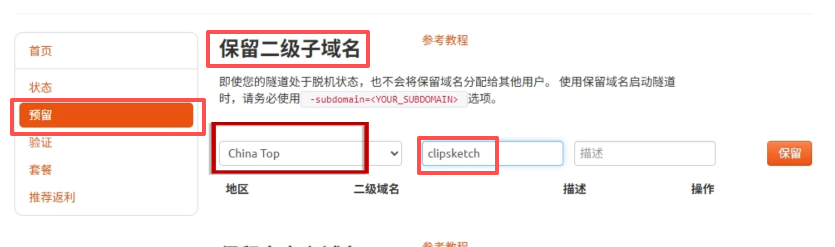
选择:
保留二级子域名
参数为:
- 地区:
china top - 名称:自定义
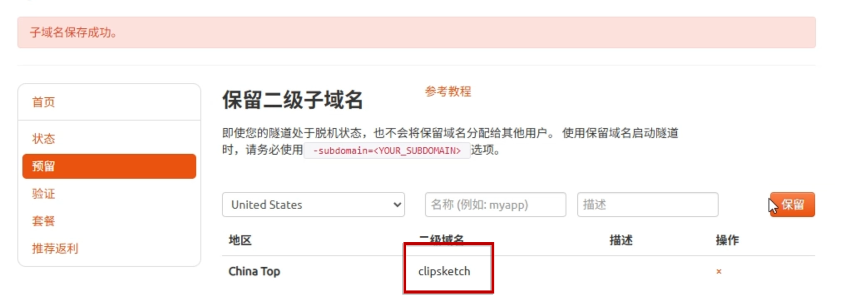
预留成功以后,把这个子域名复制下来。
17. 把固定域名绑定回 ClipSketch AI 隧道
回到 cpolar 本地配置页面。
把刚才保留的子域名填到域名位置,然后创建。
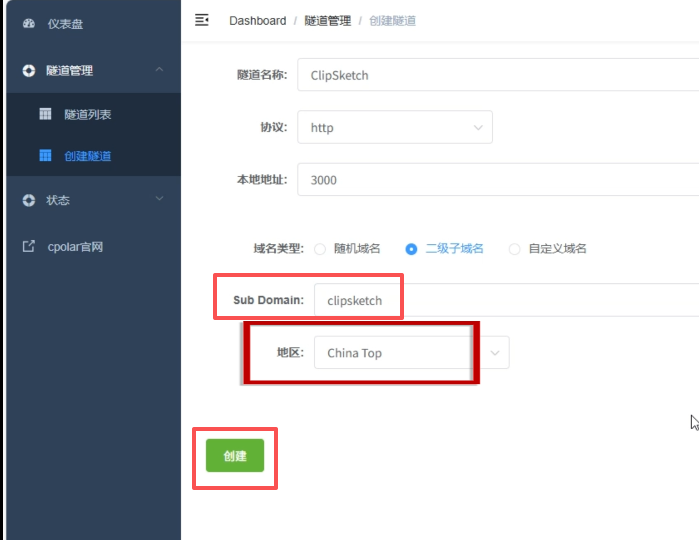
创建成功以后,在线隧道列表会显示两个公网地址。
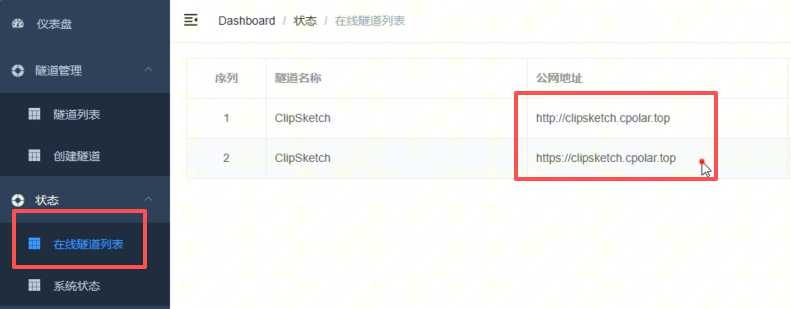
复制其中一个地址,从其他电脑或移动设备打开。
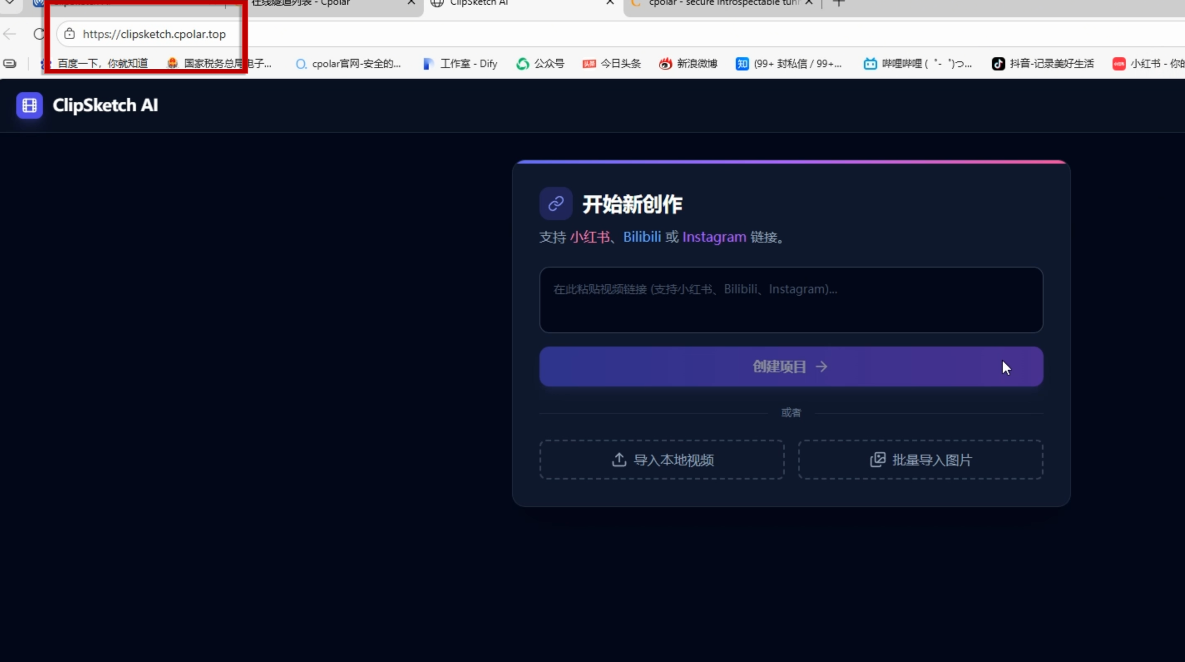
ClipSketch AI 页面能够正常访问。
这一层真正验证的是:
外部浏览器 → cpolar 固定公网地址 → Windows 3000 → ClipSketch AI Web。
18. 公网分享时,比“能打开”更值得注意的是 API Key
ClipSketch AI 页面本身需要使用 Gemini API Key。
这意味着一旦把整个应用直接开放到公网,真正需要关注的就不只是“页面能不能访问”。
还要考虑:
- 页面是否允许别人看到或使用你的 Key;
- 是否会产生 API 调用额度或费用;
- 是否只分享给可信设备和人员;
- 上传的视频、图片和人物素材是否有授权;
- 使用第三方视频做二次创作时是否符合平台和版权规则。
所以我不会把固定公网地址当成一个可以随便公开发布的体验站。
更适合的做法是:
自己使用,或者只分享给明确知道用途的人。
总结
这次真正跑通的主线是:
Windows → Docker → tannic666/clipsketch-ai:latest → 3000:3000 → ClipSketch AI → 导入视频 → 手动按 T 选择关键帧 → Gemini API Key → 原视频文案分析 → 图片提示词 → 画风生成 → 角色融合 → 分镜数量 → 文案生成 → cpolar Windows 客户端 → localhost:9200 → 本地 3000 → China Top → 固定二级子域名 → 外部浏览器访问。
几个边界需要继续留意:
- 开头把 ClipSketch AI 描述成“自动截取视频精华”,但当前实际操作里关键帧仍然需要手动按
T选择; - Docker 命令只展示了
3000:3000和容器名,没有额外 volume、环境变量或重启策略; - Gemini API Key 需要自己申请和保管,原始材料里展示的实际密钥没有继续写入改写文件;
- AI 会参与文案分析、图像生成、角色融合、分镜整理和文案初稿,但关键内容选择仍然由人决定;
- cpolar 只负责 ClipSketch AI Web 页面的公网入口,不参与 Gemini 调用和图像生成;
- 当前远程流程直接配置固定二级子域名,没有先走随机域名;
- 如果把应用开放到公网,需要额外注意 API Key、调用额度、人物素材授权以及第三方视频二创边界。
对我来说,ClipSketch AI 最值得用的地方不是“一键把视频变漫画”这句宣传,而是它把原本散落在截图、AI 绘图、角色统一和文案生成几个工具之间的流程收进了同一个页面。我仍然要负责挑内容,但后面那些重复加工,确实可以交给 AI 多做一点。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/weixin_42878111/article/details/166592883