

数据库专题01:数据库到底解决什么问题——用博客项目认识“可靠保存数据”
很多初学者把数据库理解成“一个比 Excel 快的文件夹”。这个比喻只能解释一小部分:真正的数据库还要处理并发写入、断电恢复、权限、查询效率和数据之间的约束。本专题不从背诵 SQL 开始,而是围绕一个博客平台逐步搭建 PostgreSQL、Redis、MongoDB 三种存储,让每一条设计都对应一个真实需求。
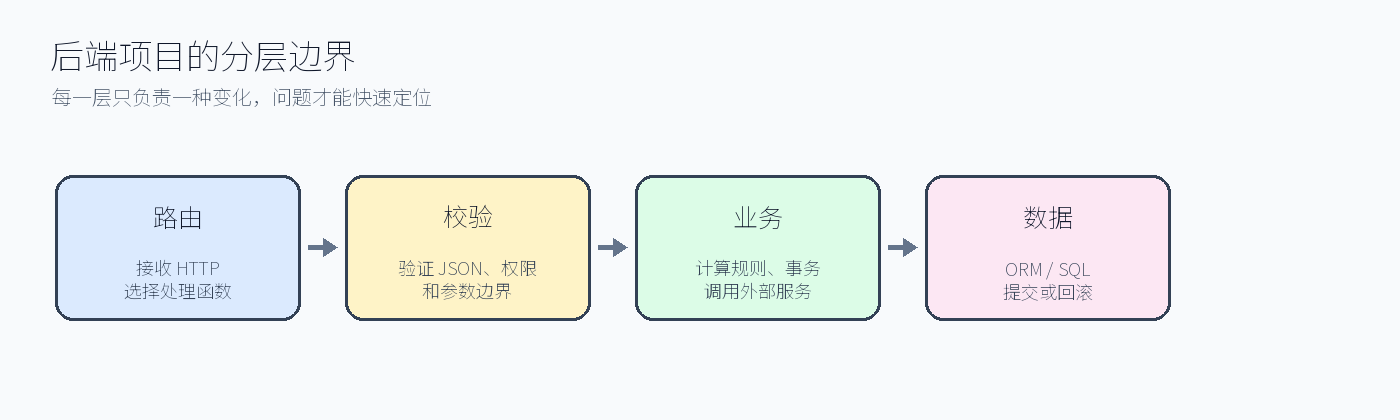
先看没有数据库的版本
假设我们把文章写入 articles.json:
import json

def add_article(title: str, content: str) -> None:
    """读取整个 JSON 文件、追加一篇文章、再覆盖写回。"""
    with open("articles.json", "r", encoding="utf-8") as file:
        rows = json.load(file)
    rows.append({"title": title, "content": content})
    with open("articles.json", "w", encoding="utf-8") as file:
        json.dump(rows, file, ensure_ascii=False)
单人练习可以运行,但两个请求同时读取旧文件时,后写入的请求会覆盖前一个请求;程序写到一半突然断电,JSON 可能只剩半截;想查“某作者最近 20 篇已发布文章”,只能遍历全部文件。数据库的价值,就是把这些通用且容易出错的工作交给经过验证的引擎。
本项目要保存哪些事实
第一版博客只需要五种事实:用户、文章、标签、评论、点赞。用户和文章是一对多关系,文章和标签是多对多关系,点赞需要保证同一个用户不能重复点同一篇文章。后续还会增加 outbox、版本和审计,但核心事实先放 PostgreSQL。
users 1 ─── N articles 1 ─── N comments
              │
              N
              │ article_tags N ─── 1 tags
users N ─────── likes ─────── N articles
这里有两个关键判断:文章正文是“事实”,不能只放 Redis;文章版本是历史快照,适合 MongoDB 文档;热点计数是可重建的派生数据,可以放 Redis 后批量落库。
用 Docker 启动第一台数据库
在项目目录执行:
cd work/course_v2/projects/database-platform
docker compose up -d postgres
docker compose ps
docker compose exec postgres pg_isready -U blog -d blog
pg_isready 输出 accepting connections 才表示 PostgreSQL 已经就绪。docker compose up 只负责启动进程,不等于初始化脚本执行成功;后续文章会单独讲 schema 和迁移。
第一个 SQL:确认“事实”能被保存
create table if not exists demo_notes (
    id bigserial primary key,
    body text not null,
    created_at timestamptz not null default now()
);

insert into demo_notes(body) values ('数据库会在事务提交后保存事实');
select id, body, created_at from demo_notes order by id desc limit 1;
预期能看到一行带时间戳的记录。primary key 让每行有稳定身份,not null 防止“没有正文”的无效数据。不要把所有约束都寄托在 Python if 判断上:脚本、管理后台和未来的另一个服务都可能写数据库。
什么时候用哪一种数据库
PostgreSQL 是博客主库:需要事务、外键、聚合和复杂筛选。Redis 是内存型键值数据库:适合 session、缓存、限流和排行榜,不适合作为唯一事实。MongoDB 是文档数据库:文章版本和审计事件字段变化较快,一次读取整份文档更自然。数据库不是“选一个永久使用”,而是按访问模式分工,并明确谁是最终事实来源。
运行结果与失败排查
postgres container: running/healthy
pg_isready: /var/run/postgresql:5432 - accepting connections
demo_notes 查询:1 | 数据库会在事务提交后保存事实 | 2025-...
如果连接被拒绝,先执行 docker compose logs postgres,确认端口没有被其他 PostgreSQL 占用;如果用户不存在,使用 Compose 文件中的账号,而不是凭感觉输入 postgres。停止容器后再启动,demo_notes 仍存在,说明数据卷在工作;若数据消失,检查是否误用了 docker compose down -v。
本篇验收记录
完成以下命令并把输出保存到学习笔记:
docker compose ps
docker compose exec postgres pg_isready -U blog -d blog
docker compose exec postgres psql -U blog -d blog -c "select count(*) from demo_notes;"
三条命令均成功、重启后计数不变,即可进入下一篇。第一篇没有“上一篇练习讲解”,因为它是整个数据库专题的起点。
用一个事务看“要么全成功,要么全失败”
数据库的另一个价值是把多步操作组成原子单元。下面的实验同时插入一条文章和一个不存在的作者,第二步触发外键错误,第一步也会回滚:
begin;
insert into articles(author_id,title,content) values (999999,'不会留下','测试');
commit;
-- ERROR: insert or update on table "articles" violates foreign key constraint
rollback;
select count(*) from articles where title='不会留下'; -- 0
应用层不要把错误 SQL 忽略后继续返回 200;事务失败后连接处于 aborted 状态,必须回滚或退出上下文。后续的注册、发布和点赞都会重复这个模式。
本专题的学习路线
接下来先用 Docker 建立可复现环境,再学习表结构和 SQL;随后把查询放进 Repository/Service,加入索引、并发控制和迁移;最后把 PostgreSQL、Redis、MongoDB 串成一个可备份、可恢复的博客项目。每篇文章都会留下一个能在下一篇使用的练习,而不是孤立的语法清单。
课后检查清单
[ ] 能解释 JSON 文件在并发写入和断电时的风险
[ ] 能启动 PostgreSQL、执行 select 1 并查看日志
[ ] 能说清主库、缓存和历史文档各自保存什么
[ ] 能用事务验证失败步骤不会留下半条数据
课后练习
- 用 JSON 文件模拟两次并发写入,观察后一条是否覆盖前一条。
- 在 PostgreSQL 中为
demo_notes增加author_id,思考为什么应该引用用户表而不是直接保存用户名。 - 记录一次容器停止、恢复和查询结果。
下一篇会创建可重复的 Docker 数据库环境,并解释数据卷、健康检查和初始化脚本的区别。
转载自 CSDN-专业IT技术社区
原文链接:https://blog.csdn.net/a1250467048/article/details/163821586